2026.09.28
AI代理人記憶怎麼設計?打造可靠 AI 工作流程的實戰指南
AI資訊
AI代理人記憶不是把聊天紀錄全部塞回模型,而是讓 AI Agent 在正確時機取回可信資訊、忽略過期內容,並把任務經驗轉成下一次可用的判斷依據。若缺乏這一層,代理人即使模型能力強,也容易在跨部門流程中重複提問、遺忘偏好或執行錯誤工具操作。
大型語言模型本身沒有跨工作階段的持久記憶;它每次回應都依賴當下收到的上下文。因此,企業在導入客服、採購、知識查詢或程式開發代理時,必須額外設計狀態、知識、事件紀錄與權限邊界。記憶設計不佳不只提高 Token 成本,更可能讓過期規則、敏感資料或惡意提示被錯誤帶入新任務。
本文以可落地的角度說明 AI代理人記憶的定義、類型與讀寫流程,並延伸到 AI Agent、AI代理人框架、AI代理人協作與 AI工作流程。你會學到如何用 RAG、向量資料庫、知識圖譜與人工覆核建立可追溯架構,以及如何透過小規模 PoC 先驗證效益再決定正式開發。
AI代理人記憶是什麼:先分清上下文、狀態與知識
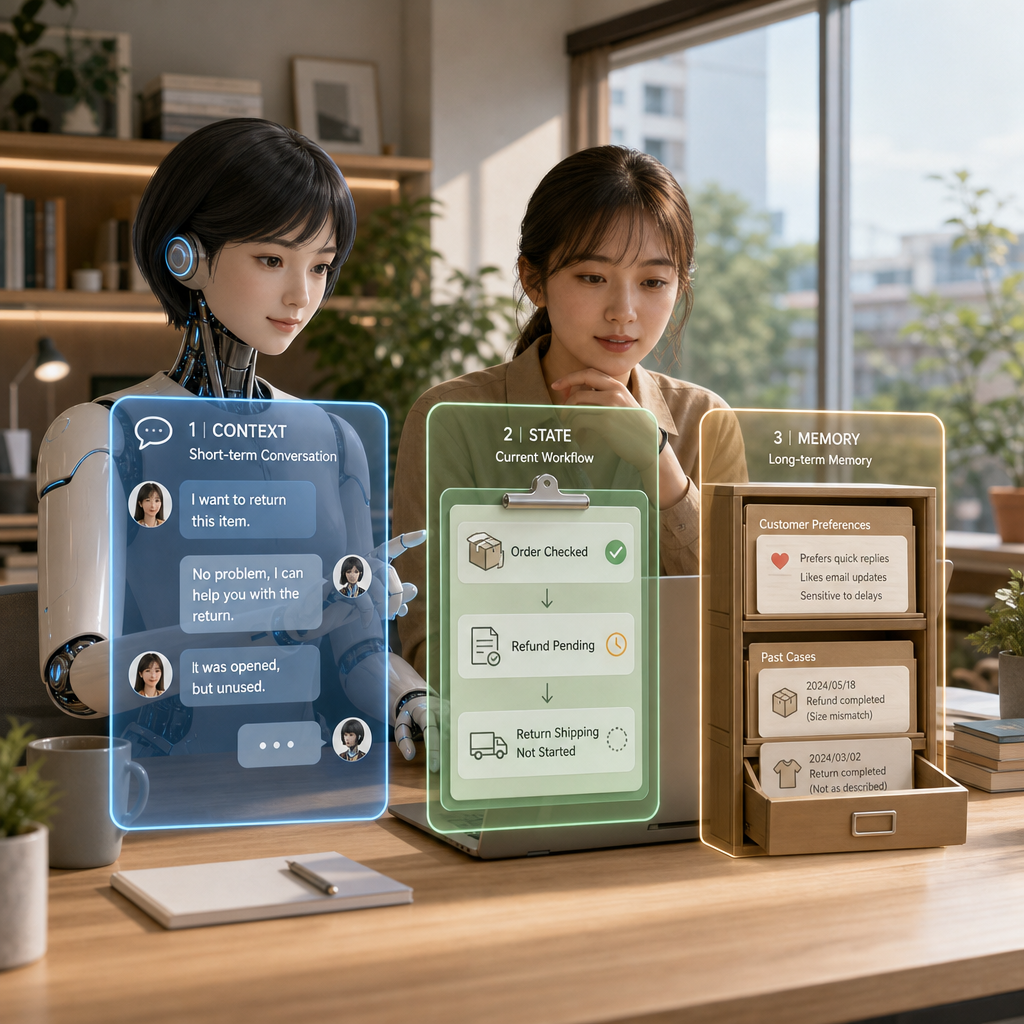
模型為何會失憶?
直接答案是:模型不會自動保留上一段對話以外的資訊。每次呼叫模型時,系統只能依靠提示詞、當次對話內容與外部檢索資料回答;關閉工作階段後,若沒有資料庫或檔案層保存,使用者偏好、任務進度與例外處理就會消失。這也是企業感覺代理人「明明剛教過又忘記」的根本原因。
上下文視窗是本次推理可見的輸入範圍,狀態則是流程目前走到哪一步,例如訂單已查詢但尚未退款;記憶則是可在未來任務重新擷取的資訊。三者不可混為一談。把所有資料都放進上下文雖然簡單,卻會稀釋指令、拉長延遲,也難以辨識資訊來源與有效期限。
實務上可把記憶視為代理人的外接認知層:它負責記錄已確認的事實、可重複使用的操作方法與互動偏好,但不取代當前任務狀態。CoALA 論文《Cognitive Architectures for Language Agents (CoALA) paper | 2309.02427 | February, 2024》便將記憶、行動與決策放在可分工的認知架構中討論。
- 上下文:本次模型呼叫可直接讀到的內容
- 狀態:流程目前位置、重試次數與任務結果
- 記憶:跨回合、跨工作階段可擷取的資訊
短期、長期與工作記憶如何分工?
直接答案是:短期記憶處理眼前對話,工作記憶保存當前推理需要的中間結果,長期記憶則保存跨任務仍有價值的資訊。客服代理可在短期記憶保留本次客訴內容,在工作記憶保留已查詢的訂單編號,並在長期記憶保存顧客同意的聯繫偏好。
常見的長期記憶還可分成情節、語義、程序與角色記憶。情節記憶保留某次事件與處置結果;語義記憶存放產品規格、制度與已驗證事實;程序記憶保存操作步驟;角色記憶界定代理人的語氣、權限與服務範圍。分類愈清楚,後續更新與刪除愈安全。
容量不是愈大愈好。若把長篇逐字紀錄全部注入提示,相關訊息反而被埋沒。實務可將總載入量控制在 context window 的 20% 以內,因為超過 30% 就會開始變慢;這項預算也應涵蓋系統指令、工具結果、使用者輸入與安全規則。
- 短期記憶適合本次對話的最近脈絡
- 工作記憶適合任務計畫與中間計算結果
- 長期記憶應保留可驗證、可再利用的資訊
記憶不是聊天紀錄:摘要與蒸餾的必要性
直接答案是:原始聊天紀錄應作為稽核證據,不能直接等同於可供代理人採用的記憶。可採用「原文、摘要、結構化記憶」三層:原文供人工追查,摘要保留任務脈絡,結構化欄位則記錄事實、來源、信心分數、有效期限與資料敏感度。
例如某個團隊一開始只維護一個檔案:`MEMORY.md`,大約 60 行;若任由每次討論累積,兩個月後這個檔案長到 800 行。這不代表檔案式記憶不可用,而是提醒團隊必須設計摘要門檻、主題拆分、去重規則與過期清理機制。
對長對話而言,可設定每隔 3-5 轮对话自动生成摘要存入记忆,但摘要必須標示來源範圍,並禁止自行把猜測寫成事實。若 200 行大約是 3000-4000 token,持續載入多份文件很快會壓縮工具輸出與模型推理空間,造成回答看似完整卻遺漏關鍵條件。
- 原始紀錄保留可追溯性
- 摘要降低重複內容與載入成本
- 結構化欄位支援更新、刪除與權限控制
記憶讀寫流程:讓 AI Agent 取回正確而非最多的資訊
兩階段流程如何避免錯誤累積?
直接答案是:記憶治理至少要把寫入與讀取拆開設計,也就是「兩階段記憶流程:擷取與更新」。擷取階段依任務意圖、使用者身分與資料權限找出候選內容;更新階段才決定新增、合併、更正、失效或刪除,不能把每句模型輸出直接寫入長期儲存。
寫入前應檢查來源是否可信、資訊是否真的具跨任務價值、是否含個資,以及是否與既有內容衝突。建議每筆記憶都附上來源文件、寫入原因、建立者、版本、有效期限與信心分數。這些欄位能讓團隊在模型答錯時回溯「它為何相信這件事」。
讀取時也不應只看向量相似度。代理人要先依任務篩選租戶、部門與資料分類,再以關鍵字、時間、權威度與語意分數重排序。企業知識庫的檢索品質若不穩,應先檢查 RAG 重新排序的實作策略,避免把不相關片段錯送給模型。
- 寫入前做來源、價值、衝突與敏感性檢查
- 讀取前先做權限與任務篩選
- 每筆記憶保留來源與版本以利稽核
RAG、向量資料庫與知識圖譜怎麼搭配?
直接答案是:RAG 適合從大量非結構化文件找證據,向量資料庫適合語意相近的召回,知識圖譜適合追蹤實體關係與規則依賴;企業通常需要混合式檢索,而非只選一種。尤其當輸入文檔總量超過 500 頁時,單靠完整上下文載入既昂貴,也不利於精準引用。
向量檢索會將文字轉成嵌入向量,再依相似度找候選片段;但它可能召回語意接近、事實卻不適用的舊內容。因此,產品規格、合約狀態與組織關係等高風險資料,適合以結構化資料庫或知識圖譜加上時間條件驗證。
混合架構可先以關鍵字鎖定精確術語,再以向量找語意近似內容,最後用重排序模型與規則過濾。檔案式記憶則適合小型、穩定的角色規則與專案摘要。選擇的核心不是技術潮流,而是能否說明「這段資料為何被取回、是否仍有效、誰可以使用」。
- RAG:從文件取得可引用證據
- 向量檢索:改善自然語言的語意召回
- 知識圖譜:維護關係、規則與時間依賴
錯誤記憶該如何更正與復原?
直接答案是:錯誤記憶不能只靠「下次不要再用」,而要有可執行的失效與回滾流程。當使用者更正地址、政策版本更新或模型誤把推測當事實時,系統必須能標記舊記憶失效、建立新版本,並讓日後檢索優先採用最新且具權威來源的紀錄。
可建立衝突偵測規則,例如同一客戶同時存在兩個付款偏好、同一產品有不同退貨期限,便進入人工覆核佇列;高風險任務不得由模型自行選擇。對疑似提示注入或未經授權工具回傳的內容,應只存放在隔離區,禁止成為可自動召回的永久記憶。
觀測畫面至少應呈現記憶寫入原因、來源連結、召回排名、是否被模型採用、是否被使用者拒絕及後續修正結果。這些紀錄讓團隊能衡量召回準確率、遺漏率、衝突率、延遲與 Token 消耗,而不是只憑個案感覺判斷系統是否進步。
- 以版本化取代直接覆寫
- 衝突與敏感資料進入人工覆核
- 保留採用與拒絕紀錄,建立可觀測性
AI Agent 有了記憶後,才能完成目標導向的工作
AI Agent 與聊天機器人差在哪裡?
直接答案是:AI Agent 不只是回答問題,而是能朝目標反覆感知、判斷與執行的系統。其基本行為可概括為「1) perceiving their environment, 2) processing information, 3) making decisions, and 4) executing actions to achieve a goal.」因此它需要模型、工具、身分指令、記憶、管道與治理機制共同運作。
一般聊天機器人多半以單輪或短對話提供內容;RPA 擅長固定規則;RAG 強化知識查詢;AI Agent 則可根據結果調整下一步,例如先查庫存、再評估替代品、最後草擬客服回覆。然而任務若規則固定、風險高且流程不變,使用傳統工作流或 RPA 往往更可靠。
市場採用不代表可以略過治理。調查指出「79% of U.S. business leaders report some level of AI agent adoption.」,但另一份數據也指出「December 2025. 11% in production, 38% piloting.」。這顯示許多企業仍在驗證階段,原因通常不是模型不夠聰明,而是資料、權限與流程責任尚未釐清。
- 聊天機器人以回覆為主,Agent 以任務完成為主
- Agent 能呼叫工具,但需要權限與停止條件
- 固定、低變異任務不必勉強使用自主代理
記憶如何改善規劃與工具呼叫?
直接答案是:記憶讓代理人能根據已知限制規劃,而不是每次從零猜測。採購代理若記得供應商核准名單、預算規則與最近一次詢價結果,就能減少重複 API 呼叫;客服代理若記得使用者偏好的聯繫管道,便能避免給出不適合的處理建議。
不過,工具輸入與長期記憶都必須分級。模型可以查詢 CRM,不代表可以修改付款資料;模型知道某項偏好,也不代表可用於行銷用途。代理人應持有獨立身分,採最小權限存取,並針對退款、刪除、下單等不可逆操作要求逐步核准。
一個可衡量的商業情境是銷售支援。若代理人能從合格來源取回客戶產業、既有往來與產品限制,再協助業務安排後續行動,確實可能「increase their leads by 25%」。但這種成果必須以同一批名單、人工基準與明確歸因驗證,不能把模型生成量直接當成商機成長。
- 記憶可減少重複查詢與錯誤規劃
- 工具權限要與讀取記憶權限分開管理
- 不可逆動作應加入人工核准與完整稽核
如何設計失敗復原與人工接管?
直接答案是:可靠的 Agent 必須假設工具會逾時、資料會缺漏、步驟可能部分成功。每個任務都應有唯一識別碼、重試上限、冪等設計與補償動作;例如付款建立成功但通知失敗時,只重送通知,不可再次扣款。記憶層要保留每一步狀態,才能安全續跑。
建議將自主程度切成「只建議、逐步核准、條件式自動執行、全自動」四級。涉及客戶權益、法規、財務或外部發布時,先採只建議或逐步核准;只有在測試資料與影子模式證實穩定後,才逐漸放寬。這比一開始追求全自動更容易建立現場信任。
人工接管不是失敗,而是治理設計的一部分。交接畫面應提供任務目標、已查閱的記憶、工具執行紀錄、失敗原因與建議下一步,讓人員能在幾分鐘內接續,而非重新理解整段對話。後續再把人工修正標記為訓練或規則改善素材。
- 為每個任務保存狀態、重試與回滾資訊
- 依風險調整自主程度,而非全面自動化
- 人工接管介面必須顯示決策依據
AI代理人框架選型:把記憶做成可替換、可觀測的元件
框架選型先看什麼,而不是先看名稱?
直接答案是:選擇 AI代理人框架時,先確認既有語言棧、部署環境、資料權限、觀測需求與未來替換成本,再評估框架功能。LangChain、LangGraph、Mem0、Cognee、Letta、MemGPT 與 LangMem 都可協助建構記憶或編排,但它們的狀態模型、儲存方式、可觀測性與託管依賴程度不同。
框架應讓記憶介面可抽換,例如將「寫入、搜尋、取得來源、失效、刪除」定義為內部資料契約,避免商業邏輯直接綁定特定向量資料庫。這樣在成本、延遲或合規需求改變時,團隊可以替換底層元件,而不必重寫所有代理任務。
採用壓力正在提升:46% of U.S. employees now use AI at work at least occasionally,26% use it frequently (a few times a week or more),但 only 38% of employees saying their company has formally adopted AI。這個落差說明框架選型不能只看開發速度,也要考量正式治理、支援流程與維運責任。
| 項目 | 檔案式 | 向量式 | 圖形式/混合式 |
|---|---|---|---|
| 適合資料 | 角色規則、摘要 | 非結構化文件 | 關係資料、複雜規則 |
| 檢索方式 | 固定載入 | 語意相似度 | 關係查詢加混合檢索 |
| 主要風險 | 內容膨脹 | 語意誤召回 | 建模與維護成本 |
| 治理重點 | 版本與篇幅 | 來源與重排序 | 實體版本與權限 |
- 先盤點語言棧、雲端、權限與維運能力
- 用資料契約隔離記憶供應商依賴
- 把可觀測性與安全測試列為必要功能
七層架構如何連結記憶與治理?
直接答案是:記憶不該被孤立成一個資料庫,而要放進完整交付架構。可參考 seven interconnected layers:Layer 1: Foundation models、Layer 2: Data operations、Layer 3: Agent frameworks、Layer 4: Deployment and infrastructure、Layer 5: Evaluation and observability、Layer 6: Security and compliance、Layer 7: Agent ecosystem。
在這個分層中,記憶的內容品質屬於資料營運,讀寫與狀態流轉屬於框架,延遲與擴縮屬於基礎設施,召回品質屬於評估,資料保留與租戶隔離則屬於安全合規。若只由單一開發者維護「一個記憶工具」,通常難以處理跨部門權責與事故追蹤。
截至 2026 年底,40% 的企業應用將內嵌任務型 AI Agent,而2025 年還不到 5%。到 2026 年中,全球約 31% 的企業已有至少一個 AI Agent 在正式環境運作。這類擴張速度更要求企業從一開始就定義資料契約、模型版本、工具權限與退場機制。
- 資料、框架、部署、評估與安全需共同設計
- 記憶品質需要獨立量測,不可只看回覆流暢度
- 架構需保留模型、框架與儲存層的替換空間
如何建立公平的框架評估?
直接答案是:所有框架都應用同一組任務、同一模型、同一資料集與同一權限設定測試。評估至少包含任務成功率、工具呼叫正確率、記憶召回準確率、遺漏率、衝突率、平均延遲、Token 成本、人工接管率,以及錯誤後能否安全重試或回滾。
測試集要納入真實難題,例如使用者更正偏好、文件版本互相矛盾、敏感資料不應召回、工具回傳惡意指令,以及長期任務被中斷後是否能恢復。若只用單次問答展示,很容易高估框架能力,卻低估正式環境的維運成本。
框架評估完成後,仍要執行影子測試:代理人在背景提出建議,但不直接執行,由人員比較其結果與既有流程。當錯誤類型與成本被量化,管理層才有條件決定是否擴大自動化,而不是被單一炫目的展示牽動投資。
- 固定模型、資料與任務,才能公平比較
- 把安全、回滾與人工接管納入測試
- 先影子運行,再逐步開放權限
AI代理人協作與 AI工作流程:避免多代理人互相放大錯誤
何時需要多代理人協作?
直接答案是:只有任務可清楚分工、交接內容可驗證、並行確實能縮短時間時,才適合 AI代理人協作。常見角色包括規劃者、資料檢索者、執行者、審核者與協調者;例如供應鏈異常處理可由檢索者找訂單資料、分析者提出選項,再由具權限的執行者建立工單。
多代理不是品質保證。若每個代理人都讀取不同版本的記憶、缺乏共同任務 ID,或把彼此未驗證的結論寫回長期記憶,錯誤會快速擴散。高品質協作應定義訊息格式、資料來源、責任邊界、交接驗證、循環偵測與最大重試次數。
最簡單的做法往往最好:先用單一代理搭配明確工具與人工核准,只有在瓶頸確認來自角色分工或平行處理時才拆分。這能避免把原本可由固定 AI工作流程解決的任務,變成難以除錯的多代理網路。
- 分工必須有明確輸入、輸出與驗收條件
- 共享記憶需附來源與版本,避免錯誤擴散
- 先證明單一代理不足,再增加協作角色
工作流程整合為何比模型能力更重要?
直接答案是:代理人價值來自能安全融入既有系統,而非單獨展示流暢對話。85% 的企業領導者把「工作流整合」列為 AI 投資首要優先。這表示企業關心的是代理能否連接 ERP、CRM、文件庫與核准流程,同時留下可稽核的操作證據。
客服是容易量化的起點。若知識庫、客戶身分、升級規則與人工覆核都整合良好,案例可達平均客服處理時間縮短 62%,客戶滿意度提升 18%。不過,這些數字必須搭配服務範圍、案件難度與人工升級比例閱讀,不能把所有客服情境視為同一難度。
財務流程也適合以狹窄任務先驗證:供應商發票的自動化處理率從 30% 提升至 91%,月結帳期間的財務團隊加班時數減少 70%。關鍵不在讓代理自由判斷付款,而是讓它抽取欄位、比對規則、標示例外,並把核准權留給合格人員。
- 整合既有系統時要保留操作稽核
- 以狹窄、可量測流程先建立成功案例
- 財務與客服均應保留例外處理與人工核准
協作記憶要如何做權限與資料隔離?
直接答案是:每個代理人都應以獨立身分存取最低必要資料,而不是共用一個無限制的記憶池。人資代理不應看到財務敏感欄位;客服代理不應寫入產品政策;跨租戶服務更要在檢索前以租戶 ID 強制過濾,避免向量相似度跨越資料邊界。
敏感記憶需要完整生命週期治理:取得使用者同意、標示用途、設定保留期限、支援更正與刪除、傳輸及儲存加密,並保留存取稽核。對含個資或機密的資料,也要避免直接送往不符合公司政策的外部模型或未受信任的 MCP 工具。
協作平台的日誌應記下誰讀取、誰寫入、使用了哪個工具、輸入輸出摘要及核准結果,但日誌本身也要遮罩敏感內容。安全不是代理上線前的一次性檢查,而是每次新增工具、調整提示或更換模型後都要重新驗證的控制流程。
- 代理身分、租戶與資料分類必須一同驗證
- 敏感記憶要有同意、保留、刪除與稽核機制
- 日誌要可追溯,也要避免二次外洩
用 PoC 驗證 AI代理人記憶,從可用原型走向正式營運
PoC 要驗證哪些假設?
直接答案是:PoC 不該只驗證「模型會不會回答」,而要驗證記憶能否在真實資料與真實流程中提升成果。建議先選一個範圍明確的任務,例如客服案件摘要、需求預測異常說明或採購文件比對,並定義成功基準:召回正確率、處理時間、人工修正率、延遲、成本與使用者接受度。
ALION 的做法是從現場調查與訪談開始,將目標、資料前提、技術可行性與效益放在最小配置中驗證。這種方式特別適合記憶架構,因為真正的難題往往不是能否串接向量資料庫,而是資料是否乾淨、流程責任是否清楚,以及現場是否願意採用。
PoC 的價值也包括得出 No-Go。若測試發現關鍵資料缺漏、例外情境太多、權限無法安全切分,暫緩正式開發可能比匆忙上線更有價值。設計、程式碼、測試案例與資料契約應保留為資產,避免驗證結束後所有成果被丟棄。
| 步驟 | 要做什麼 | 注意事項 |
|---|---|---|
| 目標設定 | 定義 KPI 與任務邊界 | 避免只測模型文筆 |
| 資料盤點 | 分類來源與權限 | 確認個資與版本 |
| 原型驗證 | 測試讀寫與工具流程 | 保留人工覆核 |
| 效益評估 | 比較人工基準與成本 | 提出 Go/No-Go |
- 先定義可量化 KPI,再選技術
- 以實際資料測試記憶召回與流程例外
- No-Go 結論同樣能降低後續投資風險
如何把評估指標轉成投資判斷?
直接答案是:投資判斷必須同時衡量品質、成本與風險。品質面可看任務成功率、正確召回率、錯誤記憶率與人工修正率;效率面可看平均處理時間、每件 Token 成本與工具延遲;治理面則看未授權存取、提示注入攔截率與可追溯覆蓋率。
測試時要建立人工基準組,讓相同案件分別由既有流程與代理輔助流程處理,再比較結果。不要只統計代理完成件數,因為大量低品質輸出可能把後續覆核成本轉嫁給現場人員。對外部動作更應計入退件、重工、客訴與事故處理成本。
ALION 的 AI 上游工程訂閱服務月費 20 萬日圓起,可用於需求梳理、設計文件、架構規劃與示範製作。相較於聘僱CTO級人才的月薪 80〜150 萬日圓,或外包開發的啟動費約 300 萬日圓起,小規模驗證可先把討論從「要不要跟風」轉成具體 KPI 與投資證據。
- 品質、效率、風險都要有可比較的基準
- 將人工覆核與錯誤重工成本納入 ROI
- 先驗證再擴大,可降低需求反覆造成的浪費
正式上線後如何持續維運?
直接答案是:正式上線不是記憶設計的終點,而是持續校正的開始。團隊應定期檢查低分召回、被人工否決的答案、更新頻繁的知識類別與異常工具呼叫,並以版本化方式調整提示、檢索規則、資料切分與權限策略,確保改善可回溯也可回滾。
建議建立月度記憶健康檢查:抽樣審核新寫入內容、清除過期摘要、比對權威來源版本、檢視資料保留期限,並重新測試提示注入防護。當業務規則或組織權限改變時,應把記憶遷移與再評估列入變更流程,而非只更新前端介面。
可信參考資料可從 Anthropic 的文件、Microsoft Agent Framework 文件、NIST AI Risk Management Framework 與 CoALA 論文開始:https://docs.anthropic.com/、https://learn.microsoft.com/agent-framework/、https://www.nist.gov/itl/ai-risk-management-framework、https://arxiv.org/abs/2309.02427。
- 以版本化、抽樣稽核與回滾維護記憶品質
- 將資料與權限變更納入正式變更管理
- 持續測量人工否決、錯誤召回與安全事件
總結
AI代理人記憶的核心不是保存得愈多愈好,而是讓 AI Agent 能在權限範圍內擷取正確、可追溯且仍有效的資訊。從短期上下文、長期知識、混合檢索到協作治理,企業都應把記憶視為一套可量測、可更正、可刪除的資料產品,而非單純的聊天紀錄。
重點整理
- 先區分上下文、任務狀態與長期記憶,避免把所有紀錄直接塞入提示。
- 以來源、版本、權限、有效期限與人工覆核管理每一筆重要記憶。
- 框架選型應比較資料契約、可觀測性、安全能力與替換成本,而非只比較功能清單。
- 多代理協作前,先定義分工、交接格式、失敗復原與責任邊界。
- 以小規模 PoC 驗證召回品質、成本、現場可用性與 Go/No-Go 條件。
若你的團隊已經有 AI 導入想法,卻不確定記憶架構、資料條件與效益是否足以支撐正式開發,建議先挑選一個高頻、可量測、風險可控的流程進行 PoC。透過現場調查、實際資料與明確 KPI 驗證,才能把代理人的「記得住」轉化為業務真正可用、可治理的能力。
常見問題 FAQ
Q1. AI代理人記憶和 RAG 是同一件事嗎?
不是。RAG 是從外部知識來源檢索內容並提供模型回答的方法;AI代理人記憶還包含任務狀態、使用者偏好、事件紀錄、程序經驗,以及更新、失效與權限治理。RAG 可作為記憶架構中的重要檢索層。
Q2. 是否應該把所有對話紀錄存成長期記憶?
不建議。所有紀錄都寫入會造成成本上升、相關性降低與敏感資料風險。應先保留原始紀錄供稽核,再透過摘要、去重、來源驗證與有效期限,挑選具有跨任務價值的內容寫入長期記憶。
Q3. 企業何時適合導入多個 AI Agent?
當任務可明確拆分、每個角色有不同工具或權限,且交接資料可驗證時,才適合多代理協作。若流程固定、低變異或高風險,通常以單一代理搭配固定工作流與人工核准更容易維運。
Q4. 導入記憶系統前,最重要的 PoC 指標是什麼?
應同時測量任務成功率、記憶召回正確率、人工修正率、平均處理時間、Token 成本、工具錯誤率與敏感資料誤用風險。單看模型回答是否流暢,無法判斷系統能否安全投入正式營運。
Q5. 如何處理使用者要求刪除或更正記憶?
系統應提供可識別的記憶來源與版本,將更正建立為新版本、把舊資訊標記失效,並依資料政策完成刪除與稽核。若資料已進入摘要、向量索引或備份,也必須將這些衍生儲存納入同一套刪除流程。