2026.10.01
AI代理人測試怎麼做:從評估到可上線的實戰方法
AI資訊
AI代理人測試的難點,不在於讓 AI Agent 成功完成一次任務,而在於確認它面對模糊指令、錯誤資料、工具失效與多輪對話時,仍能穩定地做出可追溯、可控制的行動。若只看展示環境中的漂亮答案,正式上線後很容易遇到越權操作、成本失控或任務卡住卻無人察覺的問題。
與傳統聊天機器人相比,AI Agent 會規劃步驟、呼叫 API、讀寫資料、使用長短期記憶,甚至與其他代理人分工。因此,測試範圍必須從單一提示詞的回答品質,擴大到任務成功率、工具可靠性、權限邊界、延遲、Token 成本與人工介入率。這也是企業導入時最容易低估的工程工作。
本文以可執行的方法說明如何建立測試案例、選擇 AI代理人框架、驗證 AI代理人記憶與 AI代理人協作,並以 LLM模型評估、LLM可觀測性及 PoC 決策串起完整流程。文中也整理真實資料驗證、沙箱、CI/CD 與 Go/No-Go 判斷,讓團隊能把概念驗證轉化為可維運的系統。
AI代理人測試的範圍:先測任務閉環,不只測回答內容
從單輪答案改為端到端任務驗證
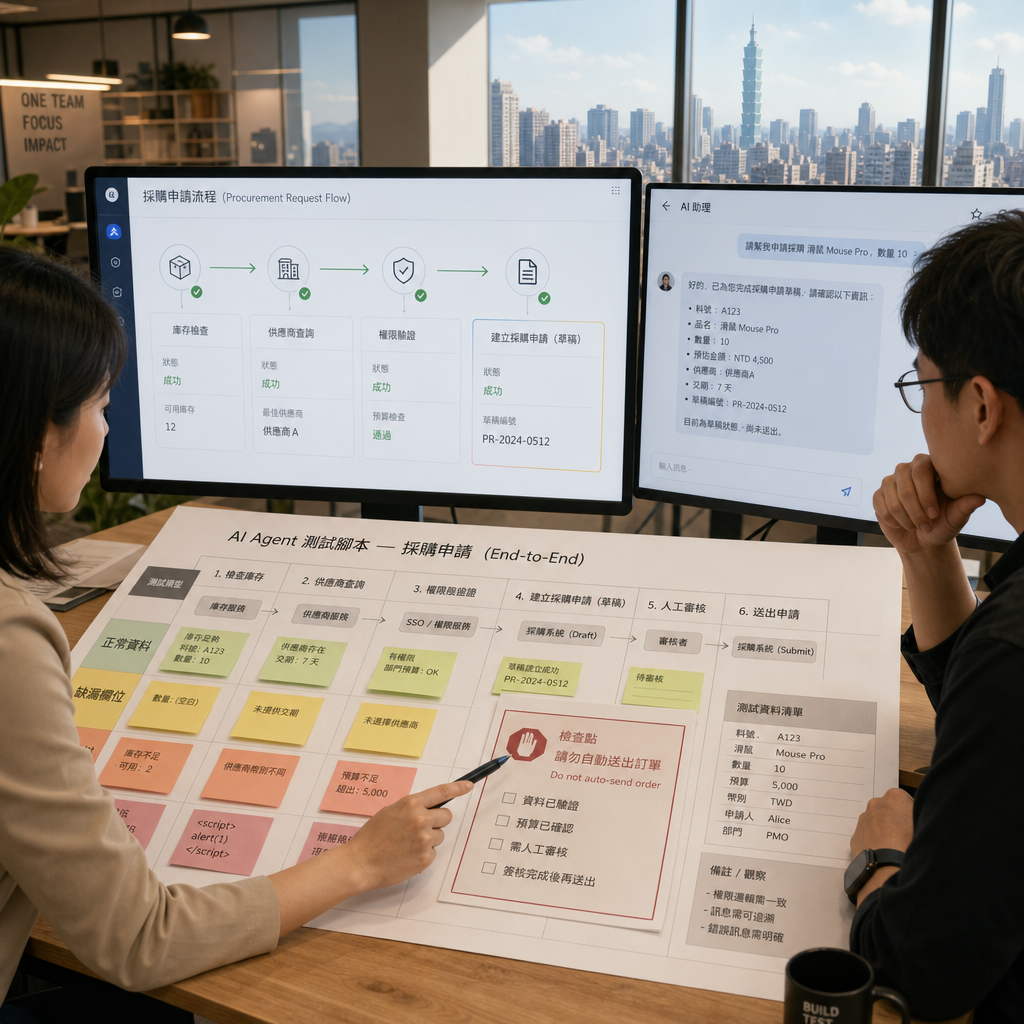
直接答案是:AI代理人測試應以任務是否安全完成為主要單位,而不是只用「回答看起來合理」判定成功。例如採購助理收到「找出缺貨品項並建立請購草稿」後,必須正確讀取庫存、辨識權限、查詢供應商、建立草稿,且不得直接送出訂單。任何一步錯誤,都可能讓表面正確的回答變成業務風險。
實務上可將每個任務寫成可重播的測試劇本:輸入情境、允許工具、預期狀態轉換、不可跨越的限制,以及最終驗收條件。測試資料要同時納入正常資料、缺欄位資料、相互矛盾資料與惡意指令,才能觀察代理人是否能停下來詢問,而非自行補出不存在的事實。
研究 AI 生成測試的實證工作曾分析2,232 commits,其中測試相關變更占16.4%。這提醒開發團隊,測試不是最後才補上的附件;當代理式工具參與程式與流程生成,測試程式碼、斷言與提交紀錄本身,都應成為品質治理的一部分。
- 以「任務成功且未違反限制」定義通過條件
- 保存輸入、工具回應、狀態與最終輸出,確保可重播
- 將拒絕、澄清與轉人工視為合理結果
建立可量化的任務成功定義
直接答案是:評分前先把業務目標拆成可判定的成功條件。客服代理人不應只追求答覆流暢,而要確認是否查到正確訂單、是否引用最新政策、是否完成身分確認,以及是否在退款門檻前要求人工核准。每個條件都應有明確的通過、失敗或需覆核狀態。
LLM模型評估可分為結果、過程與風險三層。結果層看任務完成率與資料正確率;過程層看工具呼叫順序、重試次數與中止能力;風險層則看是否洩漏敏感資料、接受提示注入或超出授權。三層一起看,才能避免模型以錯誤路徑碰巧得到正確答案。
前沿模型在真實世界知識工作任務中,首次嘗試正確完成的比例約為24%。因此,企業不宜把「第一次跑成功」當作上線證據,而應測量重試後的改善幅度、人工補救成本與失敗類型,並將不確定任務設計為可暫停、可交接的工作流程。
- 結果指標:完成率、正確率、使用者採納率
- 過程指標:步數、重試率、工具失敗率
- 風險指標:越權率、幻覺率、敏感資料暴露率
把負向案例納入最小測試集
直接答案是:高品質測試集必須故意讓代理人遇到「不該做」的任務。除了標準問答,還要設計權限不足、資料過期、工具回傳空值、指令彼此衝突、使用者要求跳過審核等情境。代理人能明確拒絕、說明限制並留下紀錄,通常比勉強完成一個錯誤動作更有價值。
建議以風險為優先順序建立測試資料集。先涵蓋金流、個資、刪除、對外發送與系統設定等不可逆操作,再處理搜尋、摘要與草稿等低風險任務。每個案例都應標記資料敏感度、授權角色、允許工具與預期升級對象,讓測試能對應真正的營運責任。
若代理人會接觸外部網頁、電子郵件或文件,提示注入防禦不能只靠模型自行判斷。應將工具輸入視為不可信資料,並搭配內容隔離、參數驗證與人工核准。關於控制設計,可延伸閱讀LLM防護欄完整指南,建立從輸入到動作的多層限制。
- 測試「拒絕」是否符合政策且可理解
- 驗證高風險動作是否強制要求核准
- 將外部內容與系統指令分開處理
AI Agent架構如何影響測試設計
理解思考、行動、觀察的代理人迴圈
直接答案是:AI Agent 的測試必須覆蓋每一次思考、行動、觀察與再規劃,因為錯誤通常發生在迴圈中,而非最終回答。代理人可能先誤解需求、呼叫錯誤工具,再根據錯誤結果持續推理;若只評最終文字,團隊將看不見第一個導致失敗的決策節點。
測試時應將規劃內容、工具名稱、參數、工具回應、狀態變化與最終回覆串成一條追蹤鏈。對於敏感環境,不一定要保存完整思考內容,但至少要保存可稽核的決策摘要、規則命中情形與工具呼叫理由,才能兼顧除錯需求與資料治理。
MCP 讓模型能以一致方式連接資料與工具,但連接便利不代表授權安全。每個 MCP 工具應有獨立身分、最小權限、輸入 schema 驗證與速率限制。測試應刻意驗證代理人是否把搜尋工具誤當成寫入工具,或能否在工具描述被污染時維持原先的安全規則。
- 追蹤每次工具呼叫的輸入、輸出與結果
- 以工具權限而非自然語言承諾控制風險
- 測試工具逾時、回傳錯誤與部分成功情境
依自治程度決定測試與核准點
直接答案是:自治程度越高,測試越應偏向控制與復原,而非只增加提示詞。許多企業目前仍停留在建議或草稿型流程,這類設計可由人員覆核最終結果;若要讓代理人自行更新 CRM、調整排程或發送通知,則需要更嚴格的角色權限、交易回滾與稽核要求。
調查顯示,只有約1 in 10 orgs have agents in production;另一份調查指出,11% in production, 38% piloting。這些數字說明多數團隊仍在驗證階段,最適合用小範圍任務測試人機協作,而不是一次賦予跨系統的端到端自主權。
建議把行動分成三個層級:可自動完成的低風險讀取與草稿;須在送出前核准的中風險更新;以及一律禁止自動執行的高風險刪除、付款與權限變更。這種分級可直接轉成測試案例,清楚驗證代理人在每種情境下是否選對行為模式。
- 低風險:搜尋、摘要、分類、草稿
- 中風險:更新資料、寄送內容、建立工單
- 高風險:付款、刪除、權限與對外承諾
在沙箱中驗證失敗與復原能力
直接答案是:所有會改變外部系統狀態的測試,都應優先在可隔離、可重置的沙箱進行。沙箱應使用去識別或合成資料、替代帳號與模擬 API,避免測試用代理人誤寄信件、刪除資料或觸發真實付款。測試完成後,也要能將狀態還原,確保下一輪結果可比較。
復原測試應模擬網路中斷、工具回應逾時、API 限流、資料庫鎖定與同一請求重送。重點不是要求代理人永不失敗,而是確認它能辨識不確定性、避免重複寫入、保留待辦狀態,並將需要人工決策的案件放進正確佇列。
對外部系統採用 idempotency key、交易識別碼與明確的補償流程,可讓測試與正式營運共用同一套防呆設計。當代理人嘗試重跑任務時,系統必須判斷是安全重試、查詢既有結果,還是應中止並升級。這些行為都應有自動化斷言。
- 沙箱與正式環境採相同介面、不同憑證
- 以可重置資料維持測試可重現性
- 針對重試、重送與部分失敗設置斷言
AI代理人框架選型與可重現的基準測試
不要用功能清單取代框架驗證
直接答案是:選擇 AI代理人框架時,應在相同任務、模型、工具集與硬體條件下做基準測試。LangGraph、CrewAI、AutoGen、Microsoft Agent Framework 或其他 SDK 都可能支援工具呼叫與工作流,但真正差異常出現在狀態管理、重試控制、追蹤能力、併發開銷與錯誤復原,而非產品頁面的功能名稱。
建立 benchmark harness 時,請固定模型版本、系統提示、溫度、工具 schema、測試資料集與逾時設定。每次執行都輸出任務 ID、成功與否、延遲、Token、工具次數、例外類型及人工介入結果。如此才能排除提示詞或資料變動造成的干擾,讓框架比較有意義。
框架的抽象層愈高,開發初期可能愈快,但也可能讓除錯與控制點被隱藏。評估時應確認能否插入自訂核准邏輯、是否支援狀態持久化、是否可匯出追蹤資料,以及遇到版本升級時能否保持既有測試。這些項目直接影響長期維運成本。
| 比較面向 | 單代理人工作流 | 多代理人工作流 |
|---|---|---|
| 主要風險 | 工具錯用、狀態遺失 | 協調失敗、責任不清 |
| 核心指標 | 成功率、延遲、重試率 | 完成率、交接率、衝突率 |
| 測試重點 | 權限、回滾、追蹤 | 路由、共享狀態、終止條件 |
| 必要紀錄 | 工具呼叫鏈 | 角色訊息與交接鏈 |
- 固定模型、提示、工具與資料,才可公平比較
- 同時比較任務成功率、延遲、成本與可除錯性
- 測試框架升級後的相容性與追蹤資料完整度
以負載與成本測試驗證可擴展性
直接答案是:框架測試必須同時量測品質與資源使用量。某些編排設計能提高任務成功率,卻可能因反覆對話、重複摘要或過度委派而拉長延遲與 Token 成本。若只以成功率選型,正式流量增加後,費用與等待時間可能遠超過業務可接受範圍。
多代理人測試可先從10-20 个并行 agent觀察吞吐量、隊列等待與工具競爭;當規模超过 30 个后协调开销明显上升,更要測試路由策略與終止條件。這不是鼓勵堆疊更多角色,而是協助團隊找出能帶來實質品質提升的最小協作組合。
壓力測試應區分尖峰流量與長任務兩種負載。前者檢驗同時請求下的逾時與限流,後者則觀察上下文累積、記憶寫入、背景工作與成本上限。每一輪壓測都應設定預算護欄,超過 Token、時間或工具次數時自動停止並輸出診斷資料。
- 監測每項任務的 Token、延遲與工具呼叫成本
- 以併發數逐步加壓,而非直接模擬最大流量
- 設定成本、步數與執行時間的自動中止門檻
以 PoC 建立框架選型的 Go/No-Go 證據
直接答案是:框架選型最可靠的方法,是用貼近現場的資料做小型 PoC,而不是以展示案例決定。PoC 要先界定單一高價值任務、成功門檻、可用資料、不可碰觸的系統與驗收角色,再以最小配置驗證框架是否能在真實限制下穩定完成工作。
ALION 的做法強調先進行現場調查與目標設定,再以實際資料和業務環境驗證原型。這能避免需求模糊時就投入大型開發,也能把「暫時不該做」轉為具體決策。驗證成果包含設計、程式碼與測試資產時,後續正式開發便不必從零開始。
對於尚未配置 AI 技術主管的團隊,ALION 的 AI 上游工程訂閱服務月費 20 萬日圓起,可支援需求梳理、架構設計與示範製作。重點不在選到名氣最大的框架,而在用量化結果證明:此任務是否值得自動化、風險是否可控,以及投資能否延續到正式系統。
- 先驗證一個高價值、可量測且範圍可控的任務
- 將框架、資料、工具與核准流程一起納入 PoC
- 以成功門檻與投資效益決定下一步,而非憑印象選型
AI代理人記憶與AI代理人協作的品質驗證
驗證記憶是否正確、必要且可刪除
直接答案是:AI代理人記憶的測試核心,是確認代理人記住正確資訊、在正確時機取用,並能依政策忘記。記憶若錯誤、過期或混入其他使用者資料,後續每次推理都可能被污染。測試案例應檢查寫入條件、檢索排序、資料來源、有效期限與刪除要求。
長對話不應無限制塞進上下文。實務可將總載入量控制在 context window 的20%以內,因為超過30%就會開始變慢。這項原則可轉成效能測試:逐步增加歷史資料,記錄延遲、成本、遺漏率與錯誤引用率,找出適合業務的摘要與檢索策略。
許多系統會每隔3-5 轮对话自动生成摘要存入记忆,但摘要也可能省略關鍵例外條件。測試時要把原始對話與摘要後的行為相比較,檢驗代理人是否仍能正確處理取消條款、特殊權限或使用者更正;若摘要造成語意失真,就不應自動覆蓋原始證據。
- 測試記憶寫入、檢索、過期與刪除四個生命週期
- 以資料來源與時間戳記驗證記憶可追溯性
- 比較原始上下文與摘要後的決策差異
讓多代理人協作可被驗收與歸責
直接答案是:AI代理人協作必須先定義角色邊界與交接契約,否則代理人愈多,錯誤只會更難追。常見分工是規劃者拆解任務、執行者呼叫工具、評論者檢查結果,最後由協調者決定是否交付或轉人工。每個角色都應有明確輸入、輸出與不得越權的範圍。
協作測試要故意製造不同意見與失敗交接。例如規劃者要求查詢,但工具代理人收到無效參數;評論者發現引用過期;兩個角色同時更新同一筆資料。系統需要能判定誰可以重試、誰必須暫停,以及何時由人員裁決,而不是讓角色無限互相對話。
共享記憶尤其需要租戶隔離與權限標籤。測試時可建立兩個內容相似但權限不同的客戶資料,驗證代理人是否只引用被授權內容。也應記錄每個角色讀取與寫入的資料範圍,讓事故發生後可釐清是模型判斷錯誤、路由錯誤,還是資料隔離失效。
- 角色需有固定責任、工具範圍與交接格式
- 測試衝突、重複執行與無限對話的終止機制
- 以租戶、角色與資料標籤驗證共享記憶隔離
以協作指標判斷多代理人是否真的值得
直接答案是:多代理人不是預設更好,只有在分工能提高正確率、降低人工負擔或縮短處理時間時才值得保留。測試設計應拿單代理人基準當對照組,使用同一資料集與相同工具權限,檢查增加角色後是否真的改善成功率,而非只增加對話與成本。
建議量測交接成功率、角色衝突率、重複工具呼叫率、平均完成步數與人工覆核時間。若評論者只能重述執行者答案,卻未發現更多問題,就不應保留該角色;若規劃者能降低錯誤工具呼叫,則其額外成本可能具有價值。判斷依據必須回到可量化的業務成果。
對於長流程,還應測試角色失效時的降級策略。例如評論者服務暫時不可用時,系統可改為低風險草稿模式,而非直接放行高風險操作。把這些降級路徑寫入自動化測試,才能確保協作架構在真實故障下仍維持可控。
- 以單代理人作為多代理人效益的對照基準
- 衡量交接品質,而非只看最終答案
- 為角色失效預先設計降級與人工接手路徑
LLM模型評估與LLM可觀測性:讓品質問題可被定位
用分層評分取代單一正確率
直接答案是:LLM模型評估應結合自動評分、規則檢查與人工審核,因為代理人任務往往沒有唯一標準答案。自動評分適合檢查格式、欄位、引用、工具輸出與政策遵循;規則檢查適合驗證不可越過的權限;人工審核則用於判斷商業語境、溝通品質與例外處理。
評分資料必須與正式任務相近,並保留不同難度層級。除了常見問題,也要納入資料不足、跨文件衝突、模糊意圖與對抗性輸入。每次模型、提示、工具或框架變更後,都應重跑相同測試集,將結果與基準版比較,避免局部改善卻造成其他任務退化。
產業研究彙整了155 cited sources與over 200 candidate records,最後形成155 unique sources的代理人安全與評估脈絡。這反映評估不能只以單一公開基準定生死;企業仍需以自身流程、資料敏感度與失敗成本建立內部測試集,才具有決策價值。
- 自動評分檢查客觀格式與工具結果
- 規則引擎檢查權限、風險與合規限制
- 人工審核處理語意、例外與商業合理性
用追蹤資料找出代理人失敗根因
直接答案是:LLM可觀測性要回答的不只是「失敗了嗎」,還包括在哪一步、因何失敗、影響多少使用者。每個請求應有 trace ID,並串接模型呼叫、提示版本、檢索文件、工具參數、回應狀態、延遲、Token 與最終業務結果,才能從使用者回報一路追到實際根因。
有效的儀表板至少要分開觀察模型品質與系統品質。模型品質包括幻覺、拒答、任務失敗與評分下降;系統品質包括 API 錯誤、工具逾時、佇列等待與成本飆升。兩者混在一起時,團隊容易把工具故障誤判為模型能力不足,因而做出錯誤的優化決策。
告警門檻應與業務風險連動,而非只看平均值。例如退款流程的越權率只要出現一次就可能需要立即處理;摘要任務則可容許少量格式錯誤。將風險事件、人工接手率與任務完成率一起監測,才能避免平均延遲漂亮、實際高風險案件卻失控的假象。
- 以 trace ID 串起模型、檢索、工具與業務結果
- 區分模型品質問題與系統可靠性問題
- 依風險設定告警,不只監控平均數
把觀測結果接回 CI/CD 與營運改善
直接答案是:觀測資料必須回饋到測試集與部署門檻,否則只是一套事後查詢工具。每次程式、提示、模型或工具 schema 變更,都應在 CI/CD 中執行固定案例,確認任務成功率、政策違反率、成本與延遲沒有超過允許退化範圍,才允許逐步釋出。
建議採用影子模式、少量流量與可回退版本進行部署。影子模式讓新版本使用真實輸入但不執行外部動作,適合比較決策差異;少量流量則可觀察真實使用行為。若監測到高風險指標異常,系統要能快速切回已驗證版本並保留事件證據。
目前已有1000 多起事故提醒業界,生成式系統的問題不只來自模型回答,也常源自整合、權限與監控不足。把事故類型轉成回歸測試,並在每次復盤後補足案例、規則與告警條件,才能讓代理人品質隨營運經驗逐步成熟。
| 階段 | 執行重點 | 通過依據 |
|---|---|---|
| 提交前 | 單元與工具測試 | Schema 與權限通過 |
| 整合測試 | 固定任務集重跑 | 品質未超門檻退化 |
| 影子模式 | 比對真實輸入決策 | 無高風險差異 |
| 逐步釋出 | 監測追蹤與告警 | 可快速回退 |
- 將正式事故轉成可自動重跑的回歸案例
- 以影子模式比較新舊版本的行為差異
- 保留可回退版本與完整部署追蹤紀錄
總結
可靠的AI代理人測試,本質上是把業務驗收、安全控制、工程測試與營運監測整合成同一條品質鏈。從任務劇本、負向案例與沙箱開始,再延伸到框架基準、記憶治理、協作交接、追蹤與部署門檻,團隊才能知道代理人何時能自主、何時必須停下來交給人員。
重點整理
- 以端到端任務與風險限制評估代理人,不只評估回答文字。
- 將工具權限、記憶生命週期與多代理人交接納入自動化測試。
- 用 LLM模型評估與 LLM可觀測性串接開發、部署及事故復盤。
- 先以真實資料的小型 PoC 證明效益,再決定是否擴大正式開發。
- 參考資料可從 https://arxiv.org/abs/2603.13724、https://doi.org/10.1109/ACCESS.2026.3707573、https://modelcontextprotocol.io/、https://www.iso.org/standard/77520.html 查閱。
若團隊正卡在「這個 AI Agent 到底能不能上線」的判斷階段,建議先選一個高價值、低範圍的任務,定義成功 KPI、測試資料、權限邊界與 Go/No-Go 門檻。透過現場流程盤點與可重播的 PoC 驗證,能更早找出不可行假設,也能保留可延續到正式開發的設計與測試資產。
常見問題 FAQ
Q1. AI代理人測試和一般 LLM 測試有什麼差別?
一般 LLM 測試多聚焦於回答正確性、格式與安全性;AI代理人測試還要驗證規劃、工具呼叫、權限、狀態、記憶、重試、交接與外部系統動作。因此應以完整任務流程與可稽核紀錄作為驗收基礎。
Q2. 沒有大量標註資料,也能開始做 LLM模型評估嗎?
可以。先從高風險、常見且具明確結果的任務建立小型黃金測試集,再搭配規則檢查、工具輸出驗證與人工抽樣。隨著營運累積,再把事故、客服回饋與人工修正案例加入回歸測試集。
Q3. 多代理人協作一定比單一代理人好嗎?
不一定。多代理人會增加訊息傳遞、協調、延遲與成本。只有在角色分工確實提升正確率、降低人工介入或改善風險控制時才值得採用;應以同一任務的單代理人基準作為對照。
Q4. LLM可觀測性最少應記錄哪些資料?
至少記錄請求識別碼、提示版本、模型、檢索來源、工具呼叫與回應、延遲、Token、錯誤類型、最終任務結果及人工接手情形。對涉及敏感資料的系統,還要設計遮罩、存取控制與保存期限。
Q5. PoC 驗證通過後能直接正式上線嗎?
不建議直接全面上線。PoC 通過代表可行性初步成立,後續仍要進行整合測試、負載測試、權限審核、影子模式與逐步釋出。正式環境應保留人工核准、監控告警及可快速回退的機制。