2026.10.10
AI模型微調平台怎麼選?從資料到上線的企業決策指南
AI資訊
AI模型微調平台不是單純租用 GPU 的工具,而是決定企業能否把內部知識、安全規範與業務流程轉成穩定 AI 服務的基礎設施。若只看單次訓練價格,卻忽略資料品質、版本可追溯性與上線後監控,常會出現模型離線評測漂亮、現場卻無法採用的落差。
企業導入生成式 AI 時,常在提示工程、RAG 與 LLM 微調之間猶豫。提示工程適合快速驗證,RAG 適合頻繁變動的知識查詢;當任務需要固定語氣、輸出格式、判斷準則或領域工作流程時,微調才有其價值。不過,真正的挑戰通常不是按下訓練按鈕,而是建立從資料到營運的閉環。
本文以企業選型視角,說明如何評估平台能力、建立 AI資料標註與合成資料生成流程、執行可重現的訓練實驗,並將 AI模型部署、AI模型監控與版本治理納入同一套決策框架。內容也會結合 PoC 的實務做法,讓團隊先用最小範圍取得是否投資的證據。
AI模型微調平台的選型,先看任務與治理能力
先區分提示工程、RAG 與微調的責任邊界
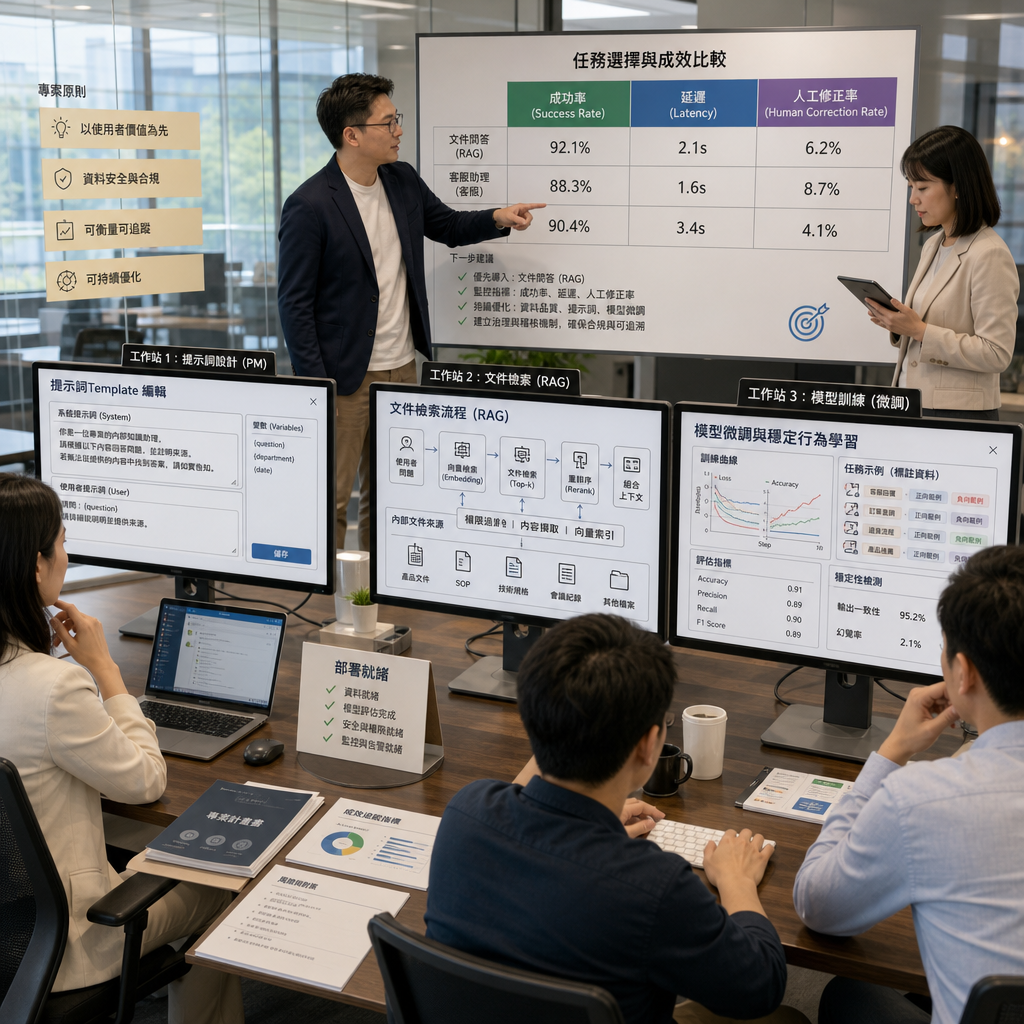
直接答案是:只有在模型必須穩定學會特定行為時,才應優先投入LLM 微調。若問題只需要引用經常更新的內部文件,RAG 通常更容易維護;若只是改善單次輸入,提示模板與結構化輸出往往已足夠。把三者混為一談,會讓資料、成本與驗收標準全部失焦。
LLM 微調適合客服分類、固定格式摘要、繁體中文專業語氣、NL2SQL 與審核輔助等重複性高的任務。基礎模型已在數萬億通用token上完成訓練,企業不必重做通用能力,而應以少量高品質資料補強任務判斷、輸出格式與領域偏好。
實務上可先建立未微調模型的基準線,再比較 RAG、提示工程與微調後的成功率、延遲及人工修正率。以「一次解決問題的比例平均提升30%以上」作為方向性目標仍不夠,還要定義哪些問題可計入、人工覆核如何判定,才能避免 KPI 被漂亮數字掩蓋。
- 知識頻繁更新時,先評估 RAG 與檢索品質。
- 輸出規則固定且需大量重複執行時,評估微調。
- 每種方案都應與未優化模型建立相同測試集。
用部署、資安與可攜性評估平台,而非只看模型清單
直接答案是:好的 AI模型微調平台必須同時回答資料能放在哪裡、誰能存取、模型能否匯出,以及失敗時如何回滾。控制台是否好用固然重要,但企業更應檢查 Python SDK、REST API、OpenAI 相容介面、IAM 權限、稽核紀錄與刪除流程是否完整。
運算條件也要與模型規模配對,而非盲目追求最大模型。小型任務可從 Qwen2.5-0.5B/1.5B/3B/7B 等級開始驗證;V100/P100/T4(16 GB顯存)雖可支援部分實驗,但序列長度、批次大小與量化方式都會限制可行設定。
若平台只提供封閉式 API,應事先確認微調成果是否能匯出、端點是否可遷移、權重授權是否符合商用需求。特別是醫療、法務與金融情境,資料留存區域、加密、私網連線與角色權限,往往比模型排行榜名次更影響採購決策。
- 確認資料上傳、訓練、推論與備份的區域設定。
- 要求模型、資料集、評測與端點都有可查詢的稽核紀錄。
- 將供應商鎖定、權重匯出與刪除權納入合約檢查。
以 PoC 建立可被管理層採信的選型證據
直接答案是:選平台前先做小範圍 PoC,才能避免把不確定性直接帶進正式開發。PoC 不該只展示聊天效果,而要驗證一項具體假設,例如特定客服意圖的正確分流率、合約條款擷取完整度,或需求預測是否足以改善下單決策。
ALION 的做法是從現場調查與 KPI 定義開始,再以實際資料、接近實務的環境建立原型。這能同時檢查模型精度、使用者操作阻力與資料取得條件;若驗證結果不支持投資,提出「暫時不做」的建議同樣具有商業價值。
成本面可採分段承諾。ALION 的 AI 上游工程訂閱服務為月費 20 萬日圓起,包含每週定期會議、需求定義、架構設計與示範製作;相較於啟動費約 300 萬日圓起的外包模式,較適合在需求仍未釐清時先取得決策依據。
- PoC 的驗收要同時包含品質、速度、資安與使用流程。
- 測試資料必須保留未參與訓練的案例。
- 原型程式碼與設計文件應能延續至正式開發。
資料品質決定 LLM 微調的上限
AI資料標註要先定義判斷規則,再追求資料量
直接答案是:AI資料標註的第一個產物不是標籤,而是可重複執行的標註手冊。手冊應定義任務目標、正反例、模糊案例、拒答條件、敏感資訊處理及升級規則;沒有共同規則,即使累積大量資料,也只會把標註員之間的歧異放大到模型行為。
資料準備與標註往往是整個專案最耗時的環節,平均有高達 80% 的時間都會花在資料準備與標註流程上。對文字任務而言,應將原始對話、指令、理想回答、參考依據與品質狀態分開保存,避免日後無法追查某一筆答案為何被採用。
品質控管應採試標、校準、雙人複核與抽樣稽核的組合。若任務要求误差率<5%,不能只看整體正確率,還要分別檢查高風險類別的漏判與誤判;法務、醫療及客服升級案件尤其需要明確的人工作業邊界。
- 以標註手冊處理術語、台灣用語與中英混雜文本。
- 將拒答、安全回覆與偏好排序列為獨立標註任務。
- 以爭議案例回寫手冊,而不是只修改單筆標籤。
訓練、驗證與測試資料必須隔離管理
直接答案是:資料至少要區分 1.) 訓練 (用於訓練模型),2.) 驗證 (用於監控模型成效並調整設定),以及 3.) 測試 (用於評估微調後模型的最終成效)。若同一份問題在訓練與測試集中重複出現,評測再高也不能證明模型能處理新案例。
資料集格式宜採 JSON 或 JSONL,並替每筆資料保留來源、版本、授權、去識別化狀態與標註人員等中繼資料。這些欄位看似增加前期工作,卻能在發現偏誤、客訴或個資風險時,迅速定位受影響資料與模型版本。
資料量不能取代樣本代表性。幾百條高質量樣例可用於驗證任務方向,數千條則較適合涵蓋更多情境;若平台建議至少包含2000條数据,團隊仍應先檢查類別是否平衡、少數高風險案例是否足夠,以及測試集是否反映真實流量。
- 依使用情境切分資料,避免同一客戶或同一文件跨集合洩漏。
- 保留原始資料與清洗後資料的對照關係。
- 用固定測試集追蹤每次訓練的品質回歸。
合成資料生成應補足長尾案例,不可偽造真實成效
直接答案是:合成資料生成最適合補齊罕見、敏感或難以蒐集的情境,但不能取代真實世界測試。企業可用它生成不同措辭、錯字、跨語言表達、極端輸入與拒答案例,讓模型在上線前看過更多邊界條件,再由領域專家審核有效性。
生成流程應先由真實需求萃取情境矩陣,再設定禁止複製原文、禁止帶入個資、必須附帶來源類型與難度標籤等規則。像 generate_number 10000 與 processes_number 40 只代表批次規模,不能證明資料品質;產出愈快,愈需要抽樣、去重與事實查核。
較穩健的做法是建立「真實資料訓練、合成資料補強、真實資料驗收」的閉環。若合成資料比例過高,模型可能只學會生成器的口吻與偏差;因此應把真實測試集鎖定,並持續檢驗台灣慣用語、專業縮寫與高風險拒答是否仍符合標準。
- 先用合成資料補長尾與安全情境,再以人工審核篩選。
- 不要將生成模型輸出直接視為正確標準答案。
- 紀錄生成提示、來源模型與審核狀態,確保可追溯。
建立可重現的訓練與 AI模型版本管理流程
優先選用參數高效微調,降低首次實驗風險
直接答案是:多數企業首次訓練應從 LoRA (低秩適應) 和 QLoRA (量化低秩適應) 開始,而非直接全參數微調。這類 PEFT 方法只調整少量可訓練參數,通常採用LoRA(低秩適配)或QLoRA等參數高效方法,可把計算成本與訓練時間壓縮一到兩個數量級。
以一個百萬token級別的領域數據集、單卡或雙卡訓練爲例,採用LoRA的微調成本通常僅爲全參數量訓練成本的1%以下。這不表示可以忽略成本,因為資料儲存、實驗失敗、端點常駐、評測與後續回訓,都會構成比單次 GPU 更重要的總持有成本。
初始參數可作為實驗起點,而不是通用答案。例如 learning_rate:5e-5、num_train_epochs:1、per_device_train_batch_size:1、seq_length:128、lora_dim:32 與 lora_alpha:32,必須依資料長度、任務難度與顯存限制調整,並透過驗證集記錄每次改動的結果。
- 先建立小型基準實驗,再擴充資料與訓練時數。
- 同時紀錄基礎模型、資料版本、程式碼提交與超參數。
- 遇到品質下降時,先檢查資料與評測集,再增加 epoch。
AI模型版本管理要涵蓋資料、程式與端點設定
直接答案是:AI模型版本管理不能只替權重取名稱,而要把資料集、標註規範、訓練程式、環境、評測報告與部署設定串成同一條可追溯鏈。當線上品質下降時,團隊才能知道問題來自資料、模型、提示模板,還是檢索與端點設定。
建議以不可變更的版本識別碼記錄每次訓練,並保存模型卡,說明預期用途、限制、已知風險與禁止使用情境。部分平台最多可儲存 10 個檢查點,這代表保留策略必須先設計:哪些中間版本用於診斷,哪些候選版本可以進入灰度發布。
版本管理也要包括回滾演練。正式上線前,應測試端點從新模型切回上一穩定版本所需時間、快取是否需要清除、相依的提示模板是否相容,以及回滾後評測紀錄如何保留。沒有實測過的回滾流程,只是文件上的安心感。
- 每個版本都要對應不可變動的訓練與測試資料快照。
- 把模型卡、風險說明與核准紀錄納入發布條件。
- 建立候選、灰度、正式與退役版本的明確狀態。
以任務評測診斷過度配適與災難性遺忘
直接答案是:模型評估必須以業務任務為核心,而不只看單一自動分數。摘要可觀察 rougeLSum,分類可檢查 F1 與混淆矩陣,客服可評估解決率與人工轉接率;若某次結果為 0.36600753600753694,也必須對照基準線、樣本數與人工審核結果才有意義。
過度配適常表現為訓練損失持續下降、驗證品質卻停滯或變差;災難性遺忘則可能讓模型學會新格式後,原本的通用推理、語言風格或安全拒答能力退化。解法通常是補入代表性資料、調低學習率、減少訓練輪數,而非無限增加訓練。
偏好對齊可使用 DPO,但應先有可信的偏好資料與拒答規則。像 dpo_beta:0.1 只是可測試的設定之一,團隊仍需針對不當輸出、虛構內容與高風險建議建立人工紅隊測試,並將失敗案例加入下一輪資料治理流程。
- 自動評測與人工評測應使用相同的任務定義。
- 測試集需包含正常、長尾、對抗與安全情境。
- 每次發布前比較新舊版本的品質、延遲與成本。
AI模型部署前,先規畫效率、延遲與回滾
AI模型部署應把線上服務需求寫成可驗收規格
直接答案是:AI模型部署的完成條件不是端點能回覆,而是能在指定併發量、延遲、錯誤率與資安限制下穩定回覆。平台選型時,應確認是否支援私網端點、流量控管、身分驗證、日誌遮罩、配額設定,以及藍綠或灰度發布等生產功能。
模型上下文長度會直接影響顯存、延遲與單次成本。若需求只需要短格式分類,使用 max_model_len 8192 或更長設定未必划算;反之,合約與長篇知識問答可能需要較長序列,但要另外評估檢索切片、快取與超時處理,不能只調大上限。
部署驗收建議同時使用離線與線上指標。離線測試確保固定案例不退步,線上則觀察端到端延遲、逾時率、重試率、token 使用量與人工接手率;兩者差距過大時,通常意味著真實輸入分布、前處理或系統整合尚未被評測涵蓋。
- 為不同風險任務設定獨立端點、配額與權限。
- 把逾時、內容過濾與外部工具失敗設計為明確回應。
- 將端點設定與模型版本一起納入發布紀錄。
AI模型量化適合降低推論成本,但必須重做驗證
直接答案是:AI模型量化可以降低記憶體占用與推論成本,卻可能改變格式遵循、長文推理與少數類別品質,因此不能把量化視為無風險的壓縮步驟。企業應針對任務特性比較不同精度設定,再決定是否將量化版本推進正式流量。
量化最適合用在明確、重複且可大量呼叫的任務,例如分類、欄位擷取、固定格式回覆與內部搜尋輔助。對需要複雜推理、長上下文或高精度生成的任務,則應先用代表性測試集檢查品質落差,尤其要測試繁體中文術語、數字、表格與否定句。
評估 AI模型量化不能只看每秒 token 數,也要看單次請求延遲、每次任務總成本、輸出長度與人工修正時間。若模型速度變快但錯誤增加,省下的 GPU 費用可能被後續審核成本抵銷,因此成本計算必須以完成一件業務任務為單位。
- 量化前後使用相同測試集與相同提示模板。
- 特別檢查數字、日期、專有名詞與格式化輸出。
- 以任務完成成本,而非單純吞吐量判斷效益。
AI模型蒸餾可把成熟能力轉為較小的專用模型
直接答案是:AI模型蒸餾適合在高成本模型已經證明任務可行後,把其穩定輸出轉為較小、更快的專用模型。它不是單純複製回答,而是要定義教師模型可教什麼、學生模型需要保留什麼,以及哪些高風險能力不能因壓縮而被犧牲。
蒸餾資料應混合真實標註答案、經審核的教師輸出與反例,並保留不同難度及失敗類型。若教師模型本身有幻覺或偏誤,學生模型會更有效率地複製問題;因此資料審核、事實驗證與拒答規則,仍是蒸餾品質的核心而非附帶工作。
在部署策略上,可讓小模型處理大量低風險請求,複雜或低信心案例再升級至大型模型或人工。這種路由設計能兼顧成本與品質,但前提是要有可靠的信心門檻、例外追蹤與定期抽檢,否則低品質輸出會被悄悄放大。
- 先證明教師模型在目標任務上足夠可靠。
- 蒸餾資料必須包含正例、反例與安全拒答例。
- 以分流規則保留大型模型與人工覆核的安全網。
用 LLMOps平台把監控、回訓與治理串成閉環
LLMOps平台的核心是可觀測性,不只是儀表板
直接答案是:LLMOps平台應讓團隊看見一筆回答從哪個模型版本、提示模板、檢索內容與安全規則而來。只有把追蹤資訊串起來,工程、業務與法遵人員才能針對同一事件討論,而不是各自拿著不同截圖猜測問題來源。
最基本的觀測資料包括請求時間、模型與端點版本、輸入輸出長度、延遲、錯誤碼、工具呼叫結果、內容過濾狀態與使用者回饋。涉及個資或機密資訊時,紀錄必須採遮罩、雜湊或最小化留存,不能為了除錯而無限制保存原始對話。
成熟的 LLMOps平台 也應納入審核工作流:哪些異常可由系統自動處理、哪些需要領域專家複核、誰有權核准新版本,以及如何將已核准的修正案例回流資料集。這會把一次性的模型專案,轉成可持續改善的產品營運能力。
- 追蹤資料要能連回模型、資料集、提示與端點版本。
- 日誌採最小必要原則,並對敏感欄位執行遮罩。
- 建立跨部門的異常分級與核准流程。
AI模型監控要同時看系統健康與回答品質
直接答案是:AI模型監控不能只盯 CPU、GPU 與 API 錯誤率,還要監測回答是否仍符合業務標準。模型可能服務正常、延遲很低,卻因資料分布改變、提示模板更新或外部系統改版而開始答非所問,這正是品質漂移的典型風險。
建議建立三層指標:第一層是可用性與延遲;第二層是格式正確率、引用完整度、拒答正確率等自動品質檢查;第三層則是人工抽樣與使用者回饋。三者搭配才能區分系統故障、模型退化與使用情境改變,並決定是否需要暫停流量。
漂移偵測不必等到重大事故才啟動。當輸入長度、主題分類、語言比例、人工改寫率或負評率持續偏離基準,就應產生告警並抽樣檢視。對高風險流程,建議把模型輸出視為輔助建議,保留人員覆核與可解釋的處理紀錄。
- 系統指標與業務品質指標需在同一發布檢視中討論。
- 對漂移設定門檻、負責人與處理時限。
- 高風險輸出應保留人工覆核及申訴管道。
以回訓節奏與 Go/No-Go 機制控制長期成本
直接答案是:回訓不應按固定日程盲目執行,而要由品質漂移、業務變更與資料累積觸發。多數團隊用4至8周即可完成首輪微調的全流程,常見安排是前兩週整理與清洗數據,隨後兩週完成訓練與評估;正式營運後則應依風險與效益決定回訓頻率。
每次回訓前都要重新檢查資料授權、去識別化、標註規則與測試集污染風險。若只是把所有線上對話直接加入訓練,模型可能學到錯誤答案、惡意提示或過時政策;較安全的方式是先篩選、標註、審核,再以固定測試集驗證是否真的改善。
治理的最後一步是明確的 Go/No-Go 判斷。ALION 的 PoC 流程會將 KPI 驗證結果、正式開發費用與 ROI 整理為決策依據;同一原則也適用於模型回訓:若新版本未能改善關鍵指標,就應保留舊版本並記錄原因,而非為了更新而更新。
- 以品質事件與業務變更作為回訓觸發條件。
- 回訓資料必經過篩選、標註、審核與版本化。
- 每次發布都要有可量化的 Go/No-Go 依據。
總結
選擇AI模型微調平台的關鍵,不在於哪一家平台列出最多模型,而在於能否把資料品質、實驗重現、端點部署、成本控制、資安治理與持續改善串起來。從小型 PoC 開始,以實際資料驗證任務價值,再逐步導入版本管理、監控與回訓,能大幅降低「模型做得出來但現場用不起來」的風險。
重點整理
- 先以任務特性判斷該用提示工程、RAG 或 LLM 微調。
- 資料標註規範、資料切分與測試集治理是模型品質的根本。
- LoRA、QLoRA、量化與蒸餾都必須以任務評測驗證效益。
- 模型、資料、提示、端點與評測結果都要納入版本管理。
- 透過 LLMOps平台 與 AI模型監控,才能讓模型長期維持可控品質。
若團隊仍在評估資料是否足夠、模型是否可行或投資效益是否成立,建議先把一個高價值流程定義成可量測的 PoC。透過現場訪談、實際資料驗證與 Go/No-Go 報告,能在正式投入大規模開發前,先取得更可靠的技術與商業決策依據。
常見問題 FAQ
Q1. AI模型微調平台一定要選雲端服務嗎?
不一定。雲端託管適合需要快速啟動、彈性 GPU 與受管端點的團隊;私有化或自建堆疊則較適合資料不能離開既有環境、需要高度客製網路與權限控制的情境。選擇時應比較資料區域、IAM、權重可攜性、維運能力與總持有成本。
Q2. LLM 微調需要多少資料才值得開始?
沒有固定門檻。幾百條高品質樣例可先驗證任務可行性,數千條資料較能覆蓋更多情境;重點是資料是否一致、具代表性,並且有隔離的驗證與測試集。若標註規則不清楚,增加資料量通常只會增加雜訊。
Q3. AI模型量化後,是否可以直接取代原始模型?
不建議直接取代。量化版本應先以相同測試集檢查任務成功率、格式正確率、長文本品質與安全拒答表現,再透過灰度流量觀察真實延遲與人工修正率。高風險任務宜保留原始模型或人工覆核路徑。
Q4. 為什麼模型上線後還需要 AI模型監控?
因為真實輸入會持續改變,提示模板、檢索資料、外部工具與使用者行為也可能改變。AI模型監控可提早發現延遲、錯誤、品質漂移與安全事件,並把有效的人工回饋整理成下一輪標註、評測與回訓的依據。
Q5. PoC 驗證後若決定不做,是否等於浪費?
不等於浪費。好的 PoC 會留下需求定義、資料盤點、評測基準、風險清單與 ROI 判斷依據,協助團隊避免投入不適合的正式開發。若未達成 KPI,應將原因明確化,作為調整流程、補足資料或暫緩投資的決策證據。