2026.10.29
AI模型推論加速實戰:從延遲、成本到部署的完整策略
AI資訊
AI模型推論加速的核心目標,是在不犧牲業務可接受品質的前提下,讓每次請求更快完成、同一套硬體服務更多使用者,並控制長期營運成本。若聊天機器人首個字回覆太慢、視覺辨識排隊過久,或 GPU 記憶體頻繁不足,問題通常不只出在模型本身,而是整條推論鏈路尚未被系統化檢視。
推論已成為生成式 AI 與智慧應用的主要營運負擔;在高流量服務中,推論環節占比高達 80% 至 90%。線上對話助手需要在數百毫秒內生成回覆,自動駕駛系統的感知推理更必須在數十毫秒內完成。因此,團隊不能只看每秒 token 數,而要同時掌握排隊、載入、前處理、生成與回傳等端到端體驗。
本文會以可落地的方式說明如何定義延遲與吞吐量、選擇 GPU、ASIC、NPU 或 TPU,並運用量化、編譯器、動態批次與快取改善效能。同時也會補足常被忽略的品質驗證、容量規劃與資安治理,最後用小規模 PoC 將技術成果轉換為可供管理層決策的投資證據。
AI模型推論加速先從可量測的效能目標開始
不要只看平均延遲,要拆解使用者真正感受到的等待
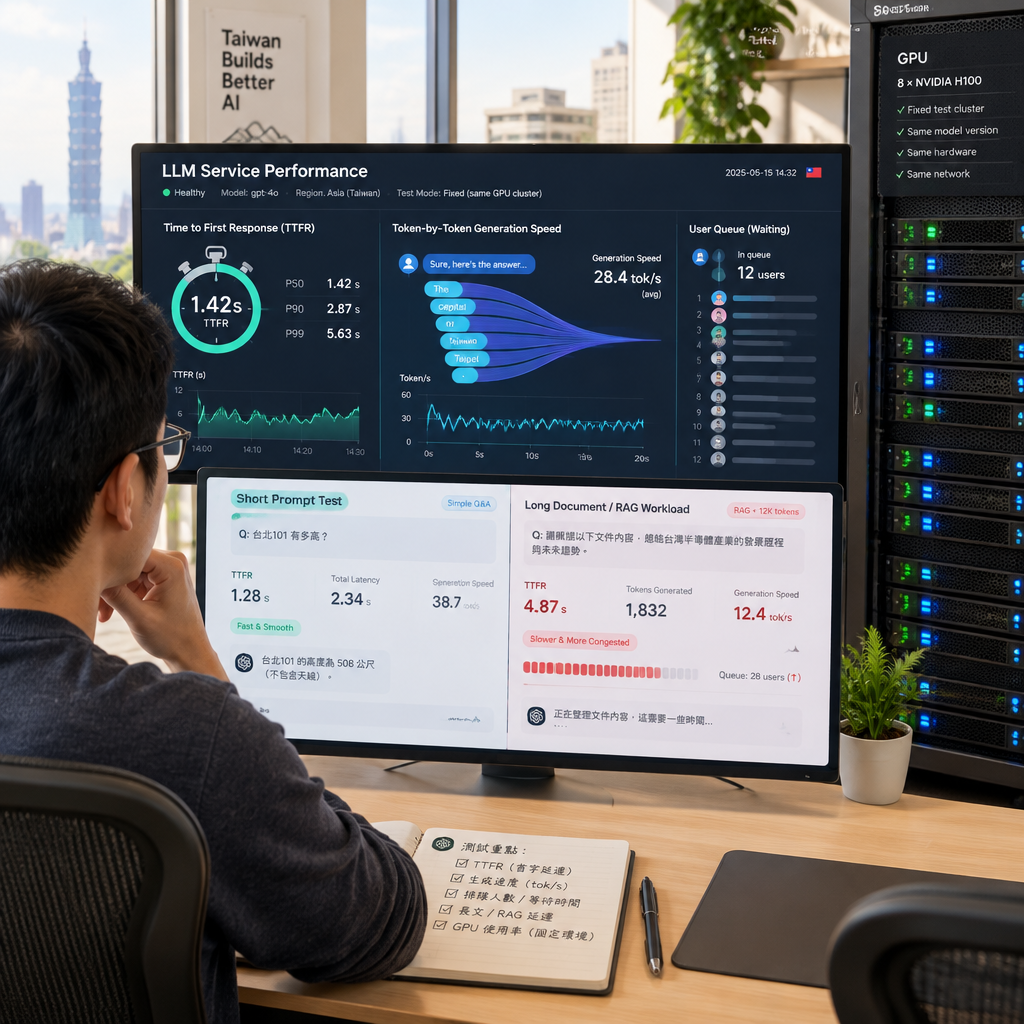
直接答案是:推論效能應至少分成首 token 延遲、每 token 生成時間、端到端延遲與排隊時間。平均值很容易掩蓋尖峰時段的卡頓;例如使用者可能在平均回覆很快的服務中,仍常遇到第一個字等待過久。對串流式 LLM 服務而言,首 token 延遲決定「系統是否有反應」,後續 token 速度才決定閱讀是否流暢。
LLM 還要把 prefill 與 decode 分開觀察。Prefill 主要處理輸入提示與長文件,通常偏重矩陣計算;decode 則逐 token 讀寫 KV Cache,通常更受記憶體頻寬限制。若只用短提示測試,就會錯估 RAG、客服紀錄摘要或繁體中文長文問答的實際負載,導致正式上線後延遲突然惡化。
建議先訂出與情境相符的 SLO,例如一般問答重視首 token 與串流穩定性,工業瑕疵檢測則重視單張影像的端到端時間。測試時固定模型版本、輸入與輸出 token 長度、並發數、批次大小、GPU 型號、驅動與框架版本,才能讓每次最佳化有可比較的基準,而不是只得到一次漂亮的展示數字。
- 記錄 P50、P95、P99 延遲,而非只看平均值。
- 分開量測排隊、前處理、prefill、decode 與回傳時間。
- 將輸入長度、輸出長度與並發數納入壓力測試矩陣。
吞吐量、記憶體與能源效率必須一起看
直接答案是:高吞吐量不等於高服務品質,必須和 GPU 利用率、顯存占用、功耗與錯誤率一起判讀。某些設定能以大批次創造很高的每秒請求數,卻讓單一使用者等待更久;反之,極小批次雖然反應快,卻可能讓昂貴 GPU 長期閒置,形成不必要的單位推理成本。
監控面板至少應呈現請求 QPS、每秒 token、GPU SM 使用率、顯存、KV Cache 命中率、佇列深度與每次請求成本。當 GPU 使用率低但延遲高,常見原因是 CPU 前處理、網路往返或同步等待;當顯存接近上限且延遲震盪,則可能是記憶體碎片、批次策略或快取逐出造成。
公開實務資料顯示,73%的企业在部署AI模型时面临延迟过高的问题。這個比例提醒團隊:效能問題不是部署後才補救的瑣事,而應在需求定義時就把延遲、併發與成本寫成驗收條件。尤其是每日可能處理數百萬甚至數十億次請求的服務,微小的單次改善會累積成明顯的雲端帳單差異。
- 以單位請求、每百萬 token 與每瓦推論量追蹤成本。
- 辨識 GPU 飽和、CPU 瓶頸與網路瓶頸的不同徵兆。
- 將尖峰佇列時間列入服務等級協議。
建立可重現基準,避免被單一展示數據誤導
直接答案是:公平的基準測試必須把環境與工作負載完整公開。單看「快幾倍」沒有決策價值,因為同一模型在不同 CUDA、驅動、量化格式、輸入長度和批次大小下,結果可能完全不同。團隊應將測試腳本與設定檔視為推論工件的一部分,和模型權重一起版控與保存。
以電腦視覺為例,公開比較可同時呈現 8.2ms、12.5ms、15.1ms 的延遲,以及 1200FPS、850FPS、920FPS 的吞吐量;但若未說明影像尺寸、前後處理是否計入、精度格式與批次大小,就不能直接拿來做採購結論。數字適合作為假設起點,不應取代自家資料與自家流量下的驗證。
建議將壓測切成暖機、穩態、尖峰與故障復原四個階段,並記錄溫度、功耗、重試率和 OOM 次數。可參考 MLPerf Inference 的測試精神,將準確度與效能一起驗證;官方資訊可見 https://mlcommons.org/benchmarks/inference/。如此才能分辨最佳化是實質提升,還是把品質、穩定性或成本偷偷轉移到其他環節。
- 每次測試都保存硬體、驅動、框架與模型雜湊值。
- 分別測試暖機、穩態、尖峰與復原情境。
- 將準確度門檻與效能結果成對報告。
模型壓縮與精度策略:先守住任務品質再換取速度
量化是最常見的起點,但校準資料決定成敗
直接答案是:優先評估 FP32→INT8 量化,因為它通常能明顯降低權重與運算負擔,但不可跳過任務級校準。將模型從 FP32 量化到 INT8 可以将计算吞吐量提升约 4 倍,同时将内存占用减少 75%;不過不同層、不同語言與長文本輸入的誤差敏感度不同,不能只用通用資料集判定可上線。
量化校準集應涵蓋實際使用情境,例如繁體中文問答、夾雜英文產品名稱、長篇 RAG 內容、表格與例外格式。BERT-base(NLP任务)可用 GLUE 驗證集檢查任務分數,ResNet-50(CV任务)則可用 ImageNet验证集檢查辨識品質;若企業最在意的是召回率、人工覆核率或安全回答率,也應同步納入專屬指標。
公開案例指出,可将计算量降低40%以上,並能在精度损失<1%的条件下提升推理速度2.3倍。這些成果值得參考,但不代表任何模型都能複製。較安全的作法是設定品質退化門檻、保留高風險請求回退到較高精度模型的路徑,並用線上抽樣持續比對量化前後輸出。ONNX Runtime 的量化指引可見 https://onnxruntime.ai/docs/performance/model-optimizations/quantization.html。
- 以真實提示、真實文件與真實例外案例建立校準集。
- 在離線品質、線上回饋與安全案例三層驗證。
- 保留高精度回退機制,避免一次性全面切換。
剪枝、蒸餾與混合精度適合不同的瓶頸
直接答案是:量化不是唯一手段;若模型本身太大,可結合結構化剪枝、知識蒸餾與混合精度。剪枝移除低重要性的通道、注意力頭或權重群組,結構化方式通常比零散稀疏更容易被硬體與編譯器真正加速;蒸餾則讓較小學生模型學習大模型的輸出分布與任務能力。
例如,將参数量从1.2亿压缩至3000万,若仍維持業務可接受的召回率,往往比單純追求更高階硬體更能降低長期成本。不過模型縮小後,對罕見商品名、專業術語、中文斷詞或長上下文的理解可能下降,因此評估資料不能只有常見題目,必須刻意放入容易失敗的邊界案例。
混合精度則將較敏感的層保留在較高精度,其餘層使用較低精度,以平衡速度與品質。實務上應先找出瓶頸究竟是算力、權重載入還是 KV Cache;若服務被記憶體頻寬限制,單靠剪枝未必有效。對於一個拥有 700 亿参数的模型在 INT8 精度下仍需约 70GB 的内存来存储权重,部署規畫仍須考量多卡切分或更小模型。
- 結構化剪枝較容易轉換為真實執行效能。
- 蒸餾模型要以業務任務,而非只以通用分數驗收。
- 混合精度須依模型層與硬體支援能力調整。
用統一矩陣比較速度、記憶體與誤差
直接答案是:團隊應把速度、記憶體與品質放入同一張決策矩陣,而不是只選最快的配置。以下數值適合作為建立內部測試格式的範例:每個選項都必須同時交代延遲、吞吐量、記憶體及誤差,才能避免用單一指標包裝不適合正式服務的方案。
表格中的數字不能取代自家驗證,尤其對繁體中文長文、混合語言 tokenization 與 RAG 檢索品質更是如此。正式決策前,請將相同的模型、提示集、並發設定和品質門檻套用到所有候選方案,並把 P95 延遲而非僅平均速度列為淘汰依據。
若結果顯示某方案快但誤差明顯升高,應先檢查校準樣本與敏感層設定,而不是立即擴大硬體。可將線上流量分批導入,利用 A/B 測試比較人工轉接率、使用者追問率與任務完成率;這些業務訊號往往比單純 benchmark 更能揭露壓縮後的品質風險。
| 指標 | 方案 A | 方案 B | 方案 C |
|---|---|---|---|
| 推論延遲 | 8.2ms | 12.5ms | 15.1ms |
| 整體吞吐量 | 1200FPS | 850FPS | 920FPS |
| 記憶體占用 | 1.2GB | 1.8GB | 1.5GB |
| 精度差異 | 0.3% | 1.2% | 0.8% |
- 使用同一測試集與相同負載比較候選方案。
- 以 P95 延遲、任務品質與成本作為共同淘汰條件。
- 先小流量驗證,再逐步放大正式流量。
硬體與記憶體架構:依工作負載選擇加速器
GPU、ASIC、TPU 與 NPU 沒有單一最佳答案
直接答案是:硬體應依模型大小、流量型態、延遲目標、部署位置與團隊維運能力選擇。GPU 具備成熟的 CUDA 生態與彈性,適合快速迭代、多模型並存與複雜 LLM;ASIC、TPU 則可能在固定工作負載提供更高能效;邊緣 NPU 適合把即時推論留在裝置端,降低網路往返與敏感資料外傳風險。
NVIDIA H100/H200、AMD MI300 和 RTX 4090 適合不同預算、顯存與部署需求;A100、H100 和 H200 系列則常見於資料中心推論規畫。選型時不要只比較峰值算力,還要確認顯存容量、記憶體頻寬、互連、可取得性、軟體支援與雲端區域,因為大型模型往往首先受限於權重和快取能否放入顯存。
專用晶片的優勢通常出現在長期、穩定且可預測的工作負載。ASIC 推理芯片的能效比(推理次数/瓦特)可以达到同代 GPU 的 2 到 5 倍,但推理芯片的硬件设计周期通常为 2 到 3 年。這表示需求仍在快速變動、模型尚未定型的團隊,可能更適合先以 GPU 與軟體最佳化驗證,再評估是否轉向專用加速器。
- 模型與需求變動大時,GPU 通常保有較高彈性。
- 固定、高量且功耗敏感的工作負載可評估 ASIC 或 TPU。
- 離線、雲端與邊緣端應分別計算延遲與資料治理成本。
KV Cache 與分層儲存是 LLM 延遲的關鍵
直接答案是:長上下文 LLM 的瓶頸常在 KV Cache,而不是模型權重本身。KV Cache 會隨對話輪次與輸入長度成長;若沒有設定 session 上限、逐出政策與可觀測性,併發一升高就可能出現顯存耗盡、請求排隊或頻繁重算,讓使用者感受到回覆忽快忽慢。
可採用 L1(GPU HBM)、L2(服务器主内存DRAM)和L3(外部存储)三级缓存体系,把最常用的內容留在最快層級,並對冷資料設定轉移和失效規則。這類架構的本質不是「永遠保存」,而是在命中率、搬移成本、資料隔離與回應時間之間取得平衡,尤其適合多輪客服與長文件問答。
對儲存型快取或 GPU Direct Storage 而言,頻寬與延遲同樣重要;公開規格可見 40GB/s 带宽 & 100us 时延等目標描述。然而,實際效果仍取決於請求是否可重用快取、模型是否支援分頁管理、資料是否跨租戶隔離。NVIDIA GDS 文件可見 https://docs.nvidia.com/gpudirect-storage/,導入前應先量測命中率與搬移時間。
- 監控 KV Cache 使用量、命中率、逐出次數與重算比例。
- 將長上下文、多人併發與多輪會話列入壓測。
- 為不同租戶與敏感資料設計明確的快取隔離規則。
異構編排可避免昂貴 GPU 被低價工作卡住
直接答案是:把所有處理都丟給 GPU 通常不是最省錢的設計。Tokenization、文件切分、向量檢索、規則過濾、影像解碼與結果格式化,許多工作可在 CPU、NPU 或專用服務完成;GPU 應集中處理真正需要平行矩陣運算的 prefill 與 decode,降低閒置與上下文切換。
模型並行適合單卡無法容納的模型,但會增加跨卡通訊與排程複雜度。若只因模型過大就貿然切分,可能讓互連成為新瓶頸;因此應先評估量化、蒸餾、張量並行與 pipeline parallel 的成本。當輸入短、輸出長時,decode 的記憶體頻寬效益通常更值得優先改善。
在成熟架構中,同相硬體配置下 QPS 提升 2-5 倍、成本下降 30%~50%是可作為驗證假設的目標區間,不應直接視為保證。真正的 TCO 還包括雲端閒置費、資料傳輸、監控、故障切換、人力與模型更新成本;唯有將這些項目納入,才能判斷加速器採購是否真的優於軟體調校或託管端點。
- 將前後處理與模型推論拆分,避免 GPU 做不必要工作。
- 先測試單卡可行性,再導入跨卡平行化。
- 用完整 TCO 衡量,而非只看每小時硬體價格。
推論執行時與服務層:把最佳化變成穩定產能
動態批次要同時保護延遲與吞吐量
直接答案是:動態批次是提升資源利用率的有效方法,但必須設計最長等待時間。服務端把接近時間抵達的請求合併處理,可以減少 GPU 空轉並提高吞吐量;然而,若批次等待窗口過長,低流量使用者反而要為了湊批次而等待,導致首 token 延遲惡化。
對 LLM 而言,continuous batching 能讓不同生成長度的請求更有效共享運算資源,但要特別監控長回覆造成的 head-of-line blocking。應依請求類型分流,例如即時客服、背景摘要、批次標註與內部分析可使用不同佇列、超時設定與優先權,而不是全部共用一條等待隊列。
vLLM 的 paged attention 與排程設計是常見的參考起點,技術文件可見 https://docs.vllm.ai/。不過框架選擇必須驗證模型相容性、串流行為、量化格式、監控介面與升版風險。若服務需要端到端延遲<300ms,就應從 API gateway 到前端串流都納入測試,而非只量 GPU 核心時間。
- 為互動式與批次型請求設計不同佇列。
- 設定最大排隊時間,避免吞吐量犧牲體感延遲。
- 在真實並發與輸出長度下測試排程器。
編譯器與算子最佳化要先確認真正熱點
直接答案是:先用 profiler 找出耗時算子,再決定是否使用 TensorRT、ONNX Runtime、Torch 編譯或自訂 kernel。盲目編譯整個模型可能增加建置與維護成本,卻對端到端延遲改善有限;相反地,若注意力算子、資料格式轉換或 Python 調度才是熱點,針對性處理通常更有效。
計算圖最佳化可融合算子、移除冗餘轉換、選用較適合的 kernel,並降低 CPU 與 GPU 間不必要的資料搬移。公開資料常見「性能提升 2~5 倍」的敘述,但這通常高度依賴模型結構與固定輸入形狀。對可變長度文字、動態影像尺寸或多模態輸入,需確認編譯快取不會反而造成冷啟動與記憶體壓力。
NVIDIA TensorRT 官方文件提供支援格式、精度與部署流程,可見 https://docs.nvidia.com/deeplearning/tensorrt/。建議把原始模型、匯出模型、量化校準檔、編譯設定與測試結果保存為可追溯工件;當模型或驅動更新時,才能快速重建並確認沒有悄悄改變精度、延遲或輸出格式。
- 先以 profiler 確認熱點,再投入編譯最佳化。
- 把引擎檔、校準檔與編譯參數納入版本管理。
- 針對動態輸入測試冷啟動與 shape 快取行為。
自動擴展與可觀測性決定尖峰時是否失守
直接答案是:生產環境要以佇列長度、token 速率、顯存餘裕與 P95 延遲觸發擴展,而不是只看 CPU 使用率。推論端點可能在 CPU 看似輕鬆時,因 KV Cache 用滿或 GPU 已飽和而開始排隊;若擴展只依 CPU 指標,就會太晚發現使用者體驗已經下降。
Serverless、雲端 GPU、專用端點與自建叢集各有適用情境。低頻或需求不確定的服務可先使用彈性方案,避免長期閒置;流量穩定且資料治理要求高的服務,則可評估專用資源。無論選擇何種平台,都要測量模型下載、權重載入、引擎建置和冷啟動,不可只測已暖機的理想狀態。
可靠性還包括故障轉移、限流、重試與降級策略。當高精度模型暫時不可用時,可改用較小模型、縮短最大輸出、停用非必要工具呼叫,或將非即時工作轉入背景佇列;同時需告警 GPU OOM、快取命中下降、錯誤率與提示注入異常,避免效能問題演變為資安與服務中斷事件。
- 以 GPU 與佇列指標驅動自動擴展。
- 量測冷啟動、載入與故障切換,而非只量暖機效能。
- 建立限流、降級與告警,保護核心互動服務。
以 PoC 驗證AI模型推論加速的商業效益與治理
先定義 Go/No-Go,才能避免為加速而加速
直接答案是:推論最佳化應先回答「改善後能帶來什麼業務價值」,再決定技術路線。常見 KPI 可包含 P95 延遲、同時會話數、每百萬 token 成本、人工處理時間、缺貨率或辨識漏檢率。若沒有基準與成功門檻,團隊容易不斷調整模型與硬體,卻無法向決策者說明哪些改善值得投資。
ALION 的 AI PoC 作法強調以最小配置,在實際資料與貼近現場的環境驗證可行性、精度與效益。流程可從現場訪談和 KPI 設定開始,接著明確定義驗證範圍、資料、技術與時程,再製作可運作原型,最後將結果整理為 Go/No-Go 與正式開發所需的 ROI 判斷依據。
需求預測是具體例子:可先用過往銷售與庫存資料比較多個預測模型,再將結果放進下單與生產計畫示範中,試算缺貨與庫存過剩的改善空間。同樣方法也適用於推論服務:先以一條業務流程驗證延遲、品質與成本是否達標,再決定是否擴展到全公司,而非一開始就全面重構平台。
- KPI 必須同時涵蓋效能、品質、成本與現場採用率。
- 用實際資料驗證,避免只在理想資料集得到漂亮結果。
- PoC 的結論可以是暫緩,這也是降低投資風險的成果。
把品質、安全與資料治理寫進驗收條件
直接答案是:速度提升若造成敏感資料外洩、回答品質失控或權限混亂,就不算成功。多租戶服務要隔離模型、快取與日誌;RAG 系統則要控管文件權限、檢索範圍、引用來源與保留期限。尤其當 KV Cache、提示內容或檢索片段被共享處理時,資料邊界必須在架構與測試層面被明確驗證。
提示注入與工具調用風險也應納入推論鏈路。加速可能提高處理量,卻也可能更快放大不當請求;因此需在模型前後配置輸入檢查、權限判斷、輸出過濾與可稽核日誌。這些控制項會增加少量延遲,但相較於事後調查資料事故,通常是必要的營運成本。
品質治理則應建立版本化評估:每次更換模型、量化格式、檢索器、驅動或服務框架,都用固定安全題、繁體中文任務集與效能測試重新檢查。將模型卡、資料來源、校準集、已知限制與回退條件整理成文件,可讓工程、法務、資安與業務部門對「可上線」形成共同標準。
- 隔離租戶快取、權重存取與推論日誌。
- 測試提示注入、越權檢索與不安全工具呼叫。
- 將模型版本與品質、安全、效能結果一併留存。
以小規模訂閱式支援降低上游決策成本
直接答案是:若內部缺少 AI 架構與效能調校經驗,可先採小規模上游工程支援,而非在可行性未明前投入完整開發。ALION 提供月費 20 萬日圓起的 AI 上游工程訂閱,內容包含 AI 顧問、需求定義、設計與示範製作,適合需要先釐清資料、KPI、模型選型與推論環境的團隊。
相較之下,聘僱 CTO 級人才的月薪 80〜150 萬日圓,外包開發的啟動費約 300 萬日圓起。這些數字不代表所有企業都應選同一方案,而是提醒決策者比較的不只是開發報價,還包括需求反覆、交接損耗、錯誤硬體採購與模型重做的風險;先把最不確定的假設驗證掉,通常更有利於控制總投入。
若後續進入正式開發,PoC 的需求文件、架構設計、基準腳本與原型程式應能延續使用,避免「做完就丟」。以 1,000 萬日圓規模的開發案而言,上游工程約需 3 個月(約 60 萬日圓);將成果設計為可銜接資產,能讓後續敏捷迭代聚焦在真正的業務差異,而非重新理解需求。
- 先以小範圍驗證技術、資料與現場採用風險。
- 將基準腳本、文件與原型保留為正式開發資產。
- 以總成本與決策速度評估外部支援方案。
總結
AI模型推論加速不是單點技術,而是模型壓縮、硬體記憶體、執行時排程、可觀測性與業務驗收共同構成的系統工程。最可靠的路徑不是直接採購最快硬體,而是先以真實提示、真實資料與真實併發建立基準,再逐一驗證量化、快取、批次與部署架構帶來的效益及風險。
重點整理
- 先量測首 token、P95、排隊、吞吐量、顯存與單位成本,再談最佳化。
- 量化與壓縮必須以繁體中文、長文本與實際任務資料驗證品質。
- GPU、TPU、ASIC 與 NPU 的選擇取決於工作負載穩定度、延遲目標與治理需求。
- KV Cache、動態批次、冷啟動與尖峰排隊是 LLM 上線後的關鍵營運議題。
- 透過可延續的 PoC 建立 Go/No-Go 證據,可降低大規模導入風險。
若您的團隊已遇到回覆變慢、GPU 成本攀升、模型難以上線或不知道該從量化、硬體還是服務架構著手,建議先選定一個高價值流程進行基準測試與 PoC。以明確 KPI 驗證速度、品質和 ROI,再擴大部署,才能讓推論效能真正轉化為可持續的業務成果。
常見問題 FAQ
Q1. AI模型推論加速最優先應該做量化還是換 GPU?
應先建立基準並找出瓶頸。若顯存或記憶體頻寬不足,量化可能很有效;若 CPU 前處理、排隊或網路是瓶頸,直接換 GPU 的改善可能有限。請以端到端延遲、顯存、GPU 使用率與品質驗證結果決定優先順序。
Q2. INT8 量化會不會讓繁體中文回答品質明顯變差?
有可能,因此不能只看通用評測。請用繁體中文、混合中英文術語、長文本與高風險問題建立校準及驗證集,設定可接受的品質退化門檻;對敏感請求保留較高精度模型或回退路徑。
Q3. LLM 推論服務為什麼在尖峰時特別慢?
常見原因包括請求佇列累積、KV Cache 佔滿顯存、動態批次等待過久、長輸出阻塞短請求,以及冷啟動。建議檢查 P95 延遲、佇列深度、快取命中率、顯存與不同請求類型的資源分配。
Q4. PoC 驗證推論效能時需要準備哪些資料?
至少準備實際提示或影像、代表性輸入與輸出長度、預期併發數、現行流程耗時、品質判定標準及成本資料。若涉及企業文件或客戶資料,也應先完成權限、保密協議與測試環境的安全規畫。
Q5. 推論加速後如何確認真的值得正式導入?
除了速度,還要比較任務完成率、人工覆核率、每次請求成本、尖峰穩定性與維運負擔。將結果對照事先定義的 KPI,產出 Go/No-Go 判斷與擴大部署所需資源,才能避免只因展示數字漂亮就投入大量預算。