2026.11.16
AI模型選型怎麼做:從需求驗證到採購決策指南
AI資訊
AI模型選型的關鍵,不是找出「最強」模型,而是找出能在您的資料、流程、預算與風險限制下,穩定創造業務價值的組合。許多企業一開始依照公開排行榜挑選模型,上線後才發現回應延遲、人工覆核量、資料權限與 Token 成本都超出預期,最後讓原本有潛力的專案停在展示階段。
對製造、零售、貿易與專業服務業而言,生成式AI應用通常會碰到文件格式不一、術語複雜、跨部門權限與既有 ERP、CRM 或知識庫整合等問題。因此,企業 AI 導入評估不能只由資訊部門決定,也不能只聽 AI 系統廠商的產品展示;業務、資安、法務、採購與現場使用者都必須共同定義成功條件。
本篇將依序說明如何進行AI需求訪談、建立可比較的 LLM模型評估 方法、設計以真實資料為核心的 PoC、完成 AI採購評估,以及判斷 SaaS、API 與私有化LLM部署的適用情境。您也會取得模型路由、三年期總持有成本、治理門檻與正式營運前的實務檢核方向。
AI模型選型先從業務問題與成功門檻開始
用AI需求訪談把模糊想法轉成可驗證任務
直接答案是:AI需求訪談必須先問「哪個工作決策要變快、變準或變省」,而不是先問要用哪一家模型。以企業知識庫聊天機器人為例,訪談應拆出使用者身分、提問類型、資料來源、正確答案定義與錯誤後果;若採購人員問錯合約條款,風險與一般 FAQ 答錯完全不同。
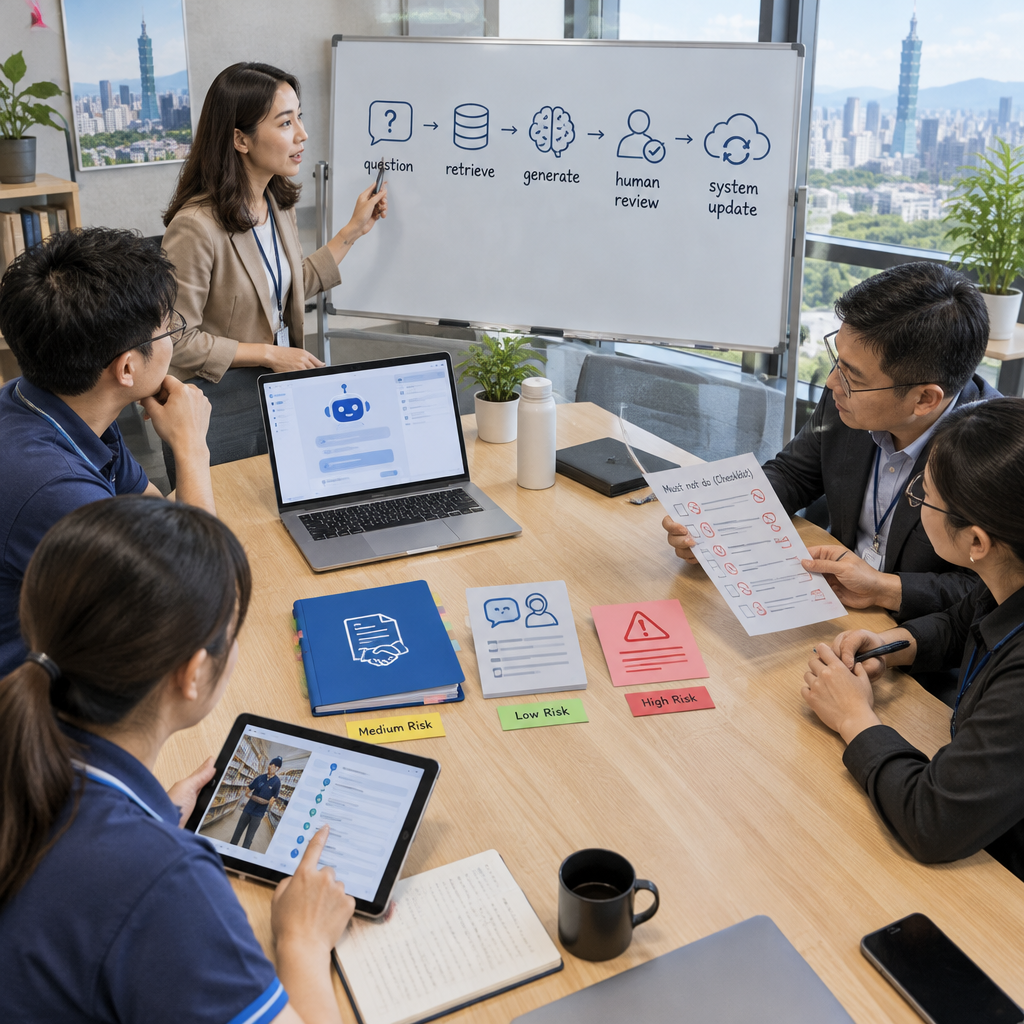
建議由業務主管、第一線人員、資訊、資安與法務共同盤點流程。訪談時要實際走一遍從提問、檢索、生成、人工確認到回寫系統的路徑,並記下例外情境。這能避免需求只停留在「做一個聊天機器人」,卻沒有界定誰能看什麼資料、何時必須轉人工。
有效的 AI需求訪談也要列出不做事項,例如不讓模型直接修改訂單、不在未核准資料中搜尋、不把機密內容送往外部服務。將這些條件寫成需求與驗收條款,後續的模型比較、提示詞設計與 AI採購評估才有一致基準,專案也較不會因範圍膨脹而失控。
- 把需求改寫為「使用者、任務、輸入、輸出、風險、KPI」六欄。
- 為每個高風險流程指定業務負責人與最終覆核者。
- 先定義禁止行為,再討論自動化程度。
設定業務 KPI,而非只追求公開榜單分數
直接答案是:模型是否合格,要由業務 KPI 與風險門檻共同決定。公開 Benchmark 可用於初篩,但它無法代表您的產品料號、中文合約、內部縮寫或現場語句。以客服摘要為例,真正重要的可能是摘要是否漏掉客訴承諾、是否可在指定秒數內完成,以及主管是否願意直接採用。
在製造業需求預測情境中,模型價值不只在預測誤差,而在是否能協助降低缺貨、庫存過剩與緊急追料。曾有供應鏈案例把月度報表產出周期由 5 個工作日縮短至 2 小時,單家供應商風險核查由 2 小時壓縮至 5 分鐘,緊急追料事件同比下降 82%。這類成果才是投資審核可理解的語言。
建議把 KPI 分成品質、效率、風險與採用四類。品質可設定引用正確率,效率可看平均處理時間,風險可看敏感資料誤曝率,採用則看實際使用率與人工覆核率。若只有模型回答看起來流暢,卻無法改善任一指標,便不應進入正式導入。
- 品質:正確性、引用完整度、任務完成率。
- 效率:延遲、每件處理時間、每小時處理的請求數。
- 風險:越權存取、提示注入、個資與機密資訊洩漏。
- 採用:使用率、人工修正率、現場人員滿意度。
建立跨部門的Go/No-Go決策機制
直接答案是:企業 AI 導入評估必須在 PoC 前就指定誰可以核准、誰可以否決。業務部門應確認流程價值與使用情境;資訊團隊確認整合與維運能力;資安及法務確認資料用途、留存、跨境與權限;採購則確認供應商承諾、價格與退出條件。這比最後才召開一次評選會更可靠。
實務上可設三道門檻:第一道是需求與資料是否足以驗證,第二道是 PoC 是否跨過 KPI,第三道才是正式營運的合規、服務等級與總成本審查。若現場無法提供代表性資料,或成功定義仍在反覆變動,應先停在需求整理,而不是急著購買模型額度。
小規模概念驗證的價值,也包含提出「暫時不做」的判斷。以實際資料驗證後若發現資料品質不足、人工覆核成本過高或流程尚未標準化,暫緩可避免後續重工。這種以證據支持 Go/No-Go 的機制,是 AI模型選型 與一般軟體採購最重要的差異。
- 業務否決條件:無法改善既定 KPI 或現場不願採用。
- 資安否決條件:資料流向、保留規則或權限稽核無法滿足要求。
- 工程否決條件:無法整合既有身分驗證、資料來源或監控機制。
LLM模型評估要以真實樣本與分層指標比較
用20–30條真實樣本建立第一輪測試集
直接答案是:第一輪 LLM模型評估 可先拿 20–30 條真實業務樣本,快速辨識候選模型是否具備基本適配性。樣本應涵蓋常見任務、長文件、模糊提問、跨部門術語、錯誤輸入與高風險案例;不要只挑容易回答的題目,否則 Demo 成績會掩蓋正式上線後的失敗模式。
測試資料應保留輸入、正確輸出、引用證據、允許的回答範圍與評分規則。以知識庫問答為例,不能只評估回答像不像人,還要檢查是否從核准來源檢索、是否正確引用段落、找不到答案時是否明確拒答。這也讓不同模型、不同提示詞與不同 RAG 設定能在同一把尺上比較。
公開能力測試仍可作為背景資訊。例如部分評測涵蓋 57 个学科的选择题、~14K 题與 8.5K 道小学数学应用题,但這些題目不能取代企業專屬測試集。建議以領域、語言、文件長度與風險等級分層報告,避免平均分數漂亮,卻把少數關鍵任務失敗藏起來。
- 每條樣本都要標註業務情境、風險等級與正確證據。
- 把無法回答、應轉人工與可自動完成分開計分。
- 測試集應持續新增正式營運中的真實失敗案例。
同時測品質、成本、延遲與安全表現
直接答案是:LLM模型評估至少應把品質、延遲、成本、安全與可靠性放在同一張評分卡。品質可由人工盲評與規則評分並用;例如每個提示一個數字分數 (例如 1 到 5),或每個提示的數值分數 (例如 0.0 至 1.0)。模型評審可加速測試,但高風險個案仍需專家抽驗。
評分工具必須記錄版本與方法,否則結果無法重現。例如評測設定可能顯示 Defaulted to `gpt-5.4`.,方法標記為 Method: bench-align-v5.8-2026-09-30.;這些資訊都應寫入實驗紀錄。若只保留最終分數,模型更新、提示詞變更或檢索庫重建後,就無從判斷成效改變的原因。
測試結果不應只公布平均值。某次試驗可能得到 83.33% 與 0.00% 兩種截然不同的子項表現,代表特定類型任務完全失敗,即使整體平均仍可接受。若業務規則要求契約條款不得漏引,該類任務就應設硬性下限,而不是被其他簡單問題拉高總分。
- 品質:正確性、相關性、接地性、格式遵循與拒答品質。
- 效能:平均與 P95 延遲、吞吐量、逾時率、Token 使用量。
- 安全:提示注入成功率、PII 洩漏、越權工具呼叫與不安全輸出。
以通過率門檻避免為小幅提升付出過高成本
直接答案是:當候選模型已能穩定跨過業務門檻,就應優先比較成本與營運風險,而非無限追逐最高能力。實務上可設定「找到通過率跨過 85% 的那一檔就停下」,再以人工覆核量、延遲、資料治理與供應商條件決定最終方案。這可避免為少數邊際題目支付大幅溢價。
成本比較必須按輸入、輸出、快取、重試與上下文長度拆開看。市場資料中,DeepSeek V4.1 Flash 輸出價 $1.2,Claude Opus 5.5 輸出價 $20;另有比較指出 Claude Opus 5.5 比 MiMo-V2.6-Pro 貴 23 倍(輸出價 $20 對 $0.87)。這些價差會在大量客服、摘要或 Agent 任務中被放大。
但價格低不等於總成本低。資料也曾列舉一個日均消耗 10 億輸出 token 的應用,用前者每天燒 2 萬美元,用後者每天燒 1200 美元;由於計費口徑可能涉及快取、折扣或路由設定,企業不能直接套用,應以自家 Token 分布與真實呼叫紀錄重算。
- 先設定品質與安全最低門檻,再優化每件任務成本。
- 將快取命中率、重試率與人工覆核工時納入成本模型。
- 針對簡單、複雜與高風險任務設定不同模型等級。
用PoC驗證生成式AI應用是否值得正式投資
AI PoC設計要驗證假設,而不是做縮小版成品
直接答案是:好的 AI PoC設計只驗證一到三個最關鍵假設,例如「文件檢索是否足以支援客服」、「模型能否讀懂工廠術語」或「預測結果能否改善下單決策」。它不是把所有功能先做一遍,而是用最小範圍取得是否投入正式開發的證據,降低需求模糊時直接開發的風險。
PoC 應從 KPI、資料、技術、使用者與時程五項明確界定範圍。以庫存需求預測為例,可比較多個預測模型,並把結果帶入下單與生產計畫的示範畫面,讓主管看到結果如何影響決策,而不只是看一個誤差數字。此做法也能及早揭露資料缺漏與流程例外。
驗證環境應盡量貼近正式營運,但先採最小權限與去識別資料。若日後需要私有化LLM部署,也可在 PoC 階段測試模型載入、GPU 資源、向量資料庫與身分驗證整合。把設計文件、測試資料與原型程式碼保留下來,才能讓 PoC 成為可延續的資產。
- 先寫下要證明與要推翻的假設。
- 將資料品質與人工流程列為驗證對象,不只測模型。
- 每週檢視結果,必要時調整範圍而非硬撐原計畫。
以現場使用體驗檢查最後一哩路
直接答案是:模型準確不代表現場會使用,因此 PoC 必須安排真實使用者完成端到端任務。生成式AI應用若需要使用者反覆複製貼上、等待過久、看不懂引用來源或無法修正答案,即使 Benchmark 分數高,也會在正式營運後被繞過,形成昂貴卻閒置的系統。
測試時請觀察使用者是否知道何時該信任、何時該覆核模型。以採購合約助理為例,介面應清楚顯示來源段落、文件版本、信心提示與回報錯誤按鈕;對高風險回答,系統更應要求人工確認。這些 UX 與流程控制,通常比換成更大的模型更能提升實際可靠性。
PoC 報告應同時呈現成功案例與失敗案例。若模型對特定供應商格式、掃描 PDF 或中英混雜內容表現不佳,不應隱藏,而要提出改善路徑,例如 OCR 前處理、文件分類、檢索切分調整或改由人工處理。可解釋的限制,反而能提高經營層對正式投資的信任。
- 讓第一線人員以自己的案例操作原型。
- 記錄完成任務時間、修正步驟與放棄原因。
- 對高風險輸出設計引用、覆核與回報機制。
把PoC結果轉成投資判斷與正式藍圖
直接答案是:PoC 結束時應產出 Go、No-Go 或再次驗證三種明確結論,並附上 KPI 結果、風險清單、正式架構與預算範圍。若只交付可展示的原型,決策者仍無法判斷後續人力、資料治理、模型費用與維運責任,專案很容易在簽核階段停滯。
以正式化角度看,PoC 成功指標除了任務通過率,還應包括導入時間、教育訓練、人工覆核、錯誤回報與維運可行性。過去有案例顯示,車間平均斷線率 8.6%,部分車間最高超過 10%;最終斷線率平均下降 3.3%,最多下降 7.3%,人工統計耗時從每天約 2.5 小時降到 0.5 小時。
這類量化證據可轉換為財務與營運語言,但不能忽略例外條件。每小時自動刷新和每日 08:00 的 T+1 分析日報,適合資料更新節奏明確的場景;若決策必須即時完成,就要另外驗證資料延遲、網路斷線與備援流程。PoC 的目標是看清限制,而不是只證明 AI 能做事。
- 交付 KPI 基線、PoC 結果、風險與改善優先順序。
- 估算正式版所需資料管線、權限、監控與人力。
- 用 Go/No-Go 文件取代只憑簡報印象的投資決策。
AI採購評估要比較總成本、供應商能力與退出風險
以加權評分卡完成AI採購評估
直接答案是:AI採購評估應採用跨產品類型都能使用的加權評分卡,而非只比功能清單。建議將業務價值、模型品質、資安合規、整合能力、總持有成本、供應商服務與退出風險分項評分,再由跨部門依角色設定權重。這能降低單一決策者偏好特定品牌所造成的偏差。
評分前要先設淘汰條件,例如無法提供稽核紀錄、資料使用條款不符、無法串接既有身分驗證、或不支援必要部署模式。通過淘汰條件後,才比較候選方案的加權分數。對高風險場景,安全與可追溯性應高於介面功能;對大量低風險內容處理,單位成本與吞吐量可能更重要。
供應商 Demo 僅能用來理解產品,不應直接作為採購證據。曾出現三分鐘自動生成200個UI用例的展示,但在登入頁多語言切換+權限動態渲染+表格分頁懶加載組合操作下,工具漏報了3個關鍵視覺錯位,誤報了7次“按鈕不可點擊”。因此驗收必須回到企業自己的流程與樣本。
| 評估面向 | 建議檢核內容 | 常見否決條件 |
|---|---|---|
| 業務價值 | KPI改善、採用率 | 無明確使用流程 |
| 技術適配 | 品質、延遲、整合 | 無法串接既有系統 |
| 資安合規 | 權限、稽核、資料流 | 資料用途不透明 |
| 總持有成本 | 授權、Token、維運 | 成本無法預估 |
| 供應商能力 | SLA、支援、退出 | 無資料匯出機制 |
- 先設定必須符合的法遵、部署與整合條件。
- 再用加權分數比較價值、品質、成本與服務能力。
- 要求候選廠商用企業樣本執行相同的測試腳本。
用三年期TCO看穿表面價格
直接答案是:比較 AI 系統廠商 時,必須把三年期總持有成本納入,而不是只看月費或單價。TCO 至少要包括訂閱或 API、雲端運算、資料清理、系統整合、測試、教育訓練、人工覆核、監控、模型更新、資安稽核與退出遷移。Token 價格只是其中一小部分。
成本常被低估的環節是人工處理。以 AI 視覺測試為例,人工復核成本不能超過測試工程師日均工時的15%,並可用日均誤報數 × 單條復核耗時(分鐘) ÷ 60 ≤ 1.2小時作為控制線。若模型誤報造成工程師每天都要修規則,原本的自動化效益會很快被吃掉。
也要要求供應商拆出擴充情境下的成本:使用者增加、文件量翻倍、上下文變長或高峰流量出現時,費用如何變動。部分服務提供 roughly 50% off of cached input tokens 或 up to 100% off 的特定折抵,但是否適用取決於快取命中與計費條款,不能把行銷折扣當成固定財務假設。
- 建立基本、成長與高峰三種使用量情境。
- 把人工覆核與資料整理人力折算為每件任務成本。
- 在合約中確認價格調整、超額用量與資料匯出費用。
在合約與RFP中寫入驗收、服務與退出條款
直接答案是:RFP 與合約要把 PoC 的成功條件轉為可驗收條款,避免正式採購後才爭論「可用」的意思。條款應寫明測試資料範圍、最低品質、延遲、可用性、資安事件通報、模型或服務版本變更流程、責任分界,以及未達標時的補救與終止機制。
對 AI 系統廠商而言,最重要的不只是能否提供模型,也包括是否能協助整合既有資料來源、監控使用量、處理模型漂移與完成知識移轉。若由多家廠商分別負責 RAG、模型 API、前端與資料平台,企業更要指定單一整合責任窗口,否則問題發生時容易互相推責。
退出條款尤其容易被忽略。企業應確認可否匯出提示詞、評估集、向量索引、對話紀錄、設定檔與使用紀錄,並確認轉換格式、時程與費用。保留這些資產,未來更換模型或轉向私有化LLM部署時,才能降低鎖定風險,也能持續沿用累積的評估能力。
- 將品質、延遲、資安與支援等級寫入驗收條款。
- 要求供應商預告重大模型與計費變更。
- 確認資料、設定、評估資產的匯出權利與格式。
私有化LLM部署與模型路由的營運選擇
依資料敏感度選擇SaaS、API或私有化LLM部署
直接答案是:私有化LLM部署不必是所有企業的預設答案,應依資料敏感度、延遲、客製需求、流量規模與維運能力選擇。SaaS 啟動快,適合標準化、低敏感流程;API 彈性較高,適合整合既有系統;私有化則適合資料不得出域、需掌控模型版本或有大量固定工作負載的情境。
企業不能只以「本地部署比較安全」作結論。私有化仍需管理身分驗證、金鑰、網段隔離、模型權重來源、漏洞修補、日誌留存、GPU 容量與備援。若沒有相應的 LLMOps 能力,部署在內網的模型可能仍有權限過大、提示注入或未受監控的資料存取風險。
不同產品的部署限制也會直接影響選型。例如 FineBI(AI 原生版)是 AI 原生的數據分析平台,僅提供 SaaS 雲服務、不支持私有化;DORA 是獨立的數據智能體平台,支持本地化和私有化部署。這類條件應在初期企業 AI 導入評估就確認,而不是簽約後才發現架構不符。
- 低敏感且快速試驗:可優先評估 SaaS。
- 需串接系統與彈性控制:可評估 API 架構。
- 高敏感或嚴格資料主權:評估私有化與維運能力。
用模型路由兼顧品質、速度與成本
直接答案是:大多數企業不應把所有任務固定交給同一模型,而應建立模型路由。簡單分類、格式整理或常見問答可先交給輕量模型;複雜推理、長文件比對或高風險回覆再升級至能力較強的模型。路由規則可依任務類型、資料敏感度、上下文長度、信心分數與服務負載決定。
成本效益的差異很大。資料顯示,46.3 分的 MiMo-V2.6-Pro 每分智能成本 $0.019,57.6 分的 Claude Opus 5.5 是 $0.347,相差 18 倍,而智能指數只高了 11.3 分。這不代表便宜模型必然較好,但提醒企業:若低風險工作已跨過 KPI,未必需要全數使用最高階模型。
路由必須搭配降級與備援策略。例如高階模型逾時、限流或服務異常時,可改由次級模型生成草稿並標示需人工覆核;若檢索證據不足,則不要自動切到更強模型硬答,而應回覆找不到核准資料。這種以任務風險為核心的設計,才是穩定營運的基礎。
- 先把任務分為簡單、複雜、高風險三個等級。
- 設定升級、降級、逾時與人工接手的明確規則。
- 定期檢視每條路由的品質、成本與失敗原因。
以LLMOps持續管理版本、漂移與安全風險
直接答案是:模型上線後才是真正的開始,企業必須用 LLMOps 持續監控品質、成本、資安事件與模型漂移。模型供應商更新版本、知識庫文件改版、使用者提問習慣變化,或工具介面調整,都可能讓原本通過的流程退化。每次變更都應先跑回歸測試,再逐步釋出。
營運儀表板至少應追蹤任務通過率、引用正確率、拒答率、提示注入嘗試、P95 延遲、每件成本、Token 使用、人工覆核率與使用者回饋。對於 Agent,還要記錄工具呼叫軌跡與權限決策,才能在錯誤發生後還原原因並修正護欄。
建議建立發布門檻:如果高風險測試集低於既定分數、安全測試出現重大失敗,或人工覆核成本超標,就不得升版。曾有評測資料記錄 66.7% 與日期 2026-11-07 (世界標準時間)。;這類帶有時間戳與版本脈絡的紀錄,才有助於判斷結果是模型退化、資料變動,還是測試方法改變。
- 將測試集與提示詞納入版本控制。
- 模型、檢索庫、權限或工具變更後都要回歸測試。
- 建立資安、業務與工程共同簽核的發布門檻。
總結
AI模型選型的本質是投資與風險管理,不是單次的模型排行榜競賽。從AI需求訪談開始,以真實樣本完成 LLM模型評估,再用 PoC 驗證流程價值、以 AI採購評估控制三年期成本與合約風險,最後透過模型路由、私有化LLM部署選項與 LLMOps 維持營運品質,企業才能把生成式AI應用從展示帶入日常作業。
重點整理
- 先定義業務 KPI、資料範圍與否決條件,再開始比較模型。
- 以真實資料做分層測試,避免公開榜單與平均分數誤導決策。
- PoC 必須交付 Go/No-Go 證據、正式架構與風險清單。
- 採購時比較三年期 TCO、服務能力、資料治理與退出機制。
- 正式上線後持續以 LLMOps 管理版本、漂移、安全與成本。
若您的團隊正準備從概念走向驗證,建議先選定一個高頻、可量化且風險可控的流程,安排跨部門訪談並整理 20–30 條真實樣本。先用小範圍 PoC 找到可跨過 KPI 的模型與架構,再決定是否擴大採購或進行正式開發,能大幅降低後續重工與投資不確定性。
常見問題 FAQ
Q1. AI模型選型時,公開排行榜第一名就是最佳選擇嗎?
不一定。排行榜可做初篩,但企業應以真實任務的正確率、延遲、資料治理、人工覆核與單位成本評估。只要較低成本模型已跨過既定 KPI,通常更適合大規模營運。
Q2. PoC要做到什麼程度才可以進入正式開發?
當 PoC 已證明業務 KPI、資料可用性、使用者流程、資安控制與預估總成本都可接受時,便可進入正式設計。若只證明模型能回答問題,仍不足以支撐正式投資。
Q3. 私有化LLM部署一定比雲端服務安全嗎?
不一定。私有化可增加資料與版本控制能力,但仍需要完善的權限、金鑰、網路隔離、日誌、修補與監控。若缺乏維運能力,內部部署同樣可能產生資安風險。
Q4. 如何避免模型更新後讓企業聊天機器人品質下降?
請建立 LLMOps 流程,將提示詞、模型版本、知識庫與測試集納入版本控制。每次更新前跑回歸與安全測試,只有通過既定發布門檻才逐步上線。
Q5. AI採購評估最常漏掉哪一類成本?
最常被忽略的是資料清理、系統整合、人工覆核、教育訓練、監控、模型更新與退出遷移成本。建議以三年期 TCO 比較候選方案,避免只用月費或 API 單價做決策。