2026.10.06
AI模型版本管理:讓模型可追溯、可部署與可回滾的實務指南
AI資訊
AI模型版本管理不是替模型檔案加上 v1、v2 的命名規則,而是讓團隊能明確回答「目前線上用的是哪個模型、用了哪些資料、為何核准上線、出了問題如何復原」。當模型、提示詞、向量知識庫與部署設定同時變動時,缺少可追溯紀錄,往往會讓一次看似簡單的更新,演變成難以定位責任與原因的營運事故。
企業將生成式 AI 導入客服、知識搜尋、需求預測或文件審查後,管理對象不再只有程式碼。模型權重、訓練資料、LLM 微調參數、提示詞、RAG 檢索設定、容器映像與權限規則,都會改變最終輸出。研究調查指出,只有一半(約 48%)的 AI 項目投入生產。許多團隊並非做不出原型,而是卡在可重現、可部署與可維運的工程化環節。
本文將以模型生命週期為主線,說明版本、資料與模型註冊庫的差異,建立候選到生產的品質關卡,並串接AI模型部署、AI模型監控、LLM可觀測性與 AI資料治理。文中也會提供平台選型、漸進發布、私有化環境與 PoC 驗證做法,讓技術與業務團隊都能以同一套證據做出 Go/No-Go 決策。
AI模型版本管理的定義與可追溯範圍
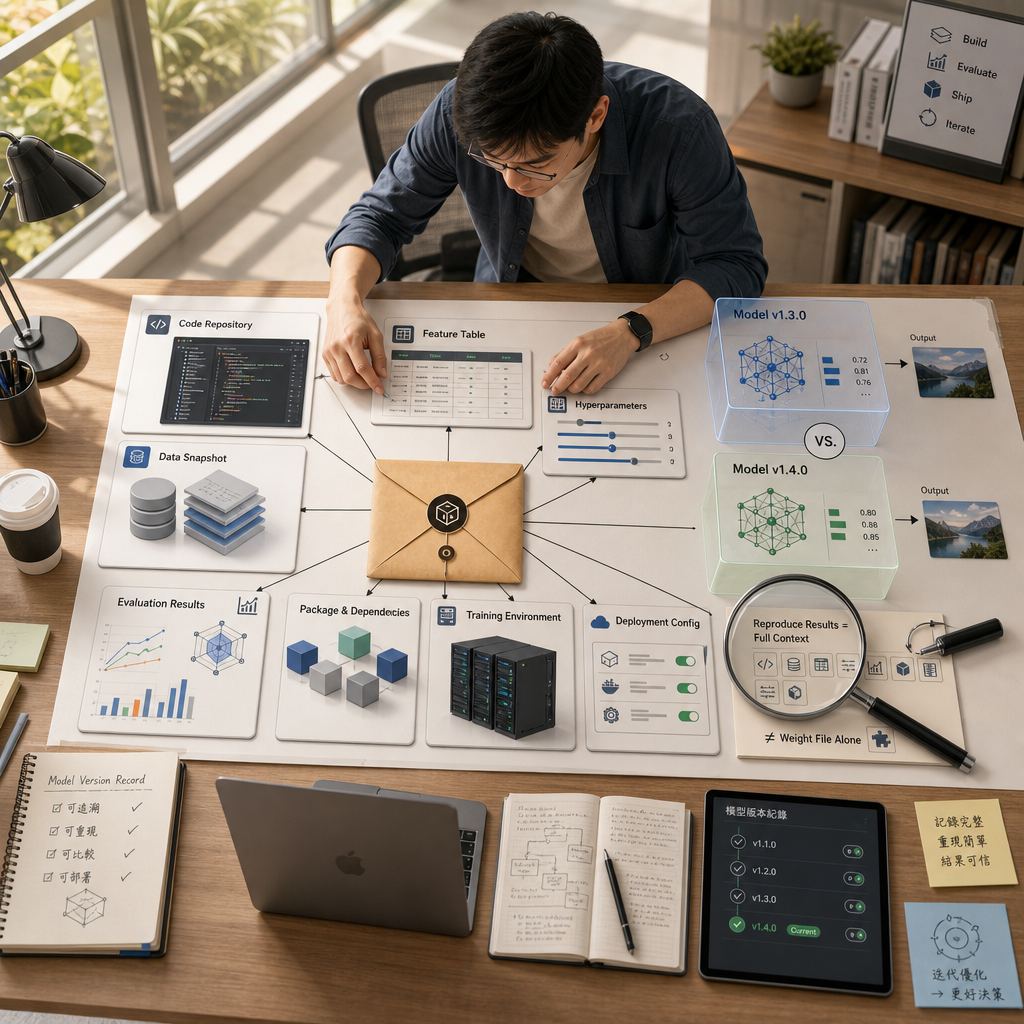
版本管理要管理的是可重現的決策證據
直接來說,AI模型版本管理的核心是把每一次模型行為變更,轉成可查驗、可重建、可核准的資產紀錄。完整版本不只包含權重檔,也要保存原始碼提交紀錄、資料快照、特徵定義、超參數、評估報告、相依套件、硬體條件與部署設定。若只保留模型檔,團隊即使知道問題出在 v1.2.3,也無法可靠重現當時輸出,更無從比較新舊版本的真正差異。
直接可採用的做法,是為每個實驗建立不可變更的 run ID,並將模型工件與中繼資料連結到同一份實驗紀錄。例如分類模型可記錄 Accuracy, F1, AUC、max_depth、random seed 與資料切分方式;其中 accuracy 為 0.92,並不代表模型一定可上線,還須確認測試集來源、閾值與業務可接受的錯誤成本。這種紀錄方式能避免只看單一分數而做出錯誤決策。
直接的判斷原則是:任何會影響輸入、推理或輸出的元素,都應有版本。對大型語言模型而言,除基礎模型外,還要追蹤系統提示詞、工具定義、嵌入模型、檢索筆數、reranker、溫度值與 Token 上限。若使用 Llama 3.1-8B、GPT-4、Claude 等不同供應來源,還必須記錄模型別名解析結果,避免供應商更新底層版本後,卻被誤認為自家程式沒有變動。
- 將模型、資料、程式、環境與評估結果綁定同一個實驗識別碼。
- 以不可變更的版本號取代「latest」作為生產環境唯一依據。
- 保存輸入輸出範例與人工審查結論,補足單一指標的盲點。
釐清 Git、資料版本與模型註冊庫的責任邊界
直接來說,Git 管理的是程式碼變更,無法單獨解決大型資料與模型工件的追蹤問題。當模型權重達到數百吉字節,甚至資料集進入幾兆字節規模時,把檔案直接放入 Git 不僅效率差,也會讓儲存庫難以維護。較穩健的架構是由 Git 保存管線與設定檔,由資料版本工具保存資料快照,再由模型註冊庫管理可供部署的模型版本與生命週期狀態。
直接可落地的分工是:資料工程師以 DVC 或物件儲存版本固定資料雜湊,資料科學家用實驗追蹤工具登錄參數與指標,平台團隊則在模型註冊庫中核准候選版本。這讓「程式碼相同但資料不同」與「資料相同但權重不同」能被明確辨識。對處理 PB 級數據版本控制的團隊而言,保存資料指標與快照位置通常比複製完整資料更可行。
直接避免混亂的方法,是禁止以檔名語意取代狀態管理。像 model-final-final2.bin 這類命名無法表達版本是否通過資安檢查、是否已在暫存環境驗證,或能否回退。模型註冊庫應提供實驗版本、候選版本、暫存版本、生產版本與歸檔版本等明確狀態,並以權限控制誰能將版本推進到下一階段。
- Git:保存程式碼、部署宣告與設定檔。
- 資料版本:保存資料快照、來源、轉換與存取位置。
- 模型註冊庫:保存可部署模型、指標、核准紀錄與狀態。
用血緣追蹤建立可稽核的模型履歷
直接來說,模型血緣應讓稽核人員能從線上端點反查到模型、資料、評估與核准流程,也能從某份資料回查受影響的模型版本。這是AI資料治理與版本管理交會的地方:資料是否有授權、是否含個資、保留期限為何,以及誰曾使用該資料訓練,都不能只留在口頭交接或試算表。
直接可執行的欄位至少包括資料集 URI 與雜湊值、標註規則、清理管線版本、訓練時間、套件 lockfile、模型簽章、評估集版本、核准者與部署目標。當客服知識庫更新造成回答異常時,團隊便可區分是模型權重改動、文件擷取錯誤,還是向量索引更新導致,而不是盲目回退整套應用程式。
直接建議把血緣視為上線必要條件,而非事故後補文件。NIST AI Risk Management Framework 提醒組織應持續治理 AI 風險;在實務上,可將資料敏感度、模型用途、已知限制與人工覆核規則附加到註冊版本。當模型服務涉及財務、醫療或內部機密時,這些中繼資料也是採用私有化架構與存取控管的依據。
- 以模型版本為中心串連資料、程式、評估、部署與核准紀錄。
- 將資料授權、敏感度與保留規則納入可查詢的中繼資料。
- 設定血緣缺漏即不得進入生產環境的品質關卡。
從實驗到退役:建立模型生命週期品質關卡
以六個狀態取代模糊的上線判斷
直接來說,模型生命週期可分為 6 個階段:實驗版本、候選版本、暫存版本、生產版本、歸檔版本,以及退役處理。每個階段都應有不同的可見性、權限與驗證責任。實驗版本容許快速迭代;候選版本必須附上評估報告;暫存版本應在接近生產的環境測試;生產版本則須可被穩定引用與即時回退。
直接可設定的品質關卡,是要求候選版本在離線評估、資安掃描與業務測試都留下證據。例如,若新版本宣稱準確率提升了12.7%,仍需檢查是否來自相同測試集、是否犧牲少數類別的召回率,以及是否符合 95%以上業務場景。若只比較平均分數,容易把看似改善的模型推入不適用的情境。
直接要避免的是把狀態當作手動標籤。狀態轉換應由 CI/CD 工作流程執行,並連動測試結果、審核紀錄與變更單。像 @champion、@production 這類別名適合讓呼叫端取得核准版本,但別名本身必須可回查到固定 version = 3,而不能指向不明確的 latest。這樣才能兼顧服務穩定與版本彈性。
- 實驗:快速探索,不得直接供正式端點呼叫。
- 候選與暫存:完成離線、整合、安全與使用者驗證。
- 生產與歸檔:維持穩定引用、回退能力與保存政策。
用可比較的評估取代單一準確率
直接來說,版本比較必須先鎖定評估集與業務門檻,再看模型分數。分類、預測與生成任務的衡量方式不同:分類可用 Accuracy、F1、AUC,生成內容可搭配 BLEU、ROUGE、事實正確率、毒性檢查與人工偏好評分。模型宣稱多模態理解能力提升了40% 時,也必須列出測試樣本、影像品質與失敗案例,才能判斷改善是否可轉化為商業價值。
直接可採用的門檻範例是:候選版本需達到 0.95 的主要任務門檻、0.92 的安全或穩定性下限,且關鍵情境不得低於基準版本。這些數字不是通用答案,而是把風險容忍度具體化的語言。客服助理可以容許較低的措辭相似度,卻不應容許錯誤引用公司政策;需求預測則要把缺貨與庫存成本一併納入評估。
直接建議在正式上線前保留人類覆核樣本,特別是 LLM 微調或 RAG 更新後。LLM 的輸出具有非決定性,提示詞微調後的高分不一定代表實際對話更可靠。把代表性失敗案例納入回歸測試集,才能避免新版本修正一個問題時,又重新引入已處理過的幻覺、提示注入或格式錯誤。
- 固定測試集版本,禁止以臨時抽樣支撐上線結論。
- 結合自動指標、人工評審與高風險案例回歸測試。
- 為每個指標設定門檻、例外流程與核准責任人。
規劃支援期限與退役,避免版本債務失控
直接來說,版本管理的終點不是部署成功,而是可控地退役。企業常因舊系統相依、法規查核或客戶合約,必須同時維護多個模型版本;若沒有支援策略,修補漏洞或更新基礎映像時會變成高風險作業。建議對生產版本提供至少12個月的安全補丁支持,並在替換前提前6個月發布退役公告。
直接可設定的退役流程包含盤點呼叫端、通知系統負責人、提供遷移測試環境、觀察流量下降與最終關閉端點。對關鍵服務,保留至少3個月的緊急支持窗口,讓發現相容性問題的團隊有修正空間。版本退役前也要確認資料刪除、模型工件保存與稽核紀錄是否符合 AI資料治理 的規範。
直接從 PoC 就要設計退役與交接,因為臨時原型最容易成為無人維護的正式服務。ALION 的做法是以實際資料與實際業務環境驗證,將設計、程式碼與決策依據保留成可延續的資產;若驗證顯示不該開發,明確的 No-Go 結論同樣能避免後續版本債務與無效投資。
- 列出每個生產版本的擁有者、支援期限與替代版本。
- 退役前先完成呼叫端盤點、遷移測試與溝通通知。
- 將 PoC 成果以可延續到正式開發的結構保存。
把 AI模型部署納入版本化發布與回滾設計
部署模式應由風險、流量與資料敏感度決定
直接來說,AI模型部署沒有單一最佳解;批次預測、即時 API、串流回應、非同步工作與邊緣推理,應依延遲目標、流量型態、成本與資料位置選擇。即時詐欺偵測需要低延遲端點,夜間庫存預測適合批次運算,而涉及機密文件的問答系統則可能更適合私有化LLM部署,避免資料離開受控網路。
直接可使用的部署流程可分為 1. 規劃、2. 設置、3. 打包和部署、4. 測試、5. 監控、6. 持續整合和持續部署 (CI/CD)。每一階段都要帶入固定模型版本、容器映像雜湊與環境設定;否則即使模型註冊庫紀錄正確,實際執行端點仍可能因套件或 GPU 驅動差異產生不同結果。
直接在部署宣告中鎖定模型 URI、映像標籤與健康檢查條件,可降低「測試可用、上線失效」的機率。技術演進的時間線也提醒團隊重視相容性:2019-12-26、2021-06-29、2021-11-26 與 2024-06-21 等不同發布或更新節點,常會牽動框架、驅動與服務 API 的支援範圍。部署文件必須記錄相容矩陣,而非只保留口頭經驗。
- 低延遲服務優先評估即時端點、快取與自動擴縮。
- 大批量工作優先評估批次推理與排程成本。
- 敏感資料場景優先評估網路隔離與私有化LLM部署。
金絲雀與影子流量是降低發布風險的關鍵
直接來說,新模型不應一次取代全部流量。較安全的方式是先以影子部署複製真實請求但不回傳結果,確認延遲、格式與成本;接著使用金絲雀或灰度發布,先讓 5-10% 流量導向新版本。若穩定,可每日增加20%流量;若關鍵指標惡化,則立即停止擴大並切回已核准版本。
直接要設定的回滾目標,是讓操作人員能在 30分鐘內完成版本回退,且端點切換盡可能自動化。服務關鍵度更高時,可設計多區域備援以確保5分鐘內完成切換,並以 99.995% 作為可用性目標。這些目標需搭配演練、路由設定與明確 runbook,否則文件上寫有回滾流程,事故發生時仍可能無法執行。
直接可把 A/B 測試用於評估使用者價值,而不是只看系統健康度。例如新版本回應速度改善 32% 的延遲降低,不代表答案更有幫助;應同時觀察任務完成率、人工轉接率、負面回饋與 Token 成本。對生成式應用而言,影子流量還需妥善遮罩個資,並限制不必要的完整內容留存。
- 影子部署先驗證技術行為,避免直接影響終端使用者。
- 金絲雀發布以小流量比較品質、延遲、錯誤率與成本。
- 回滾指令、權限與前一版映像必須預先準備。
部署工具選型要先確認可攜性與治理能力
直接來說,平台選型應從團隊既有雲端、模型格式、資料主權與維運能力出發。使用 TensorFlow、PyTorch 和 ONNX 的團隊,可評估模型服務框架與 Kubernetes 編排能力;需要受管服務的團隊則可比較 Vertex AI、Azure Machine Learning 或 SageMaker。不要只看是否能快速建立端點,更要看模型版本、審計、網路隔離與回滾是否能被一致管理。
直接比較工具時,建議將模型註冊、實驗追蹤、資料版本、部署自動化與監控串成同一條鏈。MLflow 3.0 提供模型與實驗管理能力,DVC 適合處理資料與管線版本;K8s 可協助服務彈性調度。若團隊把每項工具分散使用,至少要以共同 run ID、模型 URI 與變更單號串聯,否則跨系統除錯會非常困難。
直接以小範圍驗證工具組合,是降低平台轉換成本的好方法。ALION 可從現場調查與 KPI 定義開始,以最小配置驗證模型精度、資料條件與使用體驗;其 AI 上游工程訂閱服務月費 20 萬日圓起。相較於可行性未明就投入大型專案,先做可重現的部署 PoC,更容易取得內部投資共識。
| 工具/平台 | 主要定位 | 適合情境 | 注意事項 |
|---|---|---|---|
| MLflow 3.0 | 實驗與模型註冊 | 跨框架模型追蹤 | 需整合部署與權限 |
| DVC | 資料與管線版本 | 大型資料快照 | 需搭配模型註冊 |
| K8s | 容器編排與擴縮 | 多服務生產環境 | 維運門檻較高 |
| Vertex AI | 受管訓練與端點 | Google Cloud 團隊 | 留意雲端綁定 |
- 選型先問資料是否能留在指定網路與區域,再問功能完整度。
- 將部署、回滾、權限與稽核列為必要能力,而非附加功能。
- 用 PoC 驗證實際模型、實際流量與實際資料條件。
以 LLMOps平台串接提示詞、微調與多模型治理
LLMOps要管理模型之外的生成式資產
直接來說,LLMOps平台 是把傳統 MLOps 延伸到生成式 AI 的營運方法,管理範圍包括基礎模型、提示詞、RAG 文件、嵌入模型、工具呼叫、模型路由、評估集與使用者回饋。LLM 的輸出不完全具決定性,且同一任務可能由不同供應商模型處理,因此只替微調權重編版號,無法完整解釋最終回答是如何產生的。
直接應建立提示詞版本與測試機制。每次修改系統提示詞、few-shot 範例、JSON 輸出格式或護欄規則,都應視為可部署變更,先在固定測試集與對抗案例驗證。若使用 GPT-4、LLaMA 或 Claude 進行模型路由,也要記錄路由規則與失敗備援;否則成本、延遲與回答風格突然改變時,團隊沒有足夠資訊追查。
直接對 RAG 應用來說,版本單位至少要包含文件集合、切塊規則、嵌入模型、向量索引、檢索筆數與提示模板。這能區分「模型幻覺」和「知識庫未更新」兩種問題。當公司內規更新時,先發布新的知識庫候選版本並以代表性問題測試,再與模型版本一同核准,會比直接覆蓋線上索引更安全。
- 提示詞、檢索設定與工具定義都應有版本與核准流程。
- 記錄模型路由與備援,避免多供應商行為變更不可追蹤。
- 把高風險對話與提示注入案例納入持續回歸測試。
LLM 微調必須連同基礎模型與資料集管理
直接來說,LLM 微調的版本不能只寫成「客服模型新版」。可追溯的紀錄應包含基礎模型版本、訓練資料授權、清洗規則、指令格式、LoRA 或 QLoRA 設定、rank、learning rate、訓練步數、評估結果與推理量化方式。尤其使用 adapter 時,基礎模型與 adapter 任一方變更,都可能改變輸出並造成相容性問題。
直接可將 v2.0.0 視為可能破壞相容性的重大改版,v1.3.0 視為新增能力,v1.2.1 則視為修補版;但語意化版本只是溝通工具,不能取代中繼資料。真正可重現的發布包,仍要能取得固定權重雜湊、設定檔、tokenizer 與容器映像。這也能讓不同團隊在相同硬體上重新執行驗證,而不是各自得到不同結果。
直接在微調前做資料審查,能降低模型記憶敏感資訊與偏見擴大的風險。AI資料治理 應確認資料來源、目的限制、個資遮罩、保存期限與撤回機制;若資料權利人要求刪除,組織必須知道哪些微調版本受到影響。這種資料到模型的血緣追蹤,是治理要求,也是未來維護成本的重要控制點。
- 固定基礎模型、adapter、tokenizer 與量化設定的組合。
- 將資料授權與刪除要求連結到受影響的微調版本。
- 用評估集確認微調改善是否犧牲安全、偏見或格式穩定性。
以中立框架選擇 LLMOps 平台與工具鏈
直接來說,選擇 LLMOps平台 不應只比較畫面功能,而要同時檢查總持有成本、延遲、吞吐量、資料主權、可攜性、供應商鎖定與稽核能力。開源工具可提供較高的控制權,例如 MLflow 2.4 採用 Apache 2.0 授權;受管平台則能降低基礎設施負擔,但應事先確認模型、追蹤資料與評估紀錄是否可完整匯出。
直接可把平台拆成四層評估:實驗與註冊、提示詞與評估、推理與路由、監控與治理。若團隊需要代理系統,還要確認是否能追蹤多步驟執行、工具呼叫與失敗重試。官方資料指出,MLflow provides complete AgentOps support for all agent frameworks, including LangGraph, CrewAI, Pydantic AI, Google ADK, and custom agent implementations. 但導入前仍應以自身流程測試整合深度。
直接建議先建立最低可行的治理基線,再擴充平台能力:統一 run ID、模型與提示詞註冊、角色權限、審計日誌、評估門檻與回滾機制。對剛起步的企業,過早購買全功能套件可能造成流程負擔;反之,完全不做紀錄則難以跨過正式上線門檻。最合適的架構,是能隨應用風險與團隊成熟度逐步增加控管。
- 評估資料主權、匯出能力與供應商鎖定,而非只看功能清單。
- 代理應用需追蹤多步驟 Trace、工具呼叫與重試行為。
- 先建立版本、權限、評估與回滾四項治理基線。
用 AI模型監控與 LLM可觀測性守住上線品質
監控必須同時看技術健康與業務品質
直接來說,AI模型監控 不能只監看 CPU、GPU 與 API 是否存活,還要觀察輸入漂移、輸出品質、錯誤率、延遲、成本與業務成果。傳統模型可監測資料分布與準確率,生成式應用則需增加事實正確性、拒答率、提示注入攔截率、工具成功率及人工接手率。若沒有版本標籤,任何儀表板數字都很難對應到特定變更。
直接可建立分層告警:基礎設施告警處理端點失敗,模型告警處理漂移與品質下降,業務告警處理轉換率或案件完成率異常。高成熟度團隊可管理 200+個關鍵指標告警閾值,但不代表所有指標都要即時叫人處理;應依使用者影響、風險等級與可執行性設計嚴重度,避免告警疲勞。
直接把模型版本、提示詞版本、資料索引版本與部署版本寫入每筆事件,是加速除錯的關鍵。當使用者抱怨回答錯誤時,團隊才能重建該次請求使用的設定與檢索內容。這種可追溯事件設計,也能把事故分析從「猜哪次更新有問題」轉為「以證據定位哪個版本組合造成影響」。
- 將端點健康、模型品質、成本與業務 KPI 分層監控。
- 所有日誌與指標都帶入模型、提示詞與索引版本標籤。
- 告警門檻應連結明確處置流程,避免無效通知。
LLM可觀測性要追蹤每次回應的完整脈絡
直接來說,LLM可觀測性 的重點是以 Trace 串起一次使用者請求經過的模型呼叫、檢索、工具執行、重試、護欄與回應。僅保存最後答案,無法判斷錯誤來自使用者輸入、RAG 召回不足、外部工具逾時,還是模型本身推論失準。對 Agent 應用而言,步驟鏈與決策路徑尤其重要。
直接應量測每分鐘令牌(TPM)和每分鐘請求(RPM)、首字延遲、完整回應延遲、輸入輸出 Token、快取命中率與每次任務成本。這些指標可協助團隊發現提示詞膨脹、無效重試或檢索內容過長等問題。當成本突然增加時,先依模型版本、租戶、功能與提示詞版本切分資料,通常比直接更換供應商更容易找出根因。
直接要在可觀測資料中落實最小必要原則。Trace 可能含有客戶問題、內部文件或個資,因此應設定遮罩、加密、保存期限與角色權限。私有化LLM部署 能降低資料外流風險,但不會自動消除內部日誌過度蒐集的問題;治理規則仍要覆蓋輸入、輸出、追蹤資料與備份。
- 以 Trace 關聯模型呼叫、RAG 檢索、工具執行與護欄結果。
- 追蹤 TPM、RPM、延遲、Token、快取與單次任務成本。
- 對日誌內容實施遮罩、權限與保存期限管理。
把監控結果接回版本決策與持續改善
直接來說,監控的價值在於驅動版本決策,而不是累積漂亮儀表板。當線上品質低於門檻、成本超支或風險事件升高時,團隊應能選擇暫停流量擴大、回退至前一個 @production 版本、修正候選版本,或建立新的再訓練與評估工作。每次處置都應回寫到模型履歷,形成可學習的變更紀錄。
直接建議定期做季度測試,重跑關鍵案例、檢查資料分布、驗證權限與演練回滾。對高變動知識庫或大量使用者互動的系統,還應提高檢查頻率。若歷次優化讓模型服務發布流程縮短70%、事故定位時間降低85%,也應確認這些改善沒有犧牲人工覆核、資安掃描或資料授權查驗等必要關卡。
直接以業務人員回饋補足自動監控的盲點。ALION 在需求預測 PoC 中,會以過往銷售與庫存資料比較多個預測模型,並把結果納入下單與生產計畫示範;這種做法能同時驗證精度與現場可用性。模型監控若沒有連到實際流程,就可能只優化技術指標,卻沒有解決缺貨、庫存過剩或人工判讀負擔。
- 將告警、回退、修正與再評估結果回寫到版本履歷。
- 用季度測試檢查品質、權限、資料與回滾能力。
- 以現場使用者回饋驗證技術指標是否真的創造效益。
以 AI資料治理與私有化架構降低長期風險
資料治理是模型版本可靠性的前提
直接來說,AI資料治理 決定模型版本能否被合法、安全且長期地使用。資料來源不清、使用目的未定義、敏感資料未遮罩時,即使模型分數再高,也不應進入生產。團隊需要記錄資料擁有者、授權條件、蒐集日期、處理目的、保存期限、敏感度分級與刪除流程,並把這些資訊寫入資料與模型血緣。
直接可把資料治理關卡設在資料進入訓練、微調、檢索與日誌四個入口。訓練前確認可使用性,微調前確認指令資料品質,建立向量索引前檢查文件權限,保存 Trace 前遮罩個資。這比事後發現機密內容已被嵌入模型、索引或日誌更容易控制,也能減少跨部門清理成本。
直接要建立角色分工:資料擁有者決定可用範圍,業務單位定義可接受風險,工程團隊實作權限與刪除機制,模型審核者核准發布。若任何一方缺席,版本管理就會變成純技術流程。尤其在內部知識問答場景,文件是否能被模型檢索,必須與原有文件存取權限一致。
- 資料血緣應記錄授權、敏感度、目的與保存期限。
- 在訓練、微調、索引與日誌四個入口設置治理檢查。
- 以角色分工確保治理不是單靠工程團隊承擔。
私有化LLM部署適合高敏感與高控制需求情境
直接來說,私有化LLM部署 適合需要嚴格資料主權、網路隔離、客製化模型路由或可預測成本的企業情境,例如研發文件、法務合約、製造配方與受管制資料。它不等於一定要完全自建資料中心,也可以是在指定雲端帳戶、私有網路或隔離 Kubernetes 叢集執行;關鍵在於模型、資料、日誌與權限都能被組織控制。
直接評估私有化架構時,應比較模型授權、GPU 容量、延遲、擴縮、更新週期、資安維運與備援成本。開放權重模型可增加可控性,但也把漏洞修補、推理最佳化與服務可用性的責任帶回團隊。若沒有明確的模型註冊、映像掃描與版本回滾流程,私有環境可能比受管服務更難維護。
直接的落地策略,是先選擇一個資料敏感且範圍明確的流程做 PoC,例如內部文件問答或特定部門摘要服務。透過實際資料驗證模型品質、權限繼承、GPU 成本與使用體驗,再決定是否擴展。這也符合小規模起步的原則:先驗證「是否真的該做」,而非一開始就投入過大的基礎設施。
- 私有化可部署於隔離雲端帳戶、私有網路或自建環境。
- 將模型授權、硬體、修補、備援與維運成本一併納入決策。
- 先以資料敏感且邊界清楚的流程驗證架構可行性。
建立可執行的導入路線與參考依據
直接來說,導入順序應從盤點高價值且可量化的業務問題開始,再建立最小版本台帳、資料血緣、評估集與發布流程。接著選定一個模型服務做候選、暫存與生產三環境驗證,最後才擴大到多模型路由、Agent 與跨部門治理。這能避免還沒證明使用價值,就先建置過於龐大的平台與流程。
直接可將每週一次的跨職能檢視會議作為治理節奏:確認資料變動、候選版本結果、部署風險、線上監控與待決事項。ALION 的上游工程支援包含需求定義、架構設計、示範製作與經營層報告;若後續進入正式開發,相關上游工程費可自正式預算扣抵。這種節奏有助於讓現場需求、技術可行性與投資判斷同步推進。
直接可參考可信的官方文件建立內部標準:MLflow 文件說明模型註冊與追蹤能力,DVC 文件說明資料版本方法,Google Cloud 文件提供 Vertex AI 模型服務指引,NIST AI RMF 提供風險治理框架,OpenTelemetry 則可協助建立追蹤標準。建議將這些參考資料納入架構審查清單,而非只在導入初期閱讀一次。
- 先以單一高價值流程建立最小可行的版本與治理基線。
- 固定跨職能檢視節奏,讓業務、資料、工程與資安共同決策。
- 將官方文件轉化為內部架構審查與上線檢核項目。
參考來源
MLflow 官方文件:https://mlflow.org/docs/latest/;DVC 官方文件:https://dvc.org/doc;Google Cloud Vertex AI 文件:https://cloud.google.com/vertex-ai/docs;NIST AI Risk Management Framework:https://www.nist.gov/itl/ai-risk-management-framework;OpenTelemetry 文件:https://opentelemetry.io/docs/。
總結
AI模型版本管理的目的,是讓每一個上線中的 AI 行為都能被理解、重現與控制。從資料快照、模型註冊、提示詞版本,到 AI模型部署、監控、回滾與退役,這些機制共同構成可持續的模型生命週期。當團隊把版本資訊連到業務 KPI、資料治理與可觀測性,就能把 AI 專案從一次性的展示,轉為可被長期信任與持續改善的服務。
重點整理
- 完整版本必須涵蓋模型、資料、程式、環境、評估、提示詞與部署設定。
- 候選、暫存與生產狀態應以品質關卡、權限與稽核證據區隔。
- 金絲雀、影子部署與可演練的回滾流程,能有效降低模型更新風險。
- LLMOps平台應整合模型、提示詞、RAG、Trace、成本與治理,而非只管理權重。
- 先以實際資料和現場流程完成 PoC,再擴大私有化架構與企業級治理。
若您的團隊正面臨模型版本混亂、無法量化上線效益,或不確定私有化 LLM 是否值得投入,建議先從一個可衡量的業務流程開始盤點。以資料、模型、提示詞與部署設定建立最小可追溯鏈,再透過小規模 PoC 驗證精度、成本與使用體驗,將能更穩健地做出下一步投資判斷。
常見問題 FAQ
Q1. AI模型版本管理和 Git 版本控制有什麼不同?
Git 主要管理程式碼與設定檔;AI模型版本管理還需追蹤資料快照、模型權重、超參數、評估結果、相依環境、提示詞與部署紀錄。兩者應整合使用,而不是互相取代。
Q2. 生成式 AI 為什麼需要管理提示詞版本?
系統提示詞、few-shot 範例、護欄與輸出格式都會直接改變 LLM 行為。將提示詞納入版本、測試與核准流程,才能比較新舊回答、追查事故原因並安全回退。
Q3. 什麼情況適合私有化LLM部署?
若應用涉及機密文件、個資、受管制資料、嚴格網路隔離或高度客製化需求,便適合評估私有化部署。不過仍須一併評估 GPU、修補、監控、備援與維運能力。
Q4. 模型上線後還需要重新評估嗎?
需要。資料分布、知識庫內容、使用者行為與供應商模型都可能改變。建議持續監控品質、延遲、Token 成本與業務 KPI,並定期重跑回歸測試與回滾演練。
Q5. PoC 階段要做到完整版本管理嗎?
PoC 不必一開始建置大型平台,但至少應保存資料來源、模型設定、評估結果、原型程式與決策紀錄。如此不論最後選擇正式開發或 No-Go,都能留下可被重用與檢驗的資產。