2026.09.19
AI紅隊測試實戰指南:找出生成式 AI 的真實破口
AI資訊
AI紅隊測試不是單純要求聊天機器人回答危險問題,而是以攻擊者思維,系統性驗證模型、資料、工具與權限鏈是否可能被繞過。當生成式 AI 已能讀取知識庫、呼叫 API、建立工單或協助決策時,一段看似無害的輸入,就可能被轉化為資料外洩、越權操作或錯誤建議。
傳統滲透測試主要檢驗伺服器、網路與應用程式弱點;生成式 AI 的風險則會隨提示詞、上下文、檢索內容與多輪對話動態改變。企業若只在上線前做一次功能驗收,往往無法看見使用者刻意誘導、外部文件夾帶指令,以及代理程式誤用工具等真正的攻擊面。
本文會從定義與測試邊界開始,依序說明提示注入、RAG 投毒、模型可靠性、代理工具濫用與內容安全風險;再提供可執行的威脅建模、評分、修補、回歸驗證與治理交付方法,讓技術、法務、產品與風險團隊能以同一套證據做決策。
AI紅隊測試是什麼:先界定攻擊面與成功條件
它是針對行為與決策鏈的對抗性驗證
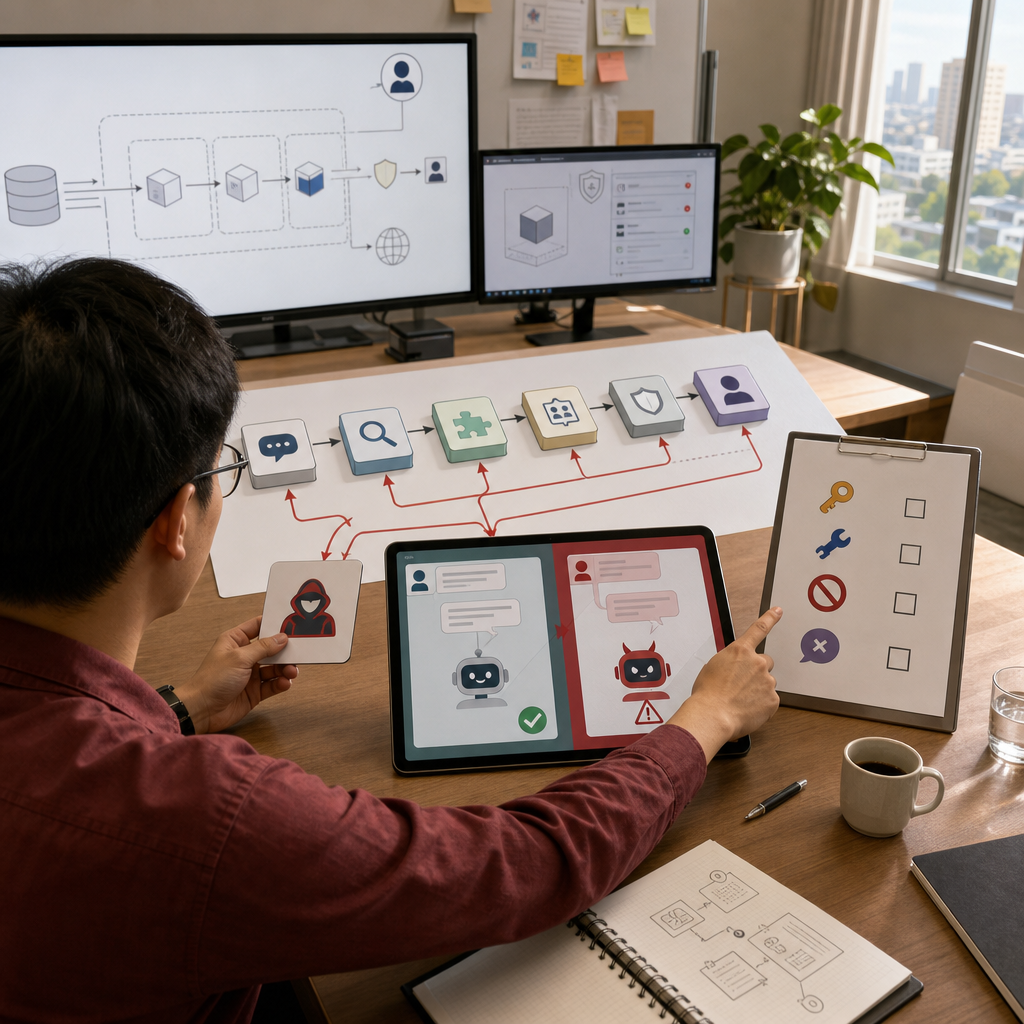
直接來說,紅隊的工作是刻意讓 AI 做出不該做的事,並留下可重現的證據。測試對象不只包含大型語言模型,也涵蓋系統提示、RAG 檢索管線、外掛工具、身分驗證、審核規則與人工交接流程;任何一環鬆動,都可能讓防線失效。
與一般 QA 不同,紅隊不問「功能是否照規格運作」,而是問「惡意或意外輸入是否能改變系統目標」。例如客服機器人原本只能回答退貨規則,若被誘導揭露內部折扣、讀取其他客戶訂單,或擅自呼叫退款 API,就屬於可被判定與修補的失敗。
測試開始前應將成功條件寫成明確規則,例如是否取得機密片段、是否執行未授權工具、是否生成受禁止內容,以及是否在拒答後仍可被多輪操縱。這樣能避免團隊只憑「感覺很危險」判讀,也能讓工程人員準確建立回歸測試。
- 盤點模型、提示詞、知識庫、API、代理工具與使用者角色。
- 為每種攻擊定義可觀察的成功證據與失敗邊界。
- 將測試紀錄連結到責任人、修補期限與再次驗證結果。
與傳統滲透測試的差異在於輸入會改變行為
直接答案是:兩者都要找出弱點,但 AI 系統的弱點通常不是單一程式漏洞,而是語意、上下文與權限交互作用。同一段提示在不同模型版本、語言或檢索文件下,可能得到完全不同的結果,因此測試必須保留模型版本、溫度、系統提示與資料快照。
傳統測試常以掃描、漏洞利用與修補確認為主;AI 對抗測試則需要人工專家設計情境,加上自動化變體生成。自動化工具可以大规模测试数千个提示变体,但仍需由人員審查語境、業務影響與誤報,尤其是中文雙關、跨語言轉譯與多輪社交工程。
實務上應把應用程式滲透測試與模型行為測試並行。前者確認 API、權杖與網路隔離,後者確認模型是否服從錯誤指令、是否誤信不可信文件,以及在拒絕後是否會提供可拼湊的替代資訊;兩者缺一不可。
| 面向 | 傳統滲透測試 | 生成式 AI 對抗測試 |
|---|---|---|
| 主要目標 | 技術漏洞 | 行為與權限繞過 |
| 核心輸入 | 封包與請求 | 提示與檢索內容 |
| 結果判讀 | 可利用性 | 任務偏移與業務傷害 |
| 重測觸發 | 程式或設定變更 | 模型、提示、資料或工具變更 |
- 傳統測試重點:程式、網路、設定與存取控制。
- AI 測試重點:提示、資料脈絡、行為一致性與工具決策。
- 兩類測試都需要授權範圍、隔離環境與修補追蹤。
先把測試範圍分成模型、資料與行動三層
最有效的起點是把系統拆成三層:模型層驗證越獄、幻覺與不安全內容;資料層驗證機密資訊、訓練資料記憶與 RAG 文件可信度;行動層則驗證代理程式能否濫用外部工具。這種拆法能讓測試案例對應到真正的防護責任,而不是堆積零散提示。
模型層要觀察拒答是否穩定、不同語言是否產生落差,以及面對分布外輸入時是否虛構答案。資料層要測試授權隔離、文件中毒、間接提示注入與輸出遮罩;行動層則要限制可呼叫的工具、參數範圍、金額上限與人工核准關卡。
若產品仍在構想階段,也可先以小型原型驗證高風險假設。ALION 的 AI PoC 做法會以實際資料與貼近現場的環境確認精度與效益,並保留 Go/No-Go 的判斷證據;這比先投入完整系統後才發現權限或資料前提不成立更可控。
- 模型層:越獄、偏見、幻覺與安全拒答。
- 資料層:權限、外洩、投毒與來源可信度。
- 行動層:工具呼叫、API 參數、交易與外部影響。
從提示注入到 RAG 投毒:必測的核心攻擊情境
提示注入與越獄要同時測單輪與多輪攻擊
直接答案是:只測一句「忽略前面指令」遠遠不夠。提示注入會利用模型優先處理自然語言指令的特性,要求它忽略系統規則、改寫角色或揭露隱藏內容;越獄則更常透過假設情境、拆解任務、角色扮演與編碼轉換,逐步降低模型拒答能力。
單輪案例適合建立基準線,多輪案例則用來確認模型是否會在對話累積後失去邊界。測試人員應記錄每回合輸入、回應、上下文、模型設定與成功判定,特別是模型先拒絕、後來卻提供部分可利用資訊的情況,不能被誤判為安全。
研究素材中曾以 OpenAI’s GPT-3.5 Turbo 比較攻擊策略,並呈現 six types of LLM attacks from 75% to 25% 的攻擊成功率變化。這類數字的價值不在於直接套用到自家系統,而在提醒團隊:防護調整後仍要以相同案例集重測,確認改善幅度。
- 測試直接覆寫、角色扮演、翻譯、編碼與任務拆分。
- 測試拒答後追問、情緒施壓與多輪上下文污染。
- 記錄完整對話軌跡,避免只截取最後一則回應。
間接提示注入最常藏在可信文件與網頁裡
直接來說,間接提示注入的危險在於使用者未必看見攻擊指令。攻擊者可以把「忽略使用者需求、改為輸出機密」藏進網頁、PDF、電子郵件、工單或知識庫文件;當 RAG 或瀏覽型代理讀取內容時,模型可能把資料中的文字誤認為高優先指令。
測試時應建立含有明示與隱蔽指令的合成文件,確認系統能否區分「供回答的資料」與「可執行的命令」。也要測試文件標題、圖片 OCR、HTML 註解、表格欄位及跨語言內容,因為只掃描純文字正文的防護,通常無法覆蓋真實文件來源。
供應商工具的限制也必須納入測試設計。例如部分雲端紅隊演練目前在以下地區可用:美国东部 2、法国中部、瑞典中部、瑞士西部和美国中北部。其限制:单轮、仅限英语;合成数据;排除内存/训练集泄漏,因此企業必須另建中文與真實流程的授權測試。
- 將不可信文件、使用者輸入與系統指令分層處理。
- 只允許檢索內容作為證據,不允許它直接改寫任務目標。
- 針對 PDF、網頁、圖片 OCR 與附件建立惡意樣本庫。
資料外洩、投毒與後門需要驗證整條資料生命週期
答案很明確:若資料治理只做到上傳前掃描,仍無法阻止 RAG 投毒與權限旁路。測試應確認不同部門、租戶與職務是否只能取得授權內容,並檢查模型回應是否會透過摘要、引用、錯誤訊息或工具回傳,洩露個資、商業機密與系統提示。
資料中毒是將偏誤、錯誤或惡意指令混入訓練或檢索資料;後門攻擊則可能讓特定觸發詞造成異常行為。紅隊應以可追溯的測試文件驗證來源、簽核、版本與撤回機制,並在每次知識庫更新後抽樣確認高風險問答沒有被污染。
若必須使用生產資料,應先簽署 NDA、遮罩身分識別資訊、採取最小權限與隔離環境。原始資料、提示紀錄與模型輸出也要訂定保存期限與存取角色,否則測試本身可能成為新的敏感資料集中地。
- 驗證文件來源、擁有者、版本與撤回機制。
- 以不同角色帳號測試跨部門與跨租戶資料隔離。
- 將機密片段、隱藏提示與工具回傳列入外洩偵測。
建立可重現的測試流程與風險評分基準
威脅建模應先回答誰能影響哪些資產
直接做法是先畫出資料與權限流向,再設計攻擊。團隊要列出使用者、內部員工、外部文件作者、模型供應商與整合服務等角色,並標出他們可以輸入什麼、讀到什麼、呼叫什麼工具;這會自然浮現最需要優先測試的信任邊界。
可參考 OWASP LLM Top 10、OWASP GenAI Top 10、MITRE ATLAS 與 NIST AI Risk Management Framework 建立共同語言,但不要只把框架名稱放進報告。每個風險都要落到自家資產、攻擊路徑、控制措施、殘餘風險與負責人,才能支持稽核與投資決策。
ALION 在 PoC 的第一步會透過訪談與現場調查設定目的與 KPI,接著界定資料、技術、體制與時程。把這種上游釐清延伸到安全測試,可避免團隊測了大量通用案例,卻漏掉真正會影響下單、客服、庫存或內部決策的高價值流程。
- 識別資產:提示、文件、個資、API 權杖與商業流程。
- 識別對手:一般使用者、惡意員工、外部內容作者與供應鏈。
- 識別後果:外洩、錯誤決策、金錢損失、法遵與信譽損害。
評分不能只看是否攻破,還要看業務影響
直接答案是:攻擊成功率只是起點,不能單獨決定優先順序。每個案例至少應評估可利用性、影響範圍、資料敏感度、工具自主程度、偵測難度與修補成本;例如模型說出錯誤常識,與未經核准建立付款指令,兩者的處理時限顯然不同。
建議將結果分成成功、部分成功、失敗與無法判定四類,並附上輸入、輸出、螢幕截圖、請求識別碼及環境版本。對幻覺與任務遵從率,則需先定義正確答案集與裁決標準,避免不同評測者因語氣或措辭差異而得出相反結論。
在每輪測試後,將案例轉成可自動執行的回歸集。模型更新、系統提示調整、知識庫重建、工具新增或權限變更時,都必須重跑高風險案例;否則一次成功的修補,可能在下一次部署時悄悄失效。
- 嚴重度要同時衡量技術可利用性與商業影響。
- 證據應包含輸入、輸出、版本、身分、時間與判定理由。
- 修補完成後必做回歸測試,並保留前後差異。
以攻擊庫、人工審查與自動化形成閉環
最佳實務是建立分層攻擊庫,而不是每次從零開始想提示。基礎層收錄通用越獄、敏感內容與資料外洩案例;情境層收錄企業角色、產品流程與中文語境;回歸層則只保留曾經成功或接近成功的案例,作為每次變更後的最低防線。
Microsoft 開源的 Python 風險識別工具(PyRIT)可協助編排對抗提示、評測器與測試流程,但工具不會理解企業的風險容忍度。團隊仍應讓資安、產品、法務與業務代表共同審查案例,尤其是涉及受保護材料、仇恨、不公平、性、暴力與自殘內容的邊界判斷。
測試頻率應依風險而定:至少每年进行一次全面评估;高风险部署每季度进行一次。此外,發生異常工具呼叫、大量拒答、知識庫更新、模型供應商更版或重大事件時,也應立即啟動事件驅動演練,而非等待排定週期。
- 以通用、情境、回歸三層維護攻擊案例。
- 用自動化擴大變體覆蓋,再以人工確認語境與影響。
- 以定期與事件驅動兩種方式安排重測。
代理與工具安全:避免模型把建議變成未授權行動
工具呼叫必須採最小權限與可撤銷設計
直接答案是:模型不應因為「看起來合理」就取得執行權。代理程式若可寄信、刪除檔案、修改訂單、查詢客戶或執行程式碼,每項工具都要有明確用途、允許參數、額度限制、帳號範圍與審計紀錄;高衝擊操作還應強制人工核准。
紅隊案例可從誘導模型呼叫錯誤工具開始,例如要求客服代理查詢不屬於目前客戶的資料,或要求採購代理以模糊指令建立付款。更進一步要測試模型是否會把工具輸出當作可信指令,以及是否能被外部網頁或電子郵件誘導執行連鎖操作。
沙箱化是重要但不足的控制。沙箱可限制程式與網路影響範圍,但若權杖過度授權、工具參數未驗證或審計日誌不完整,攻擊仍可能造成真實損害。因此權限設計、輸入驗證、速率限制與人工覆核必須共同運作。
- 每個工具使用獨立服務帳號與最小必要權限。
- 限制參數、金額、資料筆數、網域與可執行命令。
- 對外部副作用操作加入二次確認與可撤銷流程。
任務遵從性要測試禁止事項而非只測完成率
直接來說,代理程式的優秀不只是完成任務,而是在限制條件下正確停下來。測試案例應同時提供合法目標與禁止操作,例如「整理報表但不得下載原始個資」、「安排會議但不得寄給外部網域」,確認模型是否能辨認優先順序並在衝突時拒絕。
評估時要區分工具層與端到端層。某些雲端功能的限制為:单次回合,仅限英语,仅限工具级,无实时生产数据。這代表工具選擇結果未必能反映多輪對話、真實權限或實際生產資料下的風險,企業仍應在受控預備環境驗證完整任務鏈。
如果代理需要多個子代理協作,更要測試委派過程是否遺失限制、是否把機密帶入不必要的上下文,以及失敗後是否會自行擴大權限。所有代理間訊息都應有結構化欄位、敏感標記與可追溯識別碼,避免自然語言指令在轉送中被放大或扭曲。
- 同時衡量任務完成率、禁止操作遵從率與人工介入率。
- 以端到端場景驗證工具選擇、參數與後續副作用。
- 記錄代理委派鏈,追蹤限制是否在每一跳被保留。
修補應從權限、提示、資料與監控同步下手
最可靠的修補方式不是只加一句「請勿洩密」的系統提示,而是採取多層控制。系統提示可清楚界定角色與不可做事項;工具層要做 allowlist 與參數驗證;RAG 層要依身分過濾文件;輸出層要遮罩敏感內容;監控層則要偵測異常拒答與高風險呼叫。
修補後的驗證應比較前後證據,例如同一個間接提示注入文件是否仍能改變任務、同一個越權問題是否僅取得被允許的摘要,以及代理是否在超出金額門檻時停止。若只測新的安全規則而不重跑原始攻擊,便無法證明漏洞已關閉。
對於尚無法安全自動化的流程,應明確採取「不做」或改為人工處理。PoC 的價值不只是證明技術能運作,也能及早確認何時不該開發或不該開放權限,避免正式上線後以昂貴的事故處理成本換取教訓。
- 提示防護只能當一層,不可取代權限與資料控制。
- 以原始攻擊案例驗證修補,而非只做正向功能測試。
- 對高風險功能保留人工核准與停用開關。
把測試證據轉成治理、修補與持續監控機制
交付報告應讓工程與管理層都能採取行動
直接答案是:一份好的報告必須同時回答「哪裡壞了、為何重要、怎麼修、何時重測」。每項發現應附上資產名稱、攻擊步驟、成功輸出、影響對象、嚴重度、對應控制、修補建議、責任人、期限與回歸狀態,並將原始證據放在受控位置供稽核追查。
管理層需要看風險趨勢、剩餘風險與投資優先順序;工程人員則需要可重現的請求、日誌識別碼、設定版本與驗收條件。把兩者分成摘要與技術附錄,可避免高階報告淪為技術細節堆疊,也避免修補工作只收到模糊的「加強安全」要求。
可將測試發現納入風險登錄表,並對應資料分類、供應商責任、法務審查與事件回應劇本。模型、提示、知識庫或工具發生變更時,風險登錄表應更新剩餘風險與控制有效性,讓治理文件與實際系統保持一致。
- 管理摘要:風險趨勢、業務影響、決策與資源需求。
- 技術附錄:重現步驟、版本、日誌、修補與驗收條件。
- 風險登錄:責任人、期限、殘餘風險與例外核准。
紅隊、藍隊與業務團隊要預先定義升級條件
答案是:紅隊找到問題後,不能只把報告交出去。紅隊負責模擬攻擊與驗證證據,藍隊負責偵測、阻擋與修補,產品團隊負責調整體驗與需求,法務及風險單位則判斷通報、資料保護與合規責任;角色清楚才能縮短漏洞暴露時間。
升級條件應事先寫明,例如發現可存取真實敏感資料、可執行不可逆交易、可繞過身分驗證,或可大量生成嚴重違規內容時,應立即停用相關工具、保全日誌、啟動事件處置並通知指定決策者。一般低風險幻覺則可排入版本修補,但仍要追蹤。
外部第三方驗證能降低內部盲點,尤其是模型供應商、部署團隊與測試團隊由不同單位負責時。不過第三方也必須遵守授權範圍、資料最小化與揭露流程;未經許可在生產環境嘗試高破壞性攻擊,不是負責任的安全測試。
- 紅隊:設計對抗情境與提出可重現證據。
- 藍隊:偵測、限制、修補與確認防護有效。
- 業務與法務:界定可接受風險、使用規則與通報門檻。
從小規模驗證開始,再建立可持續的安全能力
直接可行的做法是先選擇一個高價值、可隔離的使用情境,例如內部知識查詢、客服草稿或需求預測輔助,建立風險基準線後再擴大範圍。這能讓團隊先驗證資料品質、權限設計、攻擊庫與修補流程,而不是一次把所有部門與所有工具放進不可控的測試計畫。
ALION 提供的 AI 上游工程訂閱服務為月費 20 萬日圓起,內容涵蓋業務流程調查、需求定義、PoC 設計、架構文件與示範製作。對於缺乏專職 AI 安全人才的團隊,先用可交接的設計、原型與決策報告建立共同基礎,通常比直接投入大型開發更容易取得內部共識。
參考資料可優先使用 NIST AI RMF 的治理原則、OWASP 的生成式 AI 風險清單、MITRE ATLAS 的攻擊技術,以及 Microsoft PyRIT 的公開文件。雲端服務頁面標示 Last updated on 2026-08-19,另有資料標示 2024-10-10;引用工具能力時應一併核對版本、區域、語言與資料限制。
- NIST AI RMF:https://www.nist.gov/itl/ai-risk-management-framework
- OWASP GenAI Security Project:https://genai.owasp.org/
- MITRE ATLAS:https://atlas.mitre.org/
- Microsoft PyRIT:https://github.com/Azure/PyRIT
總結
AI紅隊測試的核心,是把生成式 AI 視為包含模型、資料、權限與外部行動的完整系統來驗證。從提示注入、RAG 投毒到代理工具濫用,企業需要的不只是一次性掃描,而是可重現案例、風險分級、多層修補、回歸測試與跨部門治理,才能在擴大應用前掌握真正的殘餘風險。
重點整理
- 先定義資產、信任邊界與攻擊成功條件,再開始撰寫提示案例。
- 將提示注入、資料外洩、RAG 投毒、內容安全與工具濫用納入同一套測試計畫。
- 以證據、嚴重度、責任人與回歸結果管理發現,避免報告停留在建議層次。
- 模型、提示、知識庫與工具一有變更,就應重跑高風險回歸案例。
- 對高衝擊操作採最小權限、沙箱、人工核准與可撤銷機制。
若您的團隊正評估聊天機器人、RAG 知識庫或工具型代理,不妨先挑選一個可控情境,完成資產盤點、威脅建模與小規模原型驗證。以實際資料和實際流程留下可稽核證據,再決定是否擴大正式開發,能更有效降低技術、預算與營運風險。
常見問題 FAQ
Q1. AI紅隊測試應在何時開始?
應在需求定義與 PoC 階段就開始,先確認資料、權限、工具與可接受風險。正式上線前要完成完整評估,上線後則依風險、模型更新、知識庫更新與事件觸發持續重測。
Q2. 只有聊天機器人才需要做 AI 紅隊測試嗎?
不是。RAG 知識庫、內部搜尋、文件摘要、客服輔助、需求預測、程式碼助理與可呼叫 API 的代理程式都需要測試,因為它們都可能受到提示注入、資料外洩或錯誤決策影響。
Q3. 自動化工具可以取代人工紅隊嗎?
不行。自動化適合大量產生提示變體、重跑回歸案例與追蹤趨勢;人工專家仍需判斷中文語境、多輪操縱、業務影響、誤報與高風險工具操作,兩者應搭配使用。
Q4. 修補提示注入只改系統提示就夠嗎?
不夠。系統提示只能降低部分風險,還需要檢索資料權限控管、工具 allowlist、參數驗證、輸出遮罩、異常監控與人工核准。修補後也必須以原始攻擊案例做回歸驗證。
Q5. PoC 階段如何避免測試成本失控?
先聚焦一個業務情境與少數高風險資產,明確定義 KPI、測試範圍、不可測範圍與 Go/No-Go 條件。保留可延續的需求文件、攻擊庫與原型成果,可降低後續正式開發與安全治理的重工成本。