2026.11.14
LLM權限控管:企業從試點走向正式營運的安全藍圖
AI資訊
LLM權限控管不是替聊天機器人加上登入頁面而已,而是要回答「誰能在何種情境下,透過哪個模型,讀取哪些資料、呼叫哪些工具,以及誰要為結果負責」。當生成式 AI 從個人嘗試進入採購、客服、生產排程與企業知識庫,任何一段模糊的授權鏈,都可能讓原本提升效率的系統變成資料外洩與內控失靈的入口。
傳統產業常先以單一部門 PoC 驗證企業知識庫聊天機器人,接著才發現共用 API 金鑰、文件夾權限不一致、外包人員帳號未撤銷,以及 Agent 可直接執行 ERP 查詢等問題。這些並非單純技術瑕疵,而是企業AI權限管理、資料治理與營運流程沒有同步設計;若等到正式上線後才補救,成本通常更高。
本文以可落地的方式拆解 LLM權限控管:先盤點資產與資料風險,再建立人員、應用程式與 Agent 的身分模型,接著以 AI資料去識別化、AI安全護欄與 LLM防護欄降低即時風險,最後把操作紀錄、權限審查與模型漂移監測納入 AI合規審計。文中也提供 PoC 到正式營運的決策步驟與實務矩陣。
LLM權限控管先從風險與資產盤點開始
先界定保護對象,而不是先選工具
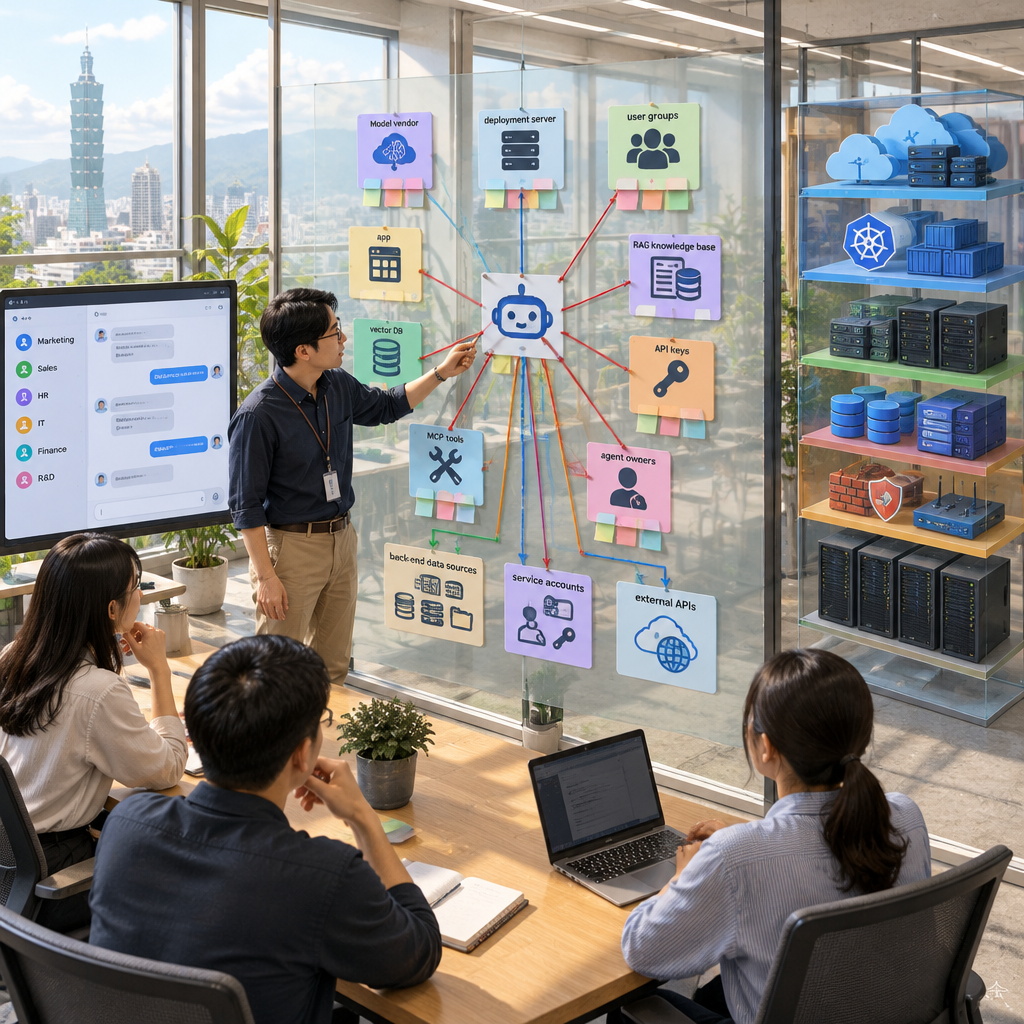
直接答案是:先建立 AI 資產清冊,才能設計有效的 LLM權限控管。清冊至少應列出模型供應商、部署位置、使用者群組、應用程式、RAG 知識庫、向量資料庫、API 金鑰、MCP 工具與 Agent 所有者。若企業只盤點聊天介面,卻忽略背後的檔案來源、服務帳號與外部 API,授權範圍就會在看不見的地方持續擴張。
製造業常見情境是採購部可查詢供應商報價、產線主管可查詢良率資料、業務可讀客戶提案;三者都可能使用同一個企業知識庫聊天機器人,卻不應取得相同文件。權限設計必須把「登入者是誰」延伸為「請求代表誰、資料來源是否允許、模型是否可處理、輸出可否下載或轉寄」。
盤點也要納入基礎設施容量,因為部署選擇會改變隔離方式。70B 等級模型需以 FP8 或量化精度才能在單卡 96GB 上部署;而單張 RTX PRO 6000 Blackwell(96GB)已足以運行 70B 等級的模型(FP8)。若改採 FP16,多卡、共享 GPU 與多租戶配額便需一併納入存取政策與稽核範圍。
- 盤點人類帳號、服務帳號、Agent 與外部合作人員
- 標記模型、資料集、工具、金鑰與部署環境的所有者
- 將資料依公開、內部、機密與高度機密等級分類
用攻擊路徑理解LLM資料外洩
直接答案是:LLM資料外洩通常不是模型「記住祕密」這麼單一,而是輸入、檢索、工具與輸出多個環節串起來的結果。員工可能把合約貼進外部模型、惡意文件可能藉提示注入誘導 RAG 助手忽略規則,Agent 也可能以過度寬鬆的 Token 讀取不相干的資料夾,最後再以摘要或工具呼叫方式帶出敏感內容。
企業應以 OWASP LLM 應用程式風險觀點檢查提示注入、敏感資訊揭露、供應鏈弱點、訓練或檢索資料污染、系統提示洩漏與過度代理行為。重點不是追求一次性封鎖所有提示,而是為每條資料流設定可驗證的拒絕條件,例如禁止機密文件送往未核准的推論端點。
實務上可畫出「使用者登入→AI Gateway→政策判斷→模型呼叫→RAG 檢索→工具執行→輸出遮罩→日誌留存」的路徑圖。每個節點都要有責任人與失敗處理方式;例如模型服務不可用時,應降級為不含機密資料的回答,而不是繞過檢查改送到私人帳號。
- 檢查提示注入是否能改寫工具呼叫意圖
- 驗證 RAG 是否依文件原有 ACL 過濾檢索結果
- 禁止未經核准的外部端點接收機密上下文
建立可執行的權限矩陣
直接答案是:權限矩陣必須以「主體、資源、動作、條件、稽核」五欄描述,才不會停留在抽象原則。主體不只包含員工,也包含應用程式、工作負載身分與 AI Agent;資源則包含模型、資料集、對話紀錄、MCP 伺服器、SQL 查詢與部署環境。動作要區分讀取、檢索、生成、下載、修改、執行與管理。
例如,品管人員可檢索自己廠區的匿名化異常報告,但不得下載原始客訴附件;排程 Agent 可提出採購建議,但不得直接建立採購單;平台管理者可管理模型路由,卻不必查看機密提示內容。這種拆法能避免「管理員」成為萬用且不可追蹤的特權帳號。
矩陣應把條件寫清楚,例如裝置是否受管理、網路位置、資料分級、請求目的、Token 時效與是否完成二次核准。這能把最小權限落實為系統判斷,而非仰賴使用者記得規範。新專案可先參考AI 採購評估框架盤點供應商責任,再把必要控制點納入驗收條件。
| 主體 | 可允許動作 | 應拒絕動作 | 必要控制 |
|---|---|---|---|
| 一般使用者 | 查詢核准知識庫 | 管理模型與金鑰 | SSO、資料分級 |
| 部門管理者 | 審核群組與報表 | 查看跨部門機密 | MFA、審核日誌 |
| AI Agent | 受限工具呼叫 | 自行擴權與轉授權 | 短效 Token、人工核准 |
| 平台管理者 | 設定路由與政策 | 任意瀏覽提示內容 | 職責分離、雙人覆核 |
- 主體:人員、應用程式、工作負載、Agent
- 資源:模型、文件、資料庫、工具、金鑰
- 條件:資料級別、時間、設備、地點與人工核准
企業AI權限管理要串接既有身分與資料邊界
以SSO、RBAC與ABAC建立共同語言
直接答案是:企業AI權限管理應沿用既有 IAM 的身分來源,再補上 AI 情境需要的屬性判斷。以 SSO、MFA、SCIM 與 Directory groups 接入既有帳號,可避免人資異動與 AI 平台帳號脫鉤;RBAC 適合定義採購、品管、法務與系統管理等穩定角色,ABAC 則適合處理廠區、專案、資料密級與裝置風險等動態條件。
導入時不宜為每位員工手工建立 AI 權限。較穩健的方法是把既有群組映射到 AI 平台角色,再針對高風險資料與工具增加屬性限制。這樣調職時,原部門群組移除即可同步撤銷檢索權;外包人員也能設定合約到期日,降低帳號遺留風險。
有些案例宣稱透過集中化權限與自動化流程可最高減少90%人工授權作業,或最高減少75%的權限審查負擔;這些數字應視為改善方向,而非保證成效。企業真正要驗證的是:異動後的撤權是否準時、例外申請是否可追蹤,以及資料過濾是否在每次檢索時生效。
- SSO 負責可信登入與離職停用同步
- RBAC 定義穩定職務角色
- ABAC 依資料等級、專案與環境做動態判斷
讓RAG與資料來源繼承原有權限
直接答案是:RAG 不應因為文件被切塊、嵌入與建立索引,就失去原始文件的存取規則。每個文件區塊都應保留來源、擁有者、資料級別、部門、專案與 ACL 中繼資料;查詢時先取得使用者身分與屬性,再以同一套條件過濾向量檢索結果。僅在回答後才遮罩內容,往往已經太晚。
AI資料去識別化是必要控制,但不是權限控管的替代品。業界案例提到上下文脱敏准确率约98%,同時也承認仍有2%的漏判风险;因此,姓名、電話、身分證字號或客戶編號的遮罩,必須搭配資料最小化、來源 ACL 與人工抽查,不能把遮罩結果當成可無限制分享的證明。
對 SQL、ERP 或供應鏈資料,建議設計安全檢視表與列級安全性,而非讓模型直接連到資料庫管理帳號。模型應取得的是受限制的查詢能力,並由政策層限制資料表、欄位、列數與查詢頻率。如此即使提示遭到操弄,也能縮小可被帶出的資料範圍。
- 文件切塊需保留 ACL 與來源追溯欄位
- 在檢索前過濾,而非只在輸出後遮罩
- 以安全檢視表與列級政策保護結構化資料
從PoC定義正式營運的成功條件
直接答案是:PoC 成功不能只看回答像不像人,而要同時驗證資料邊界、效率與可維運性。建議先選定一個高價值且範圍可控的流程,例如讓維修人員查詢核准的設備手冊,並設定可量測指標:正確引用來源比例、越權檢索阻擋率、平均回應時間、人工查找時間與權限異動完成時間。
ALION 的 PoC 作法強調先以最小配置、實際資料與實際業務環境驗證,再決定 Go/No-Go。對權限議題而言,原型至少要模擬不同部門帳號、機密文件、撤權情境與提示注入測試;若只用無敏感性的示範資料,無法證明正式環境中的企業AI治理是否可行。
企業可採月費 20 萬日圓起的小規模上游工程支援,先完成需求定義、架構圖與可操作示範;若進入正式開發,原型設計與程式碼應成為可延續的資產。比起先簽下大範圍建置案,先把授權模型與資料流做成可測試的 PoC,更容易取得資訊、法務與業務單位共識。
- KPI 同時衡量效益、準確度、安全與維運負擔
- 以真實但受控的資料測試資料分級與撤權
- 把 Go/No-Go 依據寫入投資決策文件
AI代理人權限必須管理委託鏈與工具能力
為每個Agent建立不可混淆的身分
直接答案是:每個 Agent 都要有獨立工作負載身分、明確所有者與用途,不能借用共用 API 金鑰。人類使用者、Agent 與後端服務帳號的身分必須分開,並記錄「誰啟動了 Agent、Agent 代表誰行動、使用何種委託範圍」。否則發生錯誤採購、資料下載或異常工具呼叫時,組織無法判斷責任落點。
常見身分技術可包含 OAuth、OIDC、SAML、JWT、短效 Token 與服務帳號。文件指出,Logto 支持 OAuth 2.0、SAML、API 鍵、個人訪問令牌(PATs)和 JWT;無論採用何種產品,核心原則都是避免把長效明文祕密直接交給模型提示、程式碼儲存庫或多位開發者共用。
部分技術文章標示上次更新時間: 2026-05-08,另有內容以2026-11-13發表;這提醒團隊不要只看一次性教學。AI代理人權限涉及供應商 SDK、MCP 協定與雲端 IAM 的快速變動,應由平台負責人定期確認憑證格式、撤銷機制與支援版本,而不是複製舊設定長期使用。
- 每個 Agent 指派業務所有者與技術所有者
- 使用短效、可撤銷且可追溯的工作負載憑證
- 區分使用者委託、Agent 身分與服務帳號身分
把工具呼叫拆成可核准的能力
直接答案是:Agent 不應被授予「可用 ERP」這種模糊權限,而應取得細分且可撤銷的工具能力。例如,庫存分析 Agent 可呼叫 read_inventory 與 forecast_demand,但不可呼叫 create_purchase_order;客服 Agent 可查詢訂單狀態,卻不能修改收款帳戶。能力清單應包含工具名稱、允許參數、資料範圍、頻率限制與是否需要人工核准。
MCP 伺服器可讓模型連接資料與工具,也擴大了攻擊面。企業需在 Gateway 或政策引擎檢查呼叫是否符合使用者原始權限、Agent 的固定權限與當次任務目的;當 Agent A 呼叫 Agent B 時,更要避免 B 直接繼承 A 的全部權限,造成混淆代理或橫向越權。
高風險操作如建立付款、刪除資料、調整主檔或寄送外部郵件,應採「提案—顯示影響—人工確認—執行—回寫日誌」流程。這類控制不會阻礙自動化,反而能讓業務願意擴大使用。若政策規則超過 1000条时需要引入规则优化与缓存机制,也要確保快取不會延後撤權生效。
- 以工具、參數與資料範圍取代籠統系統權限
- 高風險寫入動作設為人工核准
- 禁止 Agent 間無限制的權限繼承與轉授權
用沙箱限制Agent的執行面
直接答案是:能寫程式、讀檔或上網的 Agent,必須在隔離環境執行,不能直接取得正式主機權限。容器、Kubernetes NetworkPolicy、非 root 執行、唯讀檔案系統、輸出網路白名單與資源配額,都是把「模型可能做錯事」轉化為可控制影響範圍的基礎措施。
若工作負載需要容器環境,技術文件常指定Docker Engine 28.0 及以上版本,但版本符合不代表政策完善。團隊還應限制映像來源、禁止掛載主機敏感目錄、掃描相依套件漏洞,並將每個工作階段的檔案、網路與命令紀錄送到集中日誌平台。
對實驗性方案更應保留證據邊界。例如有文件明確寫著本文對照 OpenShell 0.1.2 文檔,未做本地部署實測。這類內容可作為設計參考,卻不能直接當成生產環境驗收依據。正式導入前應用自家權限模型、資料集與攻擊案例測試,確認隔離失效時的告警與停損流程。
- 以容器與網路政策限制可執行範圍
- 禁止 Agent 使用 root 與長效主機憑證
- 將工具呼叫、網路連線與檔案操作寫入日誌
AI安全護欄與LLM防護欄要在請求當下執行
輸入防護先辨識目的與敏感內容
直接答案是:AI安全護欄要在資料進入模型前判斷身分、資料級別、提示風險與可用模型。輸入層可檢查是否含個資、機密編號、付款資訊、系統提示探測語句或可疑指令;若風險過高,系統應改以遮罩、拒答、轉人工或使用隔離模型處理,而不是單純要求使用者「請勿輸入機密」。
LLM防護欄也應驗證請求上下文是否與使用者職務相符。比如業務人員詢問特定客戶的交貨狀態合理,但若突然要求列出全公司薪資資料,即使文字沒有明顯攻擊語法,也應因目的與權限不符被拒絕。這種結合身分、資源與目的的判斷,比單純關鍵字黑名單更可靠。
實作上要保留可解釋的拒絕原因,例如「此文件屬人資機密,您的角色無檢索權」或「此操作需部門主管核准」。原因不應揭露更多敏感資訊,但能協助使用者修正流程、協助管理者排查誤擋,並讓資安團隊調整規則而不是在黑箱中猜測。
- 輸入掃描個資、機密標記與提示注入特徵
- 依身分、目的與資料級別決定路由或拒絕
- 對拒絕事件提供安全且可理解的原因
輸出與工具呼叫必須二次檢查
直接答案是:模型生成文字之前與工具執行之前,都要再做一次政策判斷。輸出檢查可偵測敏感欄位、過度具體的個資、未授權來源與不可信指令;工具檢查則應驗證目標系統、參數、金額、收件者與資料範圍。輸入安全不代表輸出一定安全,因為風險可能來自檢索內容或模型推論時的組合。
以企業知識庫聊天機器人為例,回答最好附上可點閱的授權來源連結與文件版本,而非只提供看似流暢的結論。來源追溯能降低幻覺造成的作業風險,也能在文件更新或模型漂移後快速定位受影響回答。對外回覆則可增加品牌、法律與個資規則,並在高風險案例轉由真人覆核。
防護欄不應成為所有請求都被拖慢的瓶頸。可對公開知識採較輕量檢查,對機密資料、寫入型工具與跨境傳輸採較嚴格流程;但不能為了效能而略過高風險控制。政策引擎應記錄命中規則、處理時間與最終決策,讓團隊能以數據調整門檻。
- 輸出檢查敏感內容與來源授權
- 工具呼叫前驗證參數、範圍與核准狀態
- 依資料風險採用不同強度的即時檢查
用紅隊演練驗證防護欄是否有效
直接答案是:防護欄的品質要靠情境化攻擊測試驗證,而不是只看規則數量。測試案例至少應涵蓋直接與間接提示注入、越權檢索、系統提示套取、惡意文件、工具參數竄改、資料外傳與模型拒答繞過。每個案例都應記錄預期結果、實際結果、風險等級、修正責任人與回歸測試日期。
紅隊演練最好由業務、資安、資料治理與開發人員共同參與。業務人員最清楚哪些流程一旦誤執行會造成實際損失;資安人員能設計攻擊鏈;開發團隊則能把發現轉為可部署的政策。這種跨部門協作,是企業AI治理從文件走向日常營運的關鍵。
演練結果應回饋到模型路由、RAG 資料處理、工具白名單與教育訓練。若某些問題無法靠防護欄可靠解決,例如高度敏感資料的外部推論風險,最合理的結果可能是縮小用途、改採隔離部署或暫不導入。能清楚提出「現在不該做」也是成熟 PoC 的重要產出。
- 建立可重複執行的提示注入與越權測試集
- 以業務影響排序修正優先順序
- 每次模型、文件或工具更新後做回歸測試
AI合規審計讓企業AI治理能持續被驗證
稽核日誌必須能重建一次決策
直接答案是:AI合規審計的日誌要能回答誰、何時、以何種身分、對哪些資料與工具做了什麼,以及政策為何允許或拒絕。至少記錄使用者與 Agent 身分、來源 IP 或裝置、模型與版本、提示雜湊或受保護摘要、檢索文件識別碼、工具參數遮罩、政策決策、輸出處理與錯誤事件。
日誌設計要兼顧可追蹤與隱私。直接保存完整提示與回覆雖利於調查,卻可能把更多機密複製到日誌系統;因此可依資料級別採取欄位遮罩、雜湊、加密與受限調閱,並設定明確保存期間與調閱流程。稽核者應能看見足以判斷權限決策的證據,而非取得所有原文。
除了安全事件,日誌也是成本治理資料。若 50 名工程師共用同一把供應商金鑰,企業無法區分是哪個應用、部門或提示造成費用與異常流量。改用身分綁定的虛擬金鑰、用量上限與速率限制,才能將成本歸屬到實際責任單位並在濫用前告警。
- 記錄身分、模型、資料來源、工具與政策決策
- 對敏感提示與輸出採遮罩、加密與受限調閱
- 以身分綁定金鑰取代多人共用金鑰
把權限生命週期納入營運節奏
直接答案是:人員入職、調職、離職與 Agent 停用,都必須有可驗證的授權與撤權流程。人資事件應觸發 Directory groups 更新、SSO 停用、Token 撤銷、群組移轉與資料擁有權交接;對 Agent 而言,還要確認業務所有者是否仍在職、工具授權是否仍必要、知識來源是否過期,以及是否存在未被使用卻仍保有權限的代理。
可先定義少量核心角色,避免一開始就製造數百個難維護的例外。有實務建議為先定义5类核心角色,覆盖90%用户需求,例如一般查詢者、資料擁有者、部門核准者、應用開發者與平台管理者;剩餘的高風險例外再以時效性申請與額外審核處理。
某些生產環境案例主張,完善的授權設計经过生产环境验证可以解决90%以上的权限安全问题。企業不應把這視為免死金牌,因為提示注入、供應鏈與人為設定錯誤仍會存在;更務實的作法是每季審查高權限群組、過期 Token、閒置 Agent 與跨部門例外,並追蹤撤權 SLA。
| 階段 | 核心工作 | 驗證證據 | 決策重點 |
|---|---|---|---|
| 盤點 | 資產與資料分級 | 資產清冊、資料流圖 | 範圍是否可控 |
| PoC | 角色與檢索過濾 | 越權測試紀錄 | 是否達安全門檻 |
| 試營運 | 日誌、告警、審核 | 事件演練結果 | 流程是否可維運 |
| 正式營運 | 生命週期與定期審查 | 稽核報表、撤權紀錄 | 是否可擴充 |
- 把 HR 異動與 AI 帳號、Token、群組同步自動化
- 定期確認 Agent 所有者、用途與工具權限
- 以時效性授權處理高風險例外需求
監測模型漂移與治理成效
直接答案是:模型、提示、知識庫與工具任何一項變更,都可能讓原本正確的權限與防護判斷失效。模型漂移不只指回答品質下降,也包括拒答率異常、敏感輸出攔截率改變、工具呼叫模式偏移與檢索來源集中在過期文件。LLMOps 應將這些指標與一般可用性、成本及延遲一起監看。
建議建立變更管理:更換模型版本、調整系統提示、增加 MCP 工具、更新文件大量內容或修改權限規則前,都要執行預先定義的回歸測試。通過測試後才逐步放量,並保留可回退版本。這比在全公司使用者受影響後才追查「是哪次更新改壞了授權」安全得多。
市場資料曾以2027年80%的企业将部署AI Agent用于内部运营、客户服务等场景描述採用趨勢,同時指出目前仅不到9%的企业建立了完善的AI Agent权限管理与数据隔离体系。無論比例是否適用於個別企業,訊息很清楚:Agent 規模擴大前,先把身分、資料隔離、工具權限與稽核能力建好,才能避免自動化放大既有內控缺口。
- 監測拒答率、越權阻擋率、工具呼叫與資料來源變化
- 重大變更先回歸測試,再分階段放量
- 將模型漂移納入資安、品質與成本治理
總結
LLM權限控管的核心是讓每一次 AI 請求都具備可辨識的身分、最小化的資料與工具範圍、即時可執行的政策,以及可回溯的稽核證據。對正從 PoC 走向正式營運的企業而言,最優先的不是堆疊更多模型功能,而是先把資產盤點、資料 ACL 繼承、Agent 身分、AI安全護欄與權限生命週期做成共同標準。
重點整理
- 先盤點模型、資料、工具、金鑰與 Agent,建立可維護的權限矩陣。
- RAG 必須在檢索前繼承原始資料 ACL;AI資料去識別化不能取代存取控制。
- 每個 Agent 應有獨立身分、明確所有者、短效憑證與細粒度工具能力。
- AI安全護欄與 LLM防護欄應在輸入、輸出及工具呼叫三個時點執行。
- 以可重建決策的日誌、定期審查與回歸測試,讓企業AI治理持續有效。
若您正評估企業知識庫聊天機器人、AI 需求預測或內部 Agent,建議先選一個資料範圍可控的流程,完成角色矩陣、資料流圖與越權測試,再決定擴大投資。以小規模 PoC 驗證安全與效益,能讓業務、資訊與管理層在正式開發前取得共同的 Go/No-Go 依據。
常見問題 FAQ
Q1. LLM權限控管和一般 IAM 有什麼不同?
一般 IAM 主要管理人員與系統存取;LLM權限控管還要處理模型、提示、RAG 文件、工具呼叫、Agent 委託鏈與輸出內容。它必須讓原本的身分與資料權限延伸到每一次 AI 推論與自動化動作。
Q2. 企業知識庫聊天機器人是否只要做文件權限就夠?
不夠。除了文件 ACL,還要控制模型路由、提示注入、對話紀錄、下載與分享、輸出遮罩、來源追溯,以及 Agent 是否可呼叫外部工具。尤其 RAG 必須在檢索前依使用者權限過濾內容。
Q3. AI代理人一定要人工核准每個動作嗎?
不需要。低風險、可逆且明確授權的讀取動作可自動執行;涉及付款、刪除、主檔異動、對外寄信或跨部門資料存取的高風險行為,才適合採人工核准、雙人覆核或額外驗證。
Q4. PoC 階段就需要做完整稽核嗎?
PoC 不必一開始建置所有正式平台功能,但至少要留下使用者身分、檢索來源、模型版本、工具呼叫與越權測試紀錄。這些證據可用來判斷是否具備擴大導入條件,也能避免正式上線後重新設計。
Q5. 如何避免共用 API 金鑰造成的風險?
應將共用金鑰逐步替換為應用程式或工作負載專屬的虛擬金鑰,並綁定身分、用途、預算、速率限制與到期時間。搭配集中祕密管理、定期輪替與離職撤銷,才能追蹤用量並降低憑證外流影響。