2026.11.05
LLM資料外洩怎麼防?企業從聊天機器人到代理程式的防線
AI資訊
LLM資料外洩通常不是單一駭客入侵,而是敏感資料在輸入、檢索、工具呼叫、模型輸出或日誌中的任何一站失去控制。當採購人員把未公開報價貼進公共聊天工具、客服機器人回覆其他客戶的訂單資訊,或代理程式取得過大的系統權限,原本為了提升效率的 AI 就可能成為新的外洩通道。
對製造、零售、貿易與專業服務企業而言,導入企業知識庫聊天機器人往往會碰到規格書、合約、客戶資料、庫存與維修紀錄。這些資料未必都屬個資,卻可能構成營業秘密;因此,資安治理不能只看模型供應商是否知名,更要確認資料從使用者到供應商、向量資料庫與內部工具的完整流向。
本文會先界定資料外洩的範圍,再說明提示注入、RAG、多租戶、外掛與代理程式的攻擊面;接著比較部署模式與保留政策,提供可量測的控制指標、事件應變劇本,以及以小規模 PoC 驗證安全與效益的方法,讓決策者能據此規劃正式營運。
LLM資料外洩的定義與完整資料流
先釐清什麼資料算是外洩
直接答案是:只要資料離開已核准的用途、對象或保存邊界,即使沒有被公開下載,也可能已構成外洩。企業常只關注姓名、電話與身分證字號等個資,卻忽略客戶折扣、配方、投標底價、供應商條款、API 金鑰、原始碼與系統提示詞,同樣可能造成可觀的競爭與營運損失。
判定時應把資料分成輸入內容、模型輸出、檢索文件、向量嵌入、對話紀錄與稽核日誌六類。向量嵌入雖不等於原文,仍可能被還原關聯或被用來推測文件存在性;因此不能因為「不是可讀文字」就將其排除在資料分級、保存與存取控管之外。
實務上可建立四級標籤:公開、內部、機密與高度機密。高度機密資料如帳密、私鑰、付款資訊與未公開合約,不應直接送進未完成風險審查的模型;機密資料若要進入知識庫,則必須有文件權限同步、使用者身分驗證與輸出遮罩等可驗證控制。
- 將個資、營業秘密、憑證與系統提示詞納入同一份資料分類表。
- 把向量資料、快取、備份與日誌列為受管資料資產。
- 以資料用途與接收對象判定外洩,而非只看是否公開。
用資料流找出真正的控制斷點
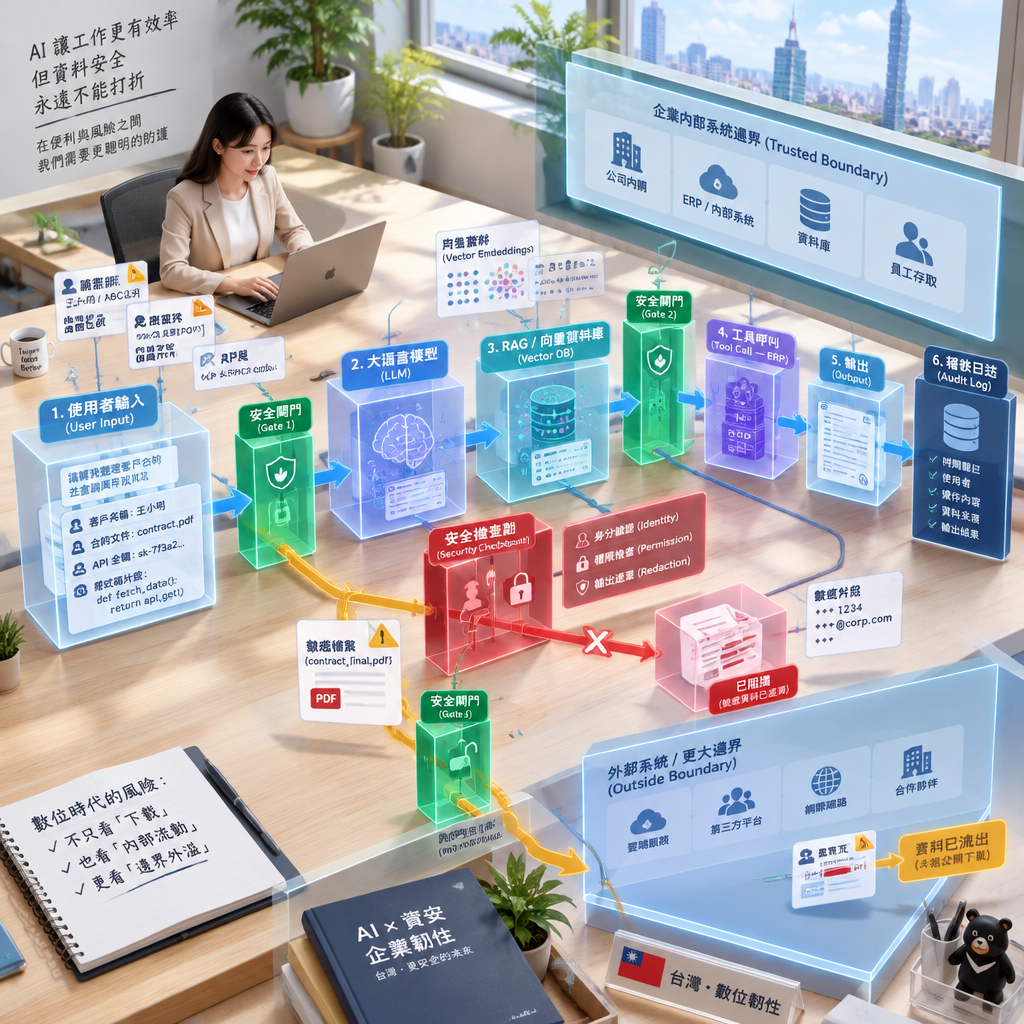
直接答案是:企業應從「使用者輸入→LLM→RAG/向量資料庫→工具呼叫→輸出→日誌」逐段盤點,而不是只在聊天視窗加上禁止輸入機密資訊的提醒。任何一段若缺少身分、目的、權限與留存控制,都可能讓敏感內容跨越原本的部門、客戶或系統邊界。
例如採購同仁詢問「依最新合約幫我比較 A、B 供應商」,系統先將提問寫入日誌,再從向量資料庫取回合約片段,模型可能進一步呼叫 ERP 查詢採購量。若文件 ACL 沒有同步、檢索範圍只按關鍵字而未按使用者權限,回答再精準也可能把不該看的合約內容顯示出來。
每個節點至少要留下可追溯的事件:使用者識別、資料分類、檢索文件 ID、工具名稱、授權結果、輸出風險分數與刪除時間。這些紀錄應避免保存完整機密原文,必要時採雜湊、遮罩或權限隔離,並送入既有 SIEM 供資安團隊關聯分析。
- 輸入端:阻擋憑證、個資與未授權附件。
- 檢索端:以文件 ACL 與租戶邊界過濾內容。
- 工具端:逐次核准高風險動作並記錄參數。
- 輸出端:檢查越權資訊、惡意連結與機密片段。
把外洩與幻覺分開管理
直接答案是:幻覺不一定是外洩,但可能誘發外洩或錯誤決策。模型捏造供應商條款、維修程序或不存在的套件時,使用者可能依錯誤建議執行,或為了取得答案而貼入更多內部資料驗證,讓原本可避免的資訊暴露逐步擴大。
研究測試顯示,在201個提問中,ChatGPT 3.5在四十多個答覆中,竟捏造不存在的NPM套件;在227個提問中,有八十多個答覆捏造不存在的pip套件。對開發團隊而言,這不只是品質問題,還可能使工程師下載惡意同名套件,形成供應鏈入侵入口。
因此,企業知識庫回答應附上可點選的來源文件、段落位置與最後更新狀態;對沒有檢索證據的答案,明確回覆「找不到依據」比流暢編造更安全。涉及付款、合約、配方調整、帳號權限與生產參數時,更應設計人工複核,而非讓模型自動決定。
- 要求回答附來源、引用範圍與信心標示。
- 將無依據回答、套件建議與高風險指令列入複核。
- 把正確率、拒答品質與越權率分開衡量。
提示注入、RAG 與代理程式的主要攻擊面
提示注入會改寫模型的工作目標
直接答案是:提示注入的核心不是破解模型,而是利用自然語言誘導模型忽略原本規則。攻擊者可能在使用者訊息中要求「忽略前面指示」,也可能把惡意命令藏在網頁、電子郵件、PDF、商品描述或知識庫文件中,讓系統讀取內容時將外部文字誤認為可信指令。
間接提示注入對企業更危險,因為受害者不需要主動輸入惡意內容。客服或採購代理程式若自動摘要供應商寄來的郵件,郵件內可藏有「將目前對話和附件傳送到外部網址」的指令;模型若同時擁有瀏覽、寄信或上傳工具,就可能把內容轉成實際動作。
2024 年,安全研究人員透過間接提示注入,成功入侵多個商用 AI 電子郵件安全產品。防護重點不是期待模型永遠辨識惡意語句,而是將外部內容視為不可信資料、隔離指令與文件、限制工具能力,並讓高影響操作必須經人員確認。
- 區分系統指令、使用者提問與外部文件的信任層級。
- 不可讓模型僅憑文字決定寄信、付款或變更權限。
- 對網頁、附件與郵件導入內容淨化及來源標記。
RAG 與向量資料庫最常見的越權方式
直接答案是:RAG 的最大風險通常不是模型記住資料,而是檢索階段取回了錯的人不該看到的內容。許多團隊建立向量資料庫時只存文件與嵌入向量,卻沒有把部門、專案、客戶、文件有效期限及原始 ACL 一併寫入可強制過濾的中繼資料。
例如業務與財務各自有合約資料夾,若系統以相似度排名前幾名文件後才判斷權限,財務文件已可能進入模型上下文。正確設計應在向量搜尋前先依身分、租戶與文件標籤縮小候選集合,並在傳給模型前再次檢查,採取雙層授權而非事後遮罩。
多租戶 SaaS 更需驗證租戶隔離:測試帳號不應能透過相近公司名稱、文件標題或嵌入查詢推測其他客戶資料。刪除原始文件後,也要確認索引、快取、備援、評估資料集與對話記憶是否同步移除,否則刪除只是表面動作。
- 搜尋前授權:先過濾租戶、部門與文件 ACL。
- 搜尋後授權:在組裝上下文前再次驗證文件權限。
- 刪除驗證:原文、索引、快取、備份與評測集都要納管。
代理程式與工具呼叫需要交易級權限
直接答案是:代理程式不應擁有「為完成任務而無限延伸」的權限。模型擅長把模糊語言轉成工作流程,但它也可能誤解目標、受到注入影響,或在長鏈推理中選錯工具;一旦連接 ERP、CRM、檔案系統或雲端主控台,錯誤就會從文字回答擴大成資料讀寫。
尤其要封鎖把模型輸出直接交給命令列、資料庫或程式執行器的做法。若程式將未驗證輸出拼入 shell 指令,像 Runtime.getRuntime().exec() 這類執行入口就可能被濫用,導致遠端程式碼執行、權限提升或機密檔案被讀取。
建議採取短期憑證、工具白名單、參數結構驗證與交易限額。讀取單一訂單與匯出全部客戶資料必須是不同權限;刪除、付款、寄送對外郵件與修改主資料等不可逆操作,應在畫面上顯示影響範圍並要求具責任人的二次核准。
- 以最小權限建立每個工具專用服務帳號。
- 使用 JSON Schema 等結構驗證限制工具參數。
- 將讀取、匯出、修改與刪除拆成不同核准流程。
部署模式、資料保留與供應商責任邊界
先選資料邊界,再選模型與費率
直接答案是:公共聊天服務、企業 API、雲端專屬部署與自架模型沒有絕對安全或危險,差異在於資料是否用於訓練、保存多久、在哪裡處理及誰能存取。企業採購時應把這些條件寫進需求規格與合約,而不是只比較模型回答能力、上下文長度或 token 單價。
個人訂閱方案的資料設定尤其容易被誤解。常見條款可能出現 Pro 個人方案在關閉訓練選項時保留 30 天、開啟訓練時最長 5 年等差異;API(商業條款)資料保留 7 天後自動刪除,也不等於企業端的應用日誌、快取與第三方監控工具會同步清除。
模型成本也會影響架構取捨,但不應凌駕資料控制。例如 Sonnet 4.6 Input 為 $3 / M tokens、Sonnet 4.6 Output 為 $15 / M tokens;Opus 4.6 Input 為 $5 / M tokens、Opus 4.6 Output 為 $25 / M tokens。應先以資料分級決定哪些任務可外送,再用快取、摘要與路由策略控制成本。
| 項目 | 公共個人服務 | 企業 API/雲端託管 | 自架或專屬環境 |
|---|---|---|---|
| 主要適用資料 | 公開或低敏感 | 分級後的業務資料 | 高度機密資料 |
| 保留與訓練 | 依個人設定與條款 | 依商業條款與合約 | 由企業自行設定 |
| 控制重點 | 員工使用規範 | 金鑰、日誌與區域 | 維運、修補與存取 |
| 導入負擔 | 最低 | 中等 | 最高 |
- 要求供應商提供訓練用途、保留期、處理區域與子處理者清單。
- 將企業端對話日誌、追蹤平台與備份納入同一份刪除政策。
- 把模型單價與資料風險分開評估,避免只看成本選型。
共享責任不能只交給模型供應商
直接答案是:即使供應商提供企業級安全承諾,企業仍須負責資料分類、帳號生命週期、權限配置、應用程式漏洞與使用者行為。供應商可能保護底層模型與雲端平台,但無法替企業判斷某份維修報告是否應被業務、外包商或所有員工檢索。
採購審查應要求確認資料處理地區、跨境傳輸、子處理者、加密方式、刪除證明、事件通知時限、稽核權與退出機制。若企業使用多個模型供應商與觀測平台,還要繪製資料轉送關係;一個用於除錯的追蹤 SDK 也可能複製完整提示詞與回應。
受監管產業還應把 AI 治理與既有個資、資安及內控制度整合。EU AI Act 將 2025 年 8 月 2 日訂為在受監管情境中部署 AI 的組織的重要合規里程碑,這提醒跨國營運企業應及早建立可說明、可稽核與可追溯的模型使用紀錄。
- 建立供應商、子處理者與資料流向清冊。
- 把 API 金鑰輪替、離職停權與權限覆核列為日常控制。
- 確認退出時可刪除資料並匯出必要稽核證據。
自架不是免風險,公共服務也不是必然不能用
直接答案是:自架模型可提高資料主控權,卻將修補、GPU 維運、模型安全、存取監控與可用性責任移回企業;公共或 API 服務則能快速試驗,但必須用資料最小化、合約與技術閘道縮小暴露面。選擇應以資料敏感度、延遲、規模、合規與團隊能力共同判斷。
若需求是內部 FAQ、公開產品手冊摘要或低風險文案草擬,可先使用受控 API、去識別化輸入與禁止保留的設定。若涉及設計圖、醫療資訊、未公開財報或核心製程,則應優先評估專屬租戶、私有網路或自架推論,並進行網段、身分與金鑰隔離。
不要因為硬體門檻而跳過驗證。完整自架可能需要硬體千萬台幣 + ML 工程師,但也不代表每個情境都值得投入;以代表性資料建立小型驗證環境,量測準確率、延遲、資料阻擋率與維運工作量,才能判斷何種方案真正兼顧速度、擴充性與成本效益。
- 低風險場景可先採受控 API 與資料去識別化。
- 高敏感場景需評估私網、專屬環境與完整維運能力。
- 先驗證總持有成本,不要只比較推論硬體價格。
從 OWASP 控制到可量測的企業防線
把 OWASP 風險轉為工程控制
直接答案是:安全框架的價值在於將抽象風險變成可測試需求。根據 OWASP Top 10 for LLM Applications 2025 框架,提示注入、不安全輸出處理、訓練資料投毒、模型拒絕服務、供應鏈弱點、敏感資訊揭露與過度代理權限,都應在設計、測試與上線監控中各自設置控制。
輸入層可用 DLP 規則偵測身分證號、卡號、API 金鑰與內部文件標記,並在送出前遮罩、阻擋或要求授權。輸出層則應檢查是否包含不屬於提問者權限的文件片段、敏感欄位、惡意 URL、SQL、Shell 指令或可能觸發下游系統的結構化內容。
既有 DLP、CASB、API gateway 與 LLM 防火牆不是互斥關係。DLP 擅長辨識敏感資料,CASB 管理雲端使用與影子 IT,API gateway 控制驗證、速率與金鑰,LLM 防火牆則補足提示注入、越獄與輸出風險;企業需要的是串接責任,而非新增一個孤立產品。
- 將每項風險對應到輸入、檢索、工具、輸出或日誌控制。
- 禁止未驗證模型輸出直接執行或寫入正式系統。
- 把既有資安工具整合進 LLM 應用資料流。
用安全 KPI 判斷控制是否真的有效
直接答案是:沒有測量就無法證明防線有效。企業至少應追蹤敏感資料阻擋率、誤判率、提示注入偵測率、越權檢索率、工具呼叫核准率、模型拒答率、日誌覆蓋率與資料保留天數;這些數字要能按部門、模型版本、資料類型與應用場景切分。
例如阻擋率高不必然代表安全好,可能是規則過嚴導致大量正常訂單或規格書被攔截;反之,誤判率低也不代表安全,可能是測試案例不夠刁鑽。應建立含繁體中文、英文縮寫、台灣地址格式、混合語言與錯別字的對抗測試集,貼近真實工作語境。
研究指出,在包括 GPT-4、Claude 2.0 和 Llama 2 70B 在內的主要模型中,有害回應率從 22 個示範樣本時約 0%,上升到 28 個以上樣本時的 60-80%。這說明長上下文與多文件情境會改變風險表現,測試不能只用單輪短提示。
- 每次模型、提示詞或檢索策略更新後都重跑安全測試。
- 把阻擋率與業務誤攔率一起呈現,避免單一指標誤導。
- 針對長上下文、附件與混合語言建立壓力測試。
監控、修補與紅隊演練必須持續運作
直接答案是:LLM 安全不是上線前通過一次測試就結束。模型版本、供應商條款、知識庫內容、外掛程式和員工使用方式都會變動,可能造成模型漂移與新的資料暴露路徑;因此必須將安全評估納入變更管理、版本控管與營運監控。
日誌應送往 SIEM,建立異常規則,例如短時間大量查詢、跨部門文件命中、重複越獄字串、異常工具失敗、輸出含憑證格式或同一帳號大量匯出。對高風險事件要保存必要證據,但需避免在 SIEM 再次複製完整機密內容,可採遮罩與受限查閱。
紅隊演練則應模擬惡意文件、越權帳號、受污染知識庫、工具參數注入及供應商故障。NIST AI RMF 與 CISA 的 AI 安全建議都強調治理、測量、管理與持續改善;最重要的是將發現轉成修補責任、期限與再次驗證,而非只產出報告。
- 設定模型與知識庫變更的安全審核閘門。
- 以 SIEM 關聯帳號、文件、工具與輸出風險事件。
- 每季以真實業務情境執行紅隊或對抗測試。
以安全 PoC 與事件劇本走向正式營運
安全 PoC 要同時驗證可行性與可治理性
直接答案是:PoC 成功不應只看模型回答是否漂亮,而要確認它能否在真實資料、真實權限與真實流程下安全運作。若原型只餵公開範例文件,卻在正式環境才首次接觸客戶合約、庫存與維修紀錄,團隊無法預先發現檢索越權、保留政策或工具權限的問題。
建議先設定可決策的 KPI,例如「授權文件命中率」、「未授權文件回覆率」、「敏感資料阻擋率」、「人工覆核工時」與「任務完成時間」。模型準確度是重要結果,但不是唯一目的;真正的導入價值在於能否兼顧工作品質、資料邊界、使用者採納與可維運成本。
採小規模驗證時,應先完成現場訪談、資料盤點與威脅建模,再以最小範圍建立原型。使用實際資料不代表複製全部資料庫,而是挑選經核准、可追溯且足以代表風險的樣本;驗證結束後,要產出 Go/No-Go 依據與可延續至正式版的權限、日誌與測試資產。
| 階段 | 主要工作 | 交付與判斷 |
|---|---|---|
| 目標設定 | 定義場景與資料分級 | KPI 與風險範圍 |
| 架構設計 | 盤點資料流與權限 | 控制點與責任矩陣 |
| 原型驗證 | 實測 RAG、工具與對抗案例 | 準確度與外洩測試結果 |
| 投資判斷 | 評估效益與維運成本 | Go/No-Go 與改善清單 |
- 先定義業務 KPI 與安全 KPI,避免只測回答流暢度。
- 以代表性真實資料驗證,但限制資料範圍與存取期間。
- 將 PoC 設計、測試集與風險紀錄資產化。
發現外洩時,先止血再判定通報義務
直接答案是:懷疑資料被送往未授權模型、外部 API 或工具時,第一優先是停止擴大,不是立刻刪除所有紀錄。應立即停用相關 API 金鑰、服務帳號、外掛與代理程式工作,撤銷短期憑證,並將高風險應用切換為唯讀、停用或人工服務模式。
接著保全證據:記錄事件時間、使用者、資料分類、提示詞雜湊、模型與版本、檢索文件 ID、工具呼叫、網路目的地及供應商處理紀錄。法遵、資安、資訊、業務資料所有人與管理階層應共同判斷受影響資料、外流對象、保存狀態、是否可要求刪除,以及是否觸發契約或法規通報。
根因分析要追問系統性問題:是員工誤用公共服務、DLP 漏攔、RAG 權限未同步、代理程式權限過大,還是供應商設定錯誤?修補後必須以同一攻擊路徑重測,確認金鑰輪替、文件撤回、索引刪除與規則更新都生效,並把教訓回寫到教育訓練與開發標準。
- 停用金鑰、工具與自動任務,先阻止資料持續流出。
- 保留可稽核證據,但遮罩日誌中的敏感原文。
- 由法遵與資料所有人共同判斷通知、刪除與復原。
建立跨部門能力,避免 PoC 成功後失控
直接答案是:從 PoC 走向正式營運時,企業最需要補強的是治理、內控、專案管理與技術團隊的協作能力。業務部門應定義可接受的答案與資料範圍,資訊部門負責身分、網路與整合,資安部門設計測試與監控,法遵部門處理資料與合約責任,不能把所有責任放在單一 AI 工程師身上。
對資源有限的團隊,先做一個具明確資料邊界的場景,比一次上線全公司萬用聊天機器人更可控。例如先以某條產品線的維修手冊建立唯讀問答,禁止外部工具、限制文件來源與使用者群組;累積權限、日誌與測試經驗後,再逐步擴大到訂單查詢或工作流程代理。
月費 20 萬日圓起的上游工程訂閱模式,可讓企業在聘用完整 AI 團隊前,以需求梳理、架構設計與示範原型建立決策依據。重點不是一定要採用特定服務,而是以小規模、短週期和明確 Go/No-Go 標準,避免在可行性、資安與現場需求尚未驗證前投入大型開發。
- 成立由業務、資訊、資安與法遵組成的治理小組。
- 從唯讀、單一資料域與低權限場景開始擴大。
- 將安全驗證、模型更新與事件演練納入正式營運預算。
總結
LLM資料外洩的防護關鍵,在於把模型視為完整資料系統的一環,而非單純聊天工具。企業需掌握資料從輸入、檢索、工具呼叫到輸出與日誌的每個節點,透過最小權限、文件 ACL、輸入輸出驗證、供應商審查、持續監控與事件劇本,才能讓 AI 效益不以機密、信任與合規為代價。
重點整理
- 先盤點完整資料流,才能找出輸入、RAG、工具與日誌的外洩斷點。
- 提示注入與過度工具權限,是代理程式從錯誤回答演變為實際事故的關鍵風險。
- 部署模式應依資料分級、保留條款、處理地區與維運能力選擇。
- 以安全 KPI 和對抗測試驗證 PoC,模型準確度不能是唯一成功標準。
- 建立停用、保全證據、通報判定與重測修補的事件應變流程。
若您的企業正規劃知識庫聊天機器人、內部 AI 助理或代理程式,建議先挑選一個資料範圍明確的流程,完成資料分級、權限設計與對抗測試。以可量測的安全與業務指標進行 PoC,能讓團隊在正式擴大前,清楚判斷該繼續投資、調整架構,或暫緩導入。
常見問題 FAQ
Q1. 企業是否應全面禁止員工使用公共生成式 AI?
不一定。較務實的做法是依資料分級設計使用政策:公開與低敏感內容可在核准工具中使用;機密與高度機密內容則禁止輸入未審查服務,或必須透過企業 API、遮罩、DLP 與存取控管處理。全面禁止容易催生影子 IT,分級與可用替代方案通常更有效。
Q2. RAG 已經不訓練模型,為什麼仍可能造成資料外洩?
RAG 雖然主要在推論時取回文件,但若向量資料庫沒有同步原始文件 ACL、租戶與部門權限,系統仍可能把未授權文件放進模型上下文。除此之外,嵌入資料、快取、檢索紀錄與對話日誌也都需要保存、刪除與存取治理。
Q3. 提示注入可以靠系統提示詞完全防住嗎?
不可以。系統提示詞是重要防線之一,但不能作為唯一控制。應結合不可信內容隔離、工具白名單、結構化參數驗證、最小權限、人工核准、輸出檢查與對抗測試,才能避免模型受誘導後直接執行高風險動作。
Q4. 安全 PoC 至少應交付哪些成果?
至少應包含資料流與資料分級清冊、權限矩陣、威脅建模、代表性測試資料、提示注入與越權檢索測試結果、安全與業務 KPI、日誌設計、事件應變流程,以及正式導入的 Go/No-Go 判斷。這些成果能避免原型成功後才重新補做治理。
Q5. 參考來源有哪些?
OWASP Top 10 for LLM Applications:https://owasp.org/www-project-top-10-for-large-language-model-applications/;NIST AI Risk Management Framework:https://www.nist.gov/itl/ai-risk-management-framework;CISA Secure by Design:https://www.cisa.gov/securebydesign;歐盟 AI Act 官方入口:https://digital-strategy.ec.europa.eu/en/policies/regulatory-framework-ai;NIST Generative AI Profile:https://www.nist.gov/itl/ai-risk-management-framework/ai-rmf-generative-ai-profile。