2026.09.21
模型路由怎麼做,兼顧品質、延遲與成本
AI資訊
模型路由不是「哪個模型最強就全用哪個」的選擇題,而是讓每一次請求都依任務難度、資料敏感度、延遲要求與預算,自動走向合適模型的決策機制。當客服問答、文件摘要、程式協作與 Agent 工作流同時上線,若缺少路由層,團隊通常不是為簡單問題付出高額費用,就是因過度節省而犧牲使用者信任。
實務上,模型能力、計價方式與供應商可用性持續改變,企業不能把商業規則綁死在單一 API。Cursor 的數百萬次請求 A/B 測試顯示,Intelligence 模式在使用者滿意度接近前沿模型的同時,成本降低了約 60%;這說明路由的價值不在模型清單,而在能否以真實任務證明品質底線與成本效益。
本文會從模型路由的運作原理開始,延伸到模型池、快取、回退與多步驟 Agent 設計,再說明如何在 LLMOps平台建立追蹤、評估和治理流程。最後也會整合 GPU推論伺服器、AI模型量化與 AI PoC 的驗證做法,協助團隊用可量測的方式決定何時採 API、自託管或混合部署。
模型路由的核心:讓每個請求走對模型
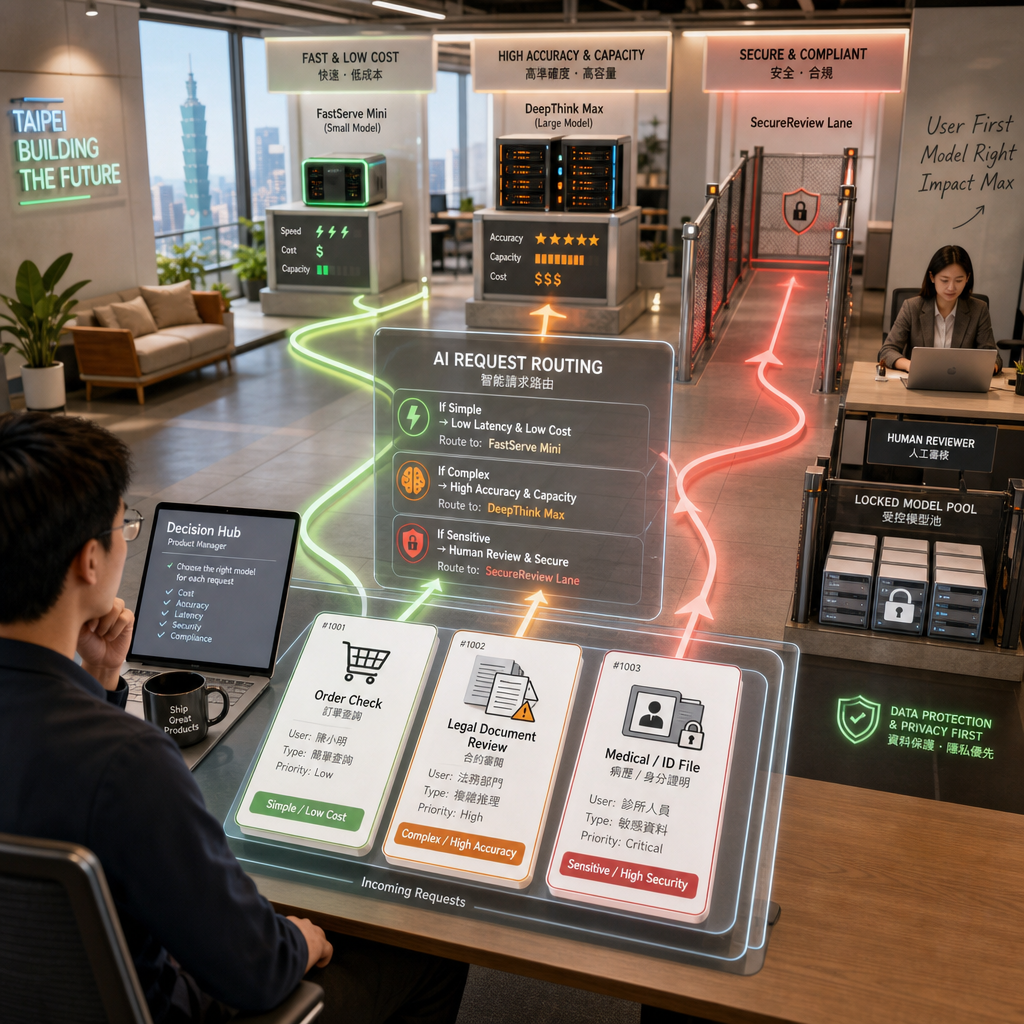
模型路由是什麼,適合哪些任務
直接來說,模型路由是位於應用程式與模型供應商之間的決策層:它讀取請求特徵,套用規則或分類器,再選擇模型、提示版本、工具與推論參數。特徵可包含語義複雜度、輸入 Token 長度、是否需要結構化輸出、使用者方案、歷史滿意度與工作階段上下文;它不是單純依關鍵字分流。
最適合先導入的情境,是請求量大且難度差異明顯的客服、知識庫問答、內容草稿與程式助理。例如固定格式的訂單查詢可用快速低價模型,涉及法規、財務或跨文件推理時才升級高能力模型。深度思考模型的單次查詢成本高出 10–50 倍,因此所有請求都升級,往往不是品質策略,而是沒有決策策略。
路由器也必須知道不該路由的時候。高風險醫療、法律或涉及個資的工作,應先以資料區域、核准模型和人工覆核規則限制可選池;若分類信心不足,採保守升級或拒答,而非把不確定性隱藏在自動化後面。這是維持公平性與品質底線的必要設計。
- 依任務風險、難度、延遲與預算建立可解釋的分流規則
- 將模型能力視為可替換資源,而不是寫死在商業邏輯中
- 分類信心不足時,應升級、澄清或拒答,不應盲目降級
自動模式、人工選擇與路由層級差異
直接答案是:自動路由適合大規模且標準化的工作負載,人工選擇則適合專家需要掌握創作方向或除錯脈絡的場景。常見 Auto、Balance、Intelligence 模式,分別偏向自動省錢、成本品質折衷與高品質判斷;Microsoft Foundry 模型路由器也提供成本、均衡、品質三種路由模式,讓管理者能對應不同服務等級。
API 或 AI Gateway 層的路由,管理的是每一次模型呼叫,包括供應商、區域、重試、配額與資料遮罩;IDE 或 Agent 層的路由,還必須理解任務階段,例如規劃、查找、寫碼、測試與修正。前者適合統一治理,後者能掌握上下文與工具呼叫意圖,成熟架構通常會讓兩者分工合作。
不能忽略工作階段的連續性。若模型切換沒有同步對話摘要、工具狀態與檢索證據,新模型會把先前承諾當成不存在。研究資料指出,92%的Auto切換會導致項目上下文丟失;因此切換前要傳遞結構化狀態,或對長任務設定「同一主模型優先」規則,而不是只追求單次成本最低。
- Gateway 層處理供應商、金鑰、速率限制與回退
- Agent 層依工作階段、工具狀態與任務步驟判斷
- 人工覆寫應記錄原因,回饋路由規則與評估集
從模型池到回退:可上線的決策順序
可上線的做法是建立至少三層模型池:低成本模型承接分類、改寫與簡答;主力模型處理一般推理與 RAG;高能力模型只處理複雜、低信心或高價值任務。每一層都要預先定義可接受的語言、上下文長度、工具能力、資料區域、P95 延遲與單次請求預算,避免「能呼叫」被誤當成「適合承擔」。
路由順序應先做政策檢查,再判斷快取命中與請求分類,接著選模型並保留回退鏈。當主模型逾時、輸出違反 JSON 契約、內容安全檢查失敗或供應商限流時,路由器需改用相容模型,且把原始追蹤識別碼一路帶到後續呼叫。回退不是最後補丁,而是 AI模型部署 的可靠性設計。
一個可作為起點的策略是讓 80% 的查询流向廉价模型;20% 升级到高性能模型。但比例必須由自家評估集與線上資料驗證,不能照抄。若將升級門檻調得太高,雖然帳單下降,可能造成使用者滿意度下降;曾有案例的满意度评分低了 18 分,正是只看成本而沒有品質護欄的警訊。
| 模型層級 | 典型任務 | 路由條件 | 失敗處置 |
|---|---|---|---|
| 低成本層 | 分類、摘要、改寫 | 低風險高頻 | 升級主力層 |
| 主力層 | RAG、一般推理 | 標準服務等級 | 切換相容模型 |
| 高能力層 | 複雜推理、程式除錯 | 低信心或高價值 | 人工覆核或拒答 |
- 回退觸發條件應涵蓋逾時、限流、格式錯誤與安全失敗
- 每個模型池都要有明確能力邊界與服務等級
- 將低信心路由標記為可稽核事件,納入後續標註
以品質、延遲與成本衡量模型路由成效
先定義不可以犧牲的品質底線
直接答案是:先訂品質門檻,才談 LLM成本優化。路由評估至少要量測任務正確率、引用證據完整度、結構化輸出成功率、拒答正確性、使用者滿意度、升級率、每次請求成本與 P50/P95 延遲;不同任務不能用單一「平均分數」掩蓋風險。例如客服可重視解決率,程式 Agent 更應看每次提交是否通過測試。
離線評估能快速找出明顯退化,但無法完整模擬生產流量。測試集若只涵蓋英文、短問題或常見文件,路由器會對非母語使用者、長上下文與罕見意圖做出偏差判斷。正確做法是將真實失敗案例去識別化後納入評估集,並按租戶、語言、風險等級與任務類型分群檢視結果。
成本也應回到單位經濟。Composer 2.5 这样的第一方模型,每百万输入 token 收费 0.50,每百万输出收费2.50;但真正成本還包含檢索、重新排序、工具呼叫、觀測儲存與重試。若路由器額外呼叫昂貴分類模型,或造成多次失敗重跑,表面上的每 Token 單價再低,也可能無法改善每次任務成本。
- 以任務成功而非單一模型基準分數作為品質判準
- 依語言、租戶與風險分群,避免平均數掩蓋不公平
- 將 Token、工具、檢索、重試與觀測成本一併歸因
用線上 A/B 測試驗證路由假設
最可靠的答案是讓相近流量隨機進入控制組與實驗組,並事先設定停止條件。控制組可採固定主力模型,實驗組採分層路由;兩組都要記錄任務類型、提示版本、檢索文件、模型、輸入輸出 Token、延遲、重試與使用者回饋。只有同時觀察成本和品質,才能知道節省是否來自真正有效的分流。
Cursor 每週跨多個模型和供應商處理數億個編程請求,這類規模說明路由器必須接受真實流量檢驗,而非只看少量展示資料。另一組資料顯示,超過 60 萬個真實請求的測試中,路由策略可揭露長尾任務與供應商波動;對一般企業而言,即使流量較小,也應累積足夠樣本再調整閾值。
若是多步驟 Agent,不應只比較第一輪回答。請把任務完成率、工具失敗率、迴圈次數、最終人工介入率及總 Token 納入實驗;否則某個便宜模型可能在第一步看似成功,卻在後續反覆呼叫工具而更昂貴。金絲雀流量與逐步擴大比例,能將錯誤分類的衝擊限制在可控範圍。
- 控制組與實驗組必須使用相同提示、資料與成功定義
- 預先設定品質下降、成本暴增與延遲超標的停止條件
- Agent 評估要看整段工作流,而不是第一輪輸出
從儀表板找到路由器本身的成本
直接答案是監控路由器,而不只監控被選中的模型。分類器耗時、規則命中率、快取查詢、重試、回退與觀測寫入都會增加延遲;在低延遲互動場景中,若主模型 P90 约85ms,路由前置作業就不應花掉大部分時間。應分開呈現「路由判斷時間」與「模型生成時間」,才知道該優化哪一段。
實務儀表板應提供每個功能、團隊、租戶與地區的成本歸因,並將共享快取命中效益與共享 GPU 成本分攤規則文件化。若只看整體月帳單,產品團隊看不到是哪個提示版本、長文件檢索或 Agent 迴圈造成異常;若只看平均延遲,也會忽略少量高價值客戶的長尾體驗。
Balance 模式下每次 commit 的成本为 4.63,智能模式下为6.76,而全部使用 Opus 4.8 的基线为 $7.34。這類數據的重點不是複製某家產品的選項,而是建立自己的「每次成功任務」指標。當成本下降但提交失敗率上升,或人工修正時間增加,該策略就不算真正的模型推論優化。
- 拆分路由、檢索、生成、工具與重試的延遲
- 以功能與租戶建立成本歸因,支援預算與異常告警
- 用每次成功任務成本取代單純 Token 單價
快取與上下文策略,避免路由省錢卻失憶
快取感知路由如何降低重複推論
直接答案是把快取狀態放入路由特徵,而非先選模型再碰運氣。完全相同的問題可用精準快取,語義相近且低風險的問題可用語義快取;對需要最新資料的查詢,則應以文件版本、權限、地區與 TTL 決定是否可重用。命中快取不只降低費用,也可避免尖峰時段讓 GPU推論伺服器 被重複問題塞滿。
快取鍵不能只用使用者文字。企業知識問答至少應納入提示版本、檢索語料版本、使用者權限、語言、模型輸出格式及安全政策版本;否則管理者更新文件或權限後,舊答案仍可能被錯誤送出。對含有個資或租戶資料的回應,快取也要隔離命名空間並設定可稽核的失效流程。
路由器可優先選擇已有上下文前綴快取的模型或節點,以減少長文件重複傳送;但前提是快取命中確實不影響資料隔離。對於輸入相似、輸出需高度正確的任務,快取可只保存檢索結果或摘要,而仍由模型重新生成最終回答,取得速度與新鮮度之間較安全的平衡。
- 快取鍵需包含權限、文件版本、提示版本與政策版本
- 語義快取應設定相似度門檻與高風險排除規則
- 將快取命中率與命中後滿意度一起監控
KV 快取與模型切換的隱性風險
直接答案是:KV 快取通常無法在不同架構、不同權重或不同供應商模型間直接移植,因此模型切換要假設快取會失效。長上下文任務若在中途改用另一模型,可能需要重新編碼整段歷史,造成延遲突然上升,也可能因摘要缺漏而改變回答。這是為什麼工作流路由不能只根據下一次呼叫的價格。
對話或 Agent 應維護與模型無關的狀態層,包括使用者目標、已確認事實、檢索證據、工具輸入輸出、未完成步驟及安全判斷。切換模型時,先將狀態轉為受版本控制的結構化摘要,再由新模型取得必要上下文;這比直接丟入完整聊天紀錄更省 Token,也更容易稽核是否遺漏關鍵限制。
若任務包含分布外上下文,例如罕見內部縮寫、掃描文件或跨系統資料,分類器可能錯估難度。此時可設計「高不確定性升級」:先用輕量模型判斷可讀性與證據不足,再決定是否重新檢索、詢問使用者或升級模型。把不確定性當成路由訊號,能避免低價模型自信地編造答案。
- 跨模型切換前,預設 KV 快取不可重用
- 用結構化任務狀態取代未經整理的長對話歷史
- 將證據不足、罕見詞與工具失敗視為升級訊號
提示壓縮與 RAG 的成本品質取捨
直接答案是先減少無關上下文,再壓縮必要內容。RAG 成本通常來自文件切塊過大、召回過多、重複段落和沒有 metadata 過濾;路由器應依任務決定檢索數量、是否重排序與最大上下文。對只需回答單一規章條文的問題,不必把整本手冊與歷史聊天全部傳進模型。
GPT-4 can use 8,192 tokens to store the conversation history of a chat. 這提醒團隊:歷史訊息雖能保留脈絡,也會持續占用成本與注意力。可將完成的子任務摘要化,保留使用者偏好、已確認約束與引用來源,並在模型切換時驗證摘要是否仍能支援正確決策,而不是把「縮短提示」當成唯一目標。
AI模型量化 與提示壓縮都可能降低成本,但兩者都需要回歸測試。量化模型對結構化輸出、特定語言或長文件引用若出現退化,路由規則應將這些任務排除,或設定自動升級條件。真正的模型推論優化,是在品質、延遲與單位成本三者都有證據的前提下,縮減不必要計算。
- 先以 metadata 過濾與重新排序降低無關檢索內容
- 摘要需保留任務目標、限制、證據來源與未完成步驟
- 壓縮或量化後,必須針對關鍵任務做品質回歸
把模型路由納入 LLMOps平台與治理流程
LLMOps平台為何是路由的控制中心
直接答案是:LLMOps平台讓模型路由從程式碼裡的 if-else,升級為可版本化、可觀測、可稽核的營運能力。平台應串連模型閘道、提示詞註冊表、評估資料集、追蹤資料、成本歸因、部署流程與權限管理;沒有這些共同基礎,團隊即使調出好規則,也難以知道哪次改版造成品質或帳單異常。
市場規模也反映企業正將這件事制度化:LLMOps市場估計為 $5.6 billion in 2024,並預計達到 $35.4 billion by 2030,36.9% 的成長率代表工具與治理需求持續擴大。不過採用平台不等於買到答案;企業仍需定義自己的資料保留、環境隔離、核准流程與路由品質門檻。
平台中的每一筆 trace 至少要串起請求、路由決策、提示版本、檢索區塊、模型呼叫、工具呼叫、Token、延遲、回退與結果評分。當使用者反映答案錯誤,團隊才能重現當時模型與資料狀態;當成本異常,也能判斷是流量成長、快取失效、提示膨脹或供應商價格變動,而非盲目縮減預算。
- 將路由規則、提示、評估集與政策都納入版本控制
- Trace 要可連結檢索、工具、模型、成本與使用者回饋
- 平台功能必須配合組織的權限、保留與稽核責任
建置、採購與遷移成本如何判斷
直接答案是先盤點不可妥協的需求,再選擇託管、開源或自建。若只需要基本追蹤與提示管理,託管平台可快速啟動;若資料不得離開特定區域、需整合內部身分系統或要控制模型閘道,則可能需要混合或自建。選型時要確認 trace、提示版本、評估集和稽核紀錄能否匯出,避免日後被單一平台鎖定。
成本評估不能只看第一年授權。a templated platform launch costs $3,000 to $25,000. A mid-market build with custom design, integrations, and migration runs $40,000 to $100,000. Enterprise and composable builds start around $250,000. 這些區間說明,導入範圍、整合深度和遷移複雜度會顯著影響總成本,應先用 PoC 驗證核心流程。
維運同樣要編入預算:Annual maintenance adds 15% to 20% of the build cost, every year。除了平台費用,還需計入值班、模型與提示升級、資安修補、評估集維護和供應商替換演練。路由器若沒有清楚擁有者,規則很容易隨產品增加而互相衝突,最後反而讓 AI模型監控 失去可用性。
| 方式 | 適用條件 | 優勢 | 主要注意事項 |
|---|---|---|---|
| 託管平台 | 快速驗證 | 啟動迅速 | 資料可攜與區域限制 |
| 開源自管 | 需高度客製 | 掌握資料與架構 | 維運人力與升級責任 |
| 混合架構 | 多雲或敏感資料 | 彈性分流 | 整合與可觀測一致性 |
- 選型前確認資料可攜性、身分整合、區域部署與稽核能力
- 用全生命週期成本比較託管、開源、自建與混合方案
- 為路由規則、評估集和事故處理指定明確責任人
AI模型監控與安全治理不能事後補做
直接答案是把 AI模型監控 設計在請求生命週期內。除了可用性與延遲,還要監控提示注入、敏感資料外洩、拒答率、幻覺回報、模型漂移、路由偏差與異常工具呼叫。高風險功能應保留可追溯的決策證據,例如哪條政策限制了模型池、為何升級模型,以及人工覆核最後如何處理。
模型路由還要能配合資料駐留與租戶政策。不同地區、部門或合約客戶可看到的模型不一定相同,路由器需要在分類前就套用可用模型清單,不能等資料送出後才發現違規。對供應商中斷,應事先演練降級服務、暫停高風險工具、切換自託管模型或明確告知使用者的流程。
治理的關鍵不是阻止迭代,而是讓改動可回溯、可回滾。每次調整成本上限、升級閾值、提示版本或模型池,都應先在隔離環境跑回歸測試,再以小流量金絲雀發布。若品質、延遲或安全指標越界,平台必須能立刻回到上一個已知穩定版本,避免局部試驗擴大為全體事故。
- 監控安全、品質、公平性與成本,不只監控 API 成功率
- 政策應在資料外送前限制模型與供應商選項
- 所有路由變更都要可測試、可審核、可快速回滾
AI模型部署與推論基礎設施的路由設計
何時採 API、自託管或混合部署
直接答案是依流量穩定度、資料敏感度、模型客製需求、延遲目標與維運能力決定,而不是只比較 API 單價。API 適合需求仍在探索、模型更新快速或流量波動大的團隊;自託管適合穩定高流量、資料不得外送或需要深度客製的工作負載;混合部署則讓敏感或高頻任務走內部模型,其餘任務保留外部前沿能力。
AI模型部署 的風險往往在於把硬體採購當成成本終點。Llama 3.1 LLM 具有 4,050 亿个参数,仅推理就需要 810GB 内存(FP16),代表大型模型需考慮多卡切分、記憶體頻寬、併發、冷啟動、容錯與電力。每个高端 GPU 的成本高达 30,000 美元,若利用率不足,自託管未必比 API 划算。
路由器在混合架構中應了解每個端點的即時佇列深度、可用區、GPU 使用率、模型版本與資料政策,再做選擇。例如內部 GPU 忙碌或不支援長上下文時,可升級至符合資料規範的外部端點;反之,重複且可量化的高頻任務可優先走內部服務,穩定壓低邊際成本。
- API 適合快速試驗與波動流量,自託管適合穩定且受管制負載
- 硬體決策需納入記憶體、併發、維運、容錯與利用率
- 混合路由必須同時讀取資料政策與即時基礎設施狀態
GPU推論伺服器如何配合模型分層
直接答案是讓 GPU推論伺服器 承接可預測且可批次化的工作,而把不規則、長尾或尖峰流量交給具彈性的端點。摘要、分類、嵌入與固定格式抽取通常適合排隊與批次;即時客服或互動式程式協作則需保留併發餘裕,並以串流回應縮短使用者感受到的等待時間。模型路由可依 SLA 將兩類流量隔離。
伺服器層應持續看 GPU 利用率、顯存使用量、佇列長度、每秒 Token、首 Token 時間與 P95 延遲。只追求 GPU利用率達到 100% 並非好目標,因為滿載時排隊會放大互動延遲;較穩健的作法是為高優先級租戶或高風險任務保留容量,並在尖峰時啟用雲端或 API 回退。
模型推論優化 也包括批次、連續批次、前綴快取、非同步工具呼叫與輸出長度限制。這些手段要配合路由規則:低優先級背景工作可等待批次,高優先級任務則應限制排隊時間並在超時前切換端點。把排程策略記錄在 trace,才能辨識延遲究竟來自模型、網路還是佇列。
- 依互動性與 SLA 區分即時流量與背景批次流量
- 監控首 Token 時間、佇列與顯存,不以滿載作為唯一目標
- 將排程與端點切換原因寫入 trace,便於除錯與調校
AI模型量化的角色與安全護欄
直接答案是:AI模型量化 能降低記憶體與推論成本,但應把它當作模型池的一個選項,而不是全面替代。量化後模型特別適合分類、摘要、抽取等評估結果穩定的任務;涉及長鏈推理、罕見語言、精確引用或高風險決策時,應以測試結果決定是否升級至較高精度或外部模型。
量化評估至少應比較同一批測試集上的任務成功率、格式錯誤率、引用正確性、首 Token 延遲、每秒 Token 與每次任務成本。若量化模型只在平均分數接近原模型,卻在少數關鍵任務大量失敗,路由器要能依任務標籤排除它。這也是為何評估集必須納入真實長尾案例,而非只用展示範例。
部署時可把量化模型定位為「預檢與一般處理層」,並設定清楚的升級訊號,例如低置信度、工具回傳衝突、檢索證據不足、輸出不符合結構或使用者要求更精確答案。如此一來,團隊能取得量化的效益,同時以可觀測的回退機制守住品質,而不是在事故發生後才被動切回原模型。
- 量化適合經評估確認穩定的高頻、低風險任務
- 用任務分群檢驗退化,不以整體平均分數判定
- 為量化模型設定低信心、格式錯誤與證據不足的升級條件
用 AI PoC 建立可驗證的模型路由藍圖
先用真實流程驗證,而不是直接全面上線
直接答案是以最小範圍的 AI PoC 驗證路由假設,再決定是否擴大投資。選一個有足夠流量、可明確定義成功標準且能取得去識別資料的流程,例如內部知識問答、客服分類或文件摘要;把現行固定模型策略當基準組,測量模型路由後的成功率、延遲、成本與人工修正量。這比先承諾全公司轉型更容易取得決策依據。
ALION 的 AI PoC 開發做法強調從現場調查與實際資料開始,先確認業務痛點、資料前提與使用情境,再以最小配置製作原型。這能避免只在展示資料上看起來順利,正式接上權限、舊系統、例外流程與現場術語後才發現分類規則失準;驗證結果也可以是暫緩或不做,而非勉強進入正式開發。
PoC 應把路由規則、提示版本、測試資料與追蹤欄位設計成可延續資產。後續無論選擇 API、私有 GPU 或混合架構,都能保留同一套任務分類、評估集與品質基線。這種「不丟棄的 PoC」能降低交接損耗,也讓管理階層看到的不只是示範畫面,而是可支持 Go/No-Go 的量化證據。
- 選擇可量測、可取得真實資料且具代表性的單一流程
- 固定模型基準組與路由實驗組需使用相同成功定義
- 將規則、資料契約、評估集與追蹤設計保留為後續資產
四步驟設計可執行的路由 PoC
直接答案是依「目標、範圍、實證、投資判斷」四步推進。第一步先定義 KPI,例如回答正確率不得下降、P95 延遲不得超標、每次成功任務成本要降低;第二步明確列出會接入的資料、模型、工具與不納入範圍。範圍越清楚,越能防止 PoC 被不斷新增需求而失去比較基準。
第三步建立可重播的原型:同一份測試資料能切換固定模型與不同路由策略,並輸出 trace、成本和品質判定。第四步再把結果轉為投資判斷,計算正式環境的流量、平台、GPU、維運與合規成本,同時列出供應商中斷、資料外洩和品質退化時的回退方案,讓決策者看見風險條件。
ALION 的月費訂閱式 AI 上游工程服務為月費 20 萬日圓起,可支援需求梳理、設計文件與示範製作。重點不在套用固定產品,而是由懂 AI 的團隊協助將現場工作流程轉成可驗證假設;若後續進入正式開發,PoC 的架構、原型與評估資料能作為延續基礎,而非重新從零開始。
- KPI 同時涵蓋品質、延遲、成本、安全與人工介入
- 原型需可重播並產生足以比較的 trace 與成本紀錄
- 投資判斷應納入正式維運與事故回退,而非只看展示效果
從 PoC 到正式營運的發布清單
直接答案是將正式化視為一連串受控發布,而不是 PoC 成功後一次切換所有流量。先建立模型與供應商清單、資料分類規範、路由政策、品質評估集、成本預算、監控告警及值班責任;接著以內部使用者、少量租戶與金絲雀流量逐步擴大。每一階段都應能回到固定模型基準,確保故障時仍可維持核心服務。
正式營運後,產品、資料、平台與資安人員要共同檢視儀表板。產品團隊關注解決率與體驗,平台團隊關注延遲、供應商與 GPU,財務關注成本歸因,資安團隊關注資料和政策。若只有單一角色管理路由,常會出現省錢卻損害體驗,或追求品質卻忽略資料治理的失衡。
最後,請把路由策略當成持續學習系統:收集失敗案例、標註造成升級或回退的原因、定期更新評估集,並在模型、價格或業務流程變動時重新驗證。模型路由不是一次性採購功能,而是把模型能力轉化為可控服務的營運紀律;有了這套紀律,才有資格談大規模擴張。
- 採內部、金絲雀、分租戶的順序逐步擴大流量
- 跨產品、平台、財務與資安共同管理路由成果
- 將新失敗案例持續回饋至評估集、政策與回退規則
總結
模型路由的本質,是以可驗證的決策機制,在品質、成本、延遲、資料政策與可用性之間取得平衡。從模型池分層、快取感知、結構化回退,到 LLMOps平台 的追蹤與治理,每個環節都需要用真實任務衡量,而不是依單一模型排名或單價做決定。
重點整理
- 先定義品質與安全底線,再以路由策略追求成本下降。
- 將快取、上下文狀態與回退鏈納入設計,避免模型切換造成失憶。
- 以 trace 串起路由、檢索、工具、Token、延遲與成本,才能有效 AI模型監控。
- 透過小範圍 PoC、A/B 測試與金絲雀發布,將路由風險控制在可回復範圍。
- API、自託管與量化模型應由資料政策、流量型態與全生命週期成本共同決定。
若團隊正面臨模型費用成長、回應品質不穩,或不確定該如何規劃 GPU推論伺服器 與混合部署,建議先選定一個真實業務流程進行 PoC。透過現場訪談、實際資料與明確 KPI,先建立固定模型與路由策略的比較基線,再依結果決定正式架構與投資規模。
常見問題 FAQ
Q1. 模型路由是否等於自動挑選最便宜的模型?
不是。模型路由應在任務品質、延遲、資料政策、模型能力與成本之間做選擇。便宜模型適合低風險高頻任務,但低信心、高風險或複雜推理需求應升級,並保留可稽核的回退機制。
Q2. 小型團隊需要 LLMOps平台 才能做模型路由嗎?
小型團隊可先以模型閘道、結構化日誌、版本化提示與小型評估集起步;當模型、功能、租戶或供應商增加時,再逐步導入完整平台。關鍵是從一開始就能追蹤路由決策、成本與品質結果。
Q3. AI模型量化後,可以直接取代原始模型嗎?
不建議直接全面取代。應先以相同任務集比較量化前後的成功率、格式正確性、引用品質、延遲與成本,再將表現穩定的任務導向量化模型;對高風險或品質敏感任務則保留升級路徑。
Q4. 如何開始驗證模型路由的投資效益?
先選一個具代表性的流程,建立固定模型基準組與路由實驗組,定義正確率、使用者滿意度、P95 延遲、每次成功任務成本與人工介入率。以真實去識別資料進行 PoC,再根據結果決定是否擴大部署。
Q5. 模型路由的參考資料有哪些?
可參考 Microsoft Foundry 的模型路由文件:https://learn.microsoft.com/azure/ai-foundry/ ,OpenTelemetry 的追蹤規範:https://opentelemetry.io/docs/ ,NIST AI RMF:https://www.nist.gov/itl/ai-risk-management-framework ,以及 OWASP LLM 應用安全指引:https://owasp.org/www-project-top-10-for-large-language-model-applications/ 。