2026.10.27
多模態文件解析實戰指南:從辨識到企業知識問答
AI資訊
多模態文件解析不是把 PDF 轉成純文字而已,而是讓系統同時理解頁面上的段落、表格、圖片、圖表、標題與閱讀順序。當採購合約、產品型錄、檢驗報告或掃描表單含有多欄排版與視覺證據時,僅靠傳統 OCR 往往會產生欄位錯配、表格斷裂或數值失真的問題,直接影響後續問答與決策品質。
企業文件的難點通常不在「能否讀到字」,而在於「能否保留原本的語意關係」。例如一張品檢報告中的折線圖、圖例、單位與結論文字必須被連在一起解讀;一份跨頁表格則必須辨識欄位延續與頁尾註記。若系統遺失頁碼、座標或來源區塊,即使回答看似流暢,也難以讓使用者回到原始文件查核。
本文會先說明多模態技術與傳統文字處理的差異,再比較 OCR、VLM OCR 與 Multimodal RAG 的適用情境,接著拆解從上傳、解析、索引、檢索到引用回答的系統流程。最後也會提供評估、資安治理與 PoC 驗證方法,協助團隊用真實資料判斷技術是否值得正式投資。
多模態文件解析是什麼?先理解它解決的問題
從文字擷取進化為版面與證據理解
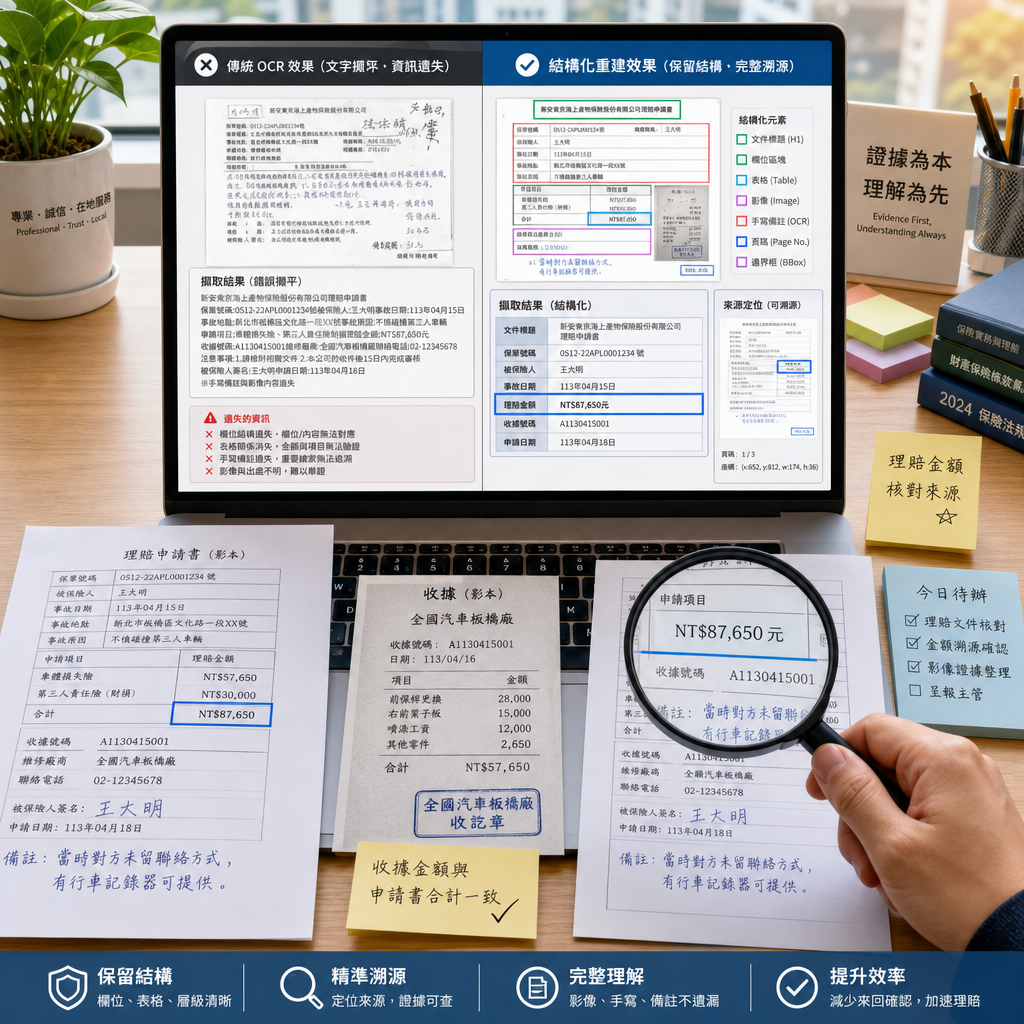
直接來說,多模態文件解析的目標是把文件中的文字、版面、圖像與彼此關係轉換成可檢索、可追溯的結構化資料。傳統文字擷取常將 PDF 視為字元串,容易把左右欄內容交錯拼接;多模態方法則會辨識標題層級、段落邊界、表格儲存格、圖片說明與所在頁面,讓後續模型保有完整脈絡。
以保險理賠文件為例,系統不能只擷取「損害金額」四個字,還必須判斷它對應的是估價表、手寫補充欄,或照片旁的說明。若能保存頁碼、區塊座標與擷取信心分數,客服人員就能在回答爭議時直接定位來源,避免把不同案件或不同欄位的數值混為一談。
文件理解的品質應以可回溯性衡量,而不是只看文字量。建議每個解析區塊都保留文件 ID、頁碼、座標、類型、原始內容與處理版本;這些中繼資料會成為權限判斷、錯誤修正與引用證據的基礎,也能降低生成式回答看似合理卻無法驗證的風險。
- 辨識段落、標題、表格、圖片與圖說的結構關係
- 保留頁碼、座標與來源區塊,讓回答可查核
- 以區塊與證據為單位,而非只以純文字切段
單模態模型與多模態 Agent 的實際差異
最核心的差異是輸入與推理範圍。單模態文字系統通常依賴 OCR 結果或人工整理的文字;多模態 Agent 則能接收 PDF 頁面、JPG/PNG 圖片、WAV 或 MP3 音檔,並依任務決定要先讀文字、看圖表、呼叫搜尋工具,或要求人工覆核。這讓系統更接近人員審閱文件的工作方式。
不過,多模態不等於所有資料都一次送進大型模型。當使用者上傳2MB 以下的單頁憑證,視覺模型可直接辨識;面對數百頁合約或大量歷史檔案,則需要先做版面分區、文字切塊、圖片擷取與索引。輸入路由做得好,才能避免成本與延遲隨檔案量失控。
Agent 的價值在於能根據任務選擇工具,而不是取代既有流程。例如遇到印章、簽名或低解析度掃描件時,可先標記低信心區域,再派送人工覆核;遇到數據圖表時,則要求模型同時回傳圖表標題、座標軸、數值證據與頁碼,建立可稽核的判讀紀錄。
- 文字模型適合已結構化、版面單純的內容
- 視覺模型適合圖文混排、圖表與掃描文件
- Agent 需具備工具路由、信心判斷與人工升級機制
企業最常遇到的複雜文件類型
複雜文件的共通問題是閱讀順序不等於字元順序。雙欄研究報告可能先讀完左欄才讀右欄,然而擷取工具可能把同一水平位置的句子拼在一起;跨頁表格則可能在下一頁省略欄名。若未辨識版面規則,後續向量檢索即使找到關鍵字,也會把錯誤內容提供給模型。
繁體中文與英文混排是另一個常見挑戰。型號、單位、化學式、地址、日期格式與表格縮寫,都可能造成斷詞或欄位辨識問題;手寫內容、低解析度影像、公式、印章與勾選框更需要專門的測試集。正式導入前,應收集實際文件樣本,而非只拿乾淨的公開 PDF 驗證。
製造、醫療、金融與法務文件也常包含圖片證據。品檢照片要連結到缺陷代碼,病理圖要連結到判讀段落,合約附圖要連結到條款編號。設計資料模型時,應把圖片視為一級資料物件,並保留其 caption、相鄰文字與頁面座標,而不是只把圖片當成附件。
- 多欄排版容易造成段落交錯
- 跨頁表格需要辨識欄位延續關係
- 圖片、圖說與相鄰段落必須一起保存
OCR、VLM OCR 與 RAG:如何選擇正確技術路線
OCR 加文字模型適合規則穩定的文件
答案是:若文件版型固定、文字清晰且主要目標是欄位擷取,OCR 加文字模型通常是成本較可控的起點。它適合發票、制式申請表、固定格式報表與純文字合約;團隊可先用 OCR 取得文字與座標,再透過規則或語言模型抽取日期、金額、客戶名稱與條款編號。
這條路線的限制在於 OCR 很難自行理解視覺語意。它可能辨識出圖表旁所有數字,卻無法可靠判定哪個數字屬於哪條曲線;也可能讀到表格內容,卻失去列欄對應。當業務問題需要解讀「圖中趨勢是否上升」或「照片顯示何種瑕疵」時,單純文字管線往往不夠。
實務上可將 OCR 視為基礎層,而非唯一真相來源。每個字詞或區塊都應保留信心值;低信心、異常字元、關鍵欄位缺失或版面偵測失敗的頁面,應自動送往視覺模型或人工隊列。這種分流能讓高量、低風險文件維持效率,同時把昂貴推理留給真正困難的頁面。
- 適合固定版型、清晰文字與明確欄位
- 應保存文字座標與辨識信心值
- 低信心頁面需自動升級至其他處理路徑
VLM OCR 擅長讀懂視覺上下文
VLM OCR 的直接優勢是能同時觀察頁面影像與文字提示,因此較能處理圖文混排、表格、圖表、印章與非制式版面。它不是單純把每個字讀出來,而是能根據使用者任務回答「這張表的第三欄代表什麼」、「圖例中的藍線對應哪個產品」等與視覺關係有關的問題。
但 VLM OCR 不能被當成永遠正確的資料輸入器。圖表數值、細小字體、手寫簽名與模糊掃描影像仍可能被誤讀;若提示只要求摘要,模型可能忽略重要欄位。因此輸出格式應限制為 JSON schema,例如要求回傳欄名、儲存格、單位、頁碼、座標與信心標記,方便程式驗證完整性。
建議建立錯誤分類表,至少區分漏字、閱讀順序錯誤、跨頁表格斷裂、欄位錯配、圖表數值誤讀與來源遺失。每次修正不只要改答案,也要記錄是哪一類錯誤、發生在哪種文件、由哪個模型版本產生。這些紀錄能指引提示詞、前處理與路由規則的優化方向。
- 可理解圖文關係與非規則版面
- 輸出宜限制為可驗證的 JSON 結構
- 錯誤應按類型記錄,而非只統計正確率
Multimodal RAG 用於大規模知識問答
當企業需要跨越大量文件回答問題時,Multimodal RAG 是較完整的做法。它會先解析文件,再將文字區塊、表格描述與圖片表示建立索引;使用者提問後,系統檢索最相關的證據,再要求模型根據證據生成回答。重點不是讓模型憑記憶回答,而是讓回答綁定可見的來源。
檢索設定會明顯影響結果。top_k=5 適合問題明確且文件類型單純的情境;對於跨頁規格書、相似型號或需比較多份報告的任務,top_k=15 較可能找回完整脈絡,但也會提高重複資訊與推理成本。最佳數值必須用實際問題集測試,而不是套用單一預設值。
以下比較可作為初步選型參考,但真正的決策仍應以企業文件、任務正確率、來源引用率與處理成本共同判斷。尤其涉及法務、醫療或財務決策時,系統必須能顯示原始頁面證據,並在找不到足夠依據時明確拒答。
| 項目 | OCR+文字模型 | VLM OCR | Multimodal RAG |
|---|---|---|---|
| 最佳文件 | 固定版型文字 | 圖文混排掃描件 | 大量異質文件庫 |
| 主要任務 | 欄位擷取 | 頁面理解 | 跨文件問答 |
| 視覺證據 | 有限 | 強 | 強且可檢索 |
| 來源追溯 | 座標層級 | 頁面層級 | 區塊與頁面層級 |
- 適合大量文件、跨檔案查詢與可引用回答
- 索引應同時涵蓋文字、表格與圖片證據
- 高風險問題必須設計證據不足時的拒答規則
建立可引用的多模態 RAG 文件管線
輸入路由與前處理決定解析穩定度
可靠的系統會先做輸入路由,再決定解析方式。上傳服務應辨識 MIME 類型、頁數、影像解析度、是否有文字層與檔案大小;PDF 可交由 PyMuPDF 擷取頁面、內嵌圖片與座標,圖片則直接送入視覺解析流程。Base64 適合在 API 呼叫中傳遞內容,但不應取代原始檔案保存與存取控管。
對於長文件,先以頁面為邊界建立中繼資料,再在頁內依標題、段落、表格或圖片切分,通常比固定字數切塊可靠。切塊時應保留前後文連結、章節路徑與相鄰區塊;否則模型可能找到表格數值,卻找不到定義該數值的單位、期間或註解。
影片與音訊也需要明確對齊策略。處理5 分鐘影片時,可先建立畫面時間戳、語音轉錄與關鍵畫格索引;音訊方面,1 秒語音約 25-50 個 Token ID,若未分段與摘要,成本會快速累積。時間戳是讓回答可回到正確片段的重要證據。
- 以 MIME 類型、頁數與文字層決定處理路由
- 以頁面與語意區塊切分,避免固定字數切塊
- 音訊與影片必須保留時間戳對齊資訊
跨模態對齊讓文字、圖片與表格能一起被找回
跨模態對齊的答案很明確:要讓同一頁上的文字、圖片與表格共享可追溯的關聯,而不是各自成為孤立索引。早期融合會在特徵階段結合多種資料;晚期融合則讓文字與影像各自檢索後再整合;中繼融合介於兩者之間,常用注意力機制在推理時建立關聯。
Transformer 的詞元化與注意力機制,讓模型可以根據問題動態聚焦不同證據。例如詢問「哪一項瑕疵最多」時,模型應同時查看檢驗表、圖例與照片說明,而不是只搜尋「瑕疵」文字。為了讓這個過程可控,資料層需提供頁面座標、物件 ID、caption 與區塊鄰接關係。
向量層可採用文字嵌入、影像嵌入或共同嵌入策略。像 multimodal embedding@001 與 text-embedding-005 代表不同索引思路;FAISS (Facebook AI Similarity Search) 則可作為向量近鄰搜尋元件。無論使用哪種工具,都應在同一份測試集比較召回率、引用正確率、延遲與單頁成本。
- 對齊需保存物件、頁面、座標與相鄰關係
- 融合方式應依任務與資料量選擇
- 向量索引要以召回與引用品質驗證
上下文管理避免長文件造成成本失控
長上下文不是把所有內容塞給模型,而是以分層摘要與漸進式擴展取得足夠證據。主流模型已支持200K 乃至 1M+ tokens 的上下文窗口,相較傳統模型(4K-128K)能容納更多內容;但可放入不代表應全部放入,因為無關內容仍會增加費用、延遲與注意力分散。
實務上可先以文件摘要找出相關章節,再檢索頁面區塊,最後才加入圖片或完整表格。對話記憶也應區分短期工作上下文與長期可檢索紀錄;一般客服常見的10-20 輪對話,不宜直接與需要數百輪歷史紀錄的稽核任務採用同一策略。
建立上下文預算時,應把系統指令、問題、檢索證據、圖片表示與輸出額度一起計算。若要求模型輸出完整結構化結果,max_tokens=4096 可作為明確的輸出上限設定;但對短答案而言,過大的上限並不會提升品質。應根據任務設計限制與驗證規則。
- 採用摘要、檢索、擴展的分層上下文策略
- 上下文視窗大不代表需要全文投入
- 輸入與輸出 Token 預算都要納入成本設計
多模態文件解析的評估方法與真實案例
不要只測辨識率,要測任務是否可用
評估多模態文件解析時,最重要的答案是:必須分開測量解析品質、檢索品質與回答品質。只有 OCR 字元正確率高,並不代表系統能正確回答問題;一張表格若欄位位置錯置,即使每個字都辨識正確,最後的金額、日期或品項仍可能被錯誤配對。
建議建立含繁體中文、英文混排、掃描 PDF、手寫欄位、公式、印章、低解析度圖片與跨頁表格的黃金測試集。每份文件要配置標準答案、對應頁碼、區塊座標與可接受的回答範圍;再以同一批資料比較 OCR 加 LLM、VLM OCR 與 RAG,避免不同資料集造成看似優秀的假象。
核心指標至少包括文字與欄位正確率、表格結構正確率、圖表數值判讀率、檢索召回率、引用正確率、平均延遲與每頁成本。若企業目標是自動化審核,還要統計人工介入率與錯誤攔截率。目標不該只追求80% 以上的單一分數,而是確認哪些錯誤可接受、哪些錯誤必須零容忍。
- 分開衡量解析、檢索與回答三層品質
- 測試集要涵蓋企業真實的困難文件
- 高風險任務需定義零容忍錯誤類型
以錯誤分類建立可持續改善循環
最有效的改善方式不是反覆更換模型,而是先找出錯誤發生位置。若答案錯誤,團隊應追問:原始頁面是否模糊?OCR 是否漏字?版面順序是否錯誤?切塊是否遺失前後文?檢索是否沒找回證據?還是模型看見證據後仍做出錯誤推論?每一類問題的補救方法不同。
例如,表格跨頁造成欄位錯配時,可在解析階段偵測相似欄名、表格邊界與上一頁末列,建立延續關係;圖表數值誤讀時,則應要求系統標示座標軸、單位、資料點與圖例,並把低信心判讀送到人工核可。這比單純要求模型「再仔細看一次」更可靠。
錯誤修正應回饋到版本化流程,包括文件前處理設定、提示詞、模型版本、索引方式與驗證規則。若系統在特定文件上反覆失敗,應將其加入回歸測試集。這能確保修正新問題時,不會讓原本已能處理的發票、表單或規格書再次退化。
- 先定位錯誤層級,再選擇修正手段
- 表格、圖表與來源遺失應有專屬補救流程
- 所有修正都要進入版本化回歸測試
從現場流程驗證商業價值
可行的案例不只展示模型能回答問題,還要證明它能縮短流程並降低風險。例如採購人員查詢供應商規格時,系統可從型錄、合約與測試報告找出證據並標示頁碼;品保人員則可依照片、檢驗表與歷史異常紀錄,快速建立需覆核的項目清單,而不是直接自動判定。
ALION 的 AI PoC 方法強調以實際資料與實際業務環境驗證。流程可從現場調查開始,明確定義成功 KPI、驗證範圍與不做的項目,再以可運作原型測試精度、使用體驗與效益。這種做法能避免需求尚未釐清,就因為看見展示效果而直接投入完整系統開發。
判斷是否進入正式開發時,應把節省的查找時間、人工覆核量、錯誤攔截率、資料維護成本與合規風險一起納入。若 PoC 結果顯示文件品質不足、使用者不信任回答,或維護成本高於效益,提出暫緩或不做的建議,同樣是降低投資損失的重要成果。
- 以流程時間、覆核量與風險降低衡量價值
- PoC 應使用真實資料與真實問句
- Go/No-Go 必須有可量化的判斷依據
部署、治理與 PoC:讓文件 AI 能安全上線
權限繼承與資料隔離是第一優先
企業部署的直接原則是:檢索權限必須繼承原始文件權限。使用者在原本的檔案庫無權查看某份合約,就不應透過聊天介面取得其中片段、摘要或向量搜尋結果。系統需在文件、區塊、索引與回答四個層次執行相同的存取控制,避免資料在向量庫階段失去保護。
對含個資、財務或商業機密的文件,建議在進入模型前執行 PII 遮罩、敏感等級標記與租戶隔離。加密不只適用於傳輸與儲存,也要考量暫存檔、圖片轉檔、除錯紀錄與備份。資料落地位置、保留時間與供應商資料政策,皆應由法務、資安與業務共同確認。
稽核日誌應記錄誰上傳、誰查詢、系統檢索了哪些來源、模型使用哪個版本、是否觸發遮罩或拒答。這些紀錄不只是事故追查工具,也能協助改善回答品質。當使用者質疑答案時,團隊必須能重現當時的檢索證據與設定,而不是只能重新執行一次。
- 權限必須從原始文件一路繼承至回答
- 敏感資料需遮罩、隔離與全流程加密
- 稽核日誌要能重現查詢與證據鏈
人機協作與拒答規則降低高風險幻覺
高風險文件任務不應追求完全自動化,而應優先設計正確的人機協作邊界。當檢索證據不足、關鍵欄位信心過低、文件版本衝突或問題涉及法律與醫療判斷時,系統應顯示不確定性、列出已找到的證據,並轉交具權責的人員決定,而不是產生看似肯定的結論。
信心門檻需要從實測資料校準。可將結果分為可自動完成、需使用者確認、必須人工複核三類,並針對金額、日期、姓名、合約條款、檢驗數值等關鍵欄位採用較嚴格規則。安全護欄也要防範提示注入,例如文件內藏有要求模型忽略規則的文字時,不得改變系統權限或輸出政策。
使用者介面應讓人容易看到來源,而不是只看到一段自然語言答案。每個結論旁應提供頁碼、文件名稱、區塊預覽與原始頁面連結;若回答來自推論而非文件明示,也要清楚標記。透明的證據呈現能建立信任,並讓現場人員更快發現解析或檢索錯誤。
- 證據不足、低信心與高風險問題應自動升級
- 關鍵欄位需採取比一般文字更嚴格的門檻
- 回答介面必須顯示來源與推論界線
以小規模 PoC 取得正式投資依據
最務實的起點是選擇一個可衡量、可取得資料、且現場人員願意參與的流程進行 PoC。範圍可先限定在最多10-50 頁的代表性文件與固定問題集,驗證表格、圖片、圖表與引用能力,再逐步擴大至跨文件檢索。這能避免一開始就把所有歷史資料匯入,卻沒有清楚的成功標準。
ALION 提供的 AI 上游工程訂閱服務以月費 20 萬日圓起支援需求梳理、設計文件與示範製作,並可透過每週一次定期會議,將現場回饋轉成可測試的假設。相較於在可行性未明前就投入大型開發,這種小規模驗證更適合需要兼顧技術、流程與預算決策的團隊。
PoC 結案報告應明確呈現資料範圍、任務成功率、引用品質、人工覆核率、延遲、成本與資安限制,並提出 Go、再次驗證或 No-Go 建議。若後續進入正式開發,解析 schema、測試集、權限模型、原型程式與錯誤分類紀錄都應成為可延續資產,而非一次性的展示成果。
- 先用代表性文件與固定問題集縮小驗證範圍
- PoC 同時驗證精度、現場使用性與投資效益
- 將原型、測試集與設計文件保留為正式開發資產
總結
多模態文件解析的真正價值,在於把原本難以查找、難以驗證的圖文文件,轉為可理解、可檢索且可引用的企業知識。成功關鍵不只是選到視覺模型,而是從文件結構、跨模態對齊、檢索證據、錯誤分類、權限治理到人工覆核,建立能在真實現場運作的完整閉環。
重點整理
- 先以文件類型與任務風險選擇 OCR、VLM OCR 或 Multimodal RAG。
- 解析結果必須保存頁碼、座標、區塊與來源關係,才能提供可驗證答案。
- 評估需同時衡量解析、檢索、引用、延遲、成本與人工覆核率。
- 以真實文件進行小規模 PoC,可降低正式開發前的技術與投資風險。
- 權限繼承、敏感資料保護、稽核日誌與拒答規則是企業上線必要條件。
若您的團隊正面臨掃描 PDF、跨頁表格、圖表判讀或文件問答可信度不足的問題,建議先盤點一條具體業務流程與代表性文件。透過現場訪談、測試集與可量化 KPI 建立 PoC,能更快確認技術上是否可行,以及應該正式開發、補強資料治理,或暫緩投入。
常見問題 FAQ
Q1. 多模態文件解析和一般 OCR 有什麼差別?
一般 OCR 主要將影像中的字轉成文字;多模態方法還會理解版面、表格、圖片、圖說與視覺關係,較適合非制式 PDF、圖文混排與圖表判讀任務。
Q2. 企業導入時,應先選 VLM OCR 還是 Multimodal RAG?
若目標是理解單份複雜文件或擷取非制式欄位,可先測試 VLM OCR;若要跨大量文件進行問答、保留引用來源與權限控管,則應規劃 Multimodal RAG 管線。
Q3. 如何避免文件問答系統產生幻覺?
要求回答綁定頁碼與來源區塊,設定證據不足時拒答,並將低信心的金額、日期、條款或圖表判讀送交人工覆核。同時保留檢索與模型版本日誌以供追查。
Q4. PoC 階段最需要準備什麼?
優先準備具代表性的真實文件、現場常問問題、正確答案與可量化 KPI。也要定義哪些錯誤不可接受、哪些情境需人工覆核,以及資料權限與敏感資訊處理方式。
Q5. 哪些官方資料可協助團隊延伸實作?
可參考 Google Cloud Document AI:https://cloud.google.com/document-ai/docs 、OpenAI 文件:https://platform.openai.com/docs 、PyMuPDF 文件:https://pymupdf.readthedocs.io/ 、FAISS 專案:https://github.com/facebookresearch/faiss 。