2026.11.09
OCR文件辨識如何把紙本流程變成可驗收的資料服務
AI資訊
OCR文件辨識真正要解決的,不是「能不能讀出文字」,而是能否把訂單、發票、檢驗報告與合約中的關鍵欄位,穩定送進既有系統並留下可稽核紀錄。若辨識結果無法判斷可信度、無法處理印章遮字或中英數混排,再高的展示效果也很難落地為日常流程。
對製造、貿易、零售與專業服務業而言,紙本與掃描 PDF 常卡在收件、登錄、覆核、歸檔及查詢等環節。OCR(Optical Character Recognition,光學文字辨識)能將影像轉為機器可讀文字,但企業導入時還要面對欄位驗證、權限、個資、例外處理與 ERP/CRM 串接,才能真正減少人工搬運資料。
本文會先說明 OCR 的處理原理與適用邊界,再拆解文件智慧擷取的生產流程、繁體中文文件的測試方法、多模態文件解析與企業知識庫架構,最後提供 AI PoC 成功指標與上線治理清單。讀完後,你可以用一致的尺度評估工具、資料品質與投資優先順序。
OCR文件辨識的核心:先把影像變成可驗證資料
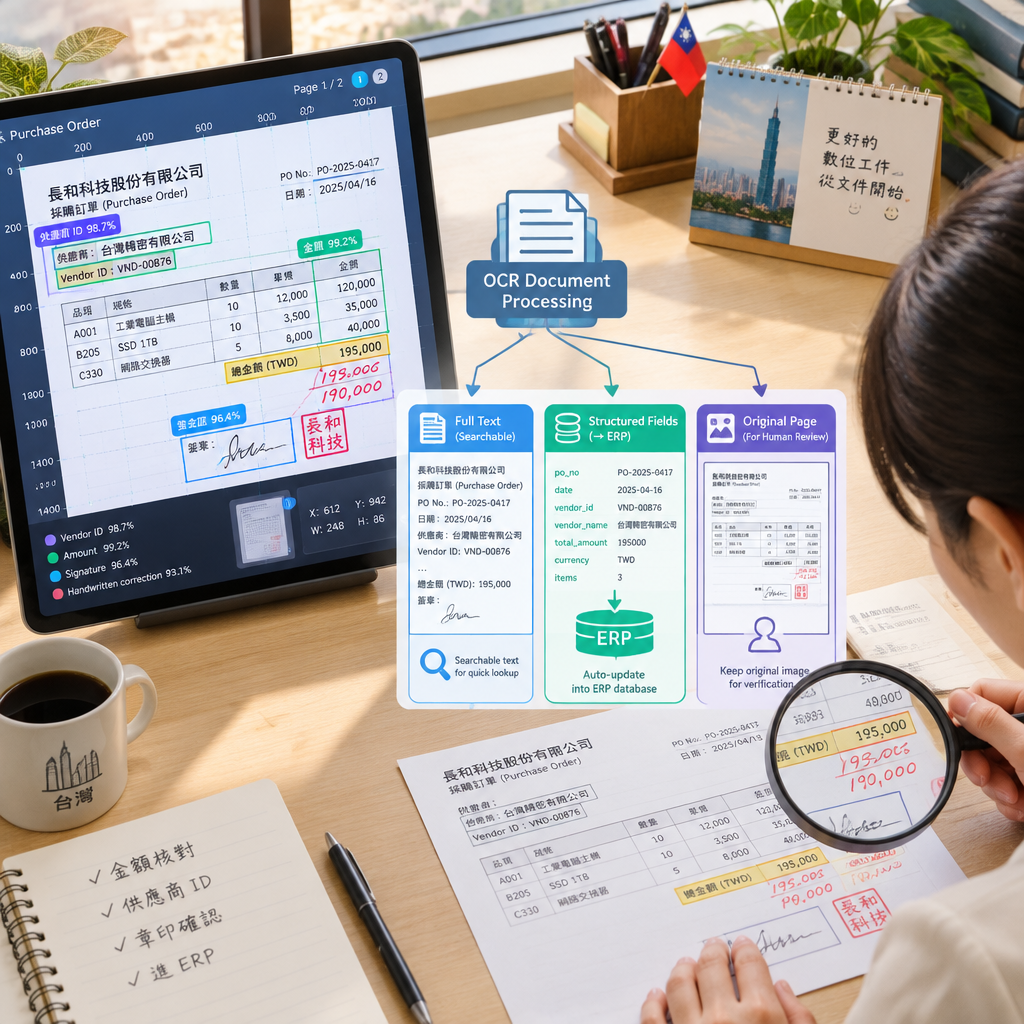
OCR 的輸出不應只是一段可複製文字
直接來說,OCR文件辨識的基本任務是將圖片、掃描檔或 PDF 中的字元轉成數位文字;企業真正需要的成果,則是帶有頁碼、座標、信賴度與欄位名稱的資料。單純文字檔雖可搜尋,卻無法確認「總金額」是否來自正確欄位,也難以追溯原始畫面,因此不適合作為付款、庫存或合約判斷的唯一依據。
完整流程通常包含影像採集、前處理、文字辨識、版面分析、欄位驗證與匯出。前處理會做二值化、降噪、傾斜校正及文字分割;版面分析則辨識標題、段落、表格、勾選框與簽名區。最後不是只執行「6. 文本輸出:最後將處理好的文本輸出,以便進一步使用或儲存。」而是同步保留來源位置與處理版本。
實務上可把輸出分成三層:全文文字供搜尋、結構化欄位供系統寫入、原始頁面供覆核。以採購單為例,品名可供全文檢索,供應商統編與金額可寫入 ERP,而印章、塗改或異常批註仍須讓人員查看原檔。這種設計可避免自動化把錯字一路傳遞到後續採購、對帳或付款流程。
- 文字層:支援全文搜尋與內容摘要
- 欄位層:保存鍵值對、表格列與信賴度
- 證據層:保留頁碼、座標、影像與處理版本
辨識品質先看文件條件,再看模型名稱
直接答案是,清晰度、版面一致性與字體品質,通常比模型宣稱的能力更能決定辨識結果。低解析度掃描、陰影、折痕、手寫註記與紅色印章,會讓字元切分與欄位定位同時失敗。企業應先要求掃描端穩定輸出 300dpi,並區分可直接辨識的原生 PDF 與必須影像化處理的掃描 PDF。
繁體中文情境還要特別測試直排文字、相似字、中英數混排、日期格式與身分證字號。像「O/0」、「I/1」、「已/己」這類錯誤,若落在料號、統編或帳號欄位,後果比一般敘述文字嚴重。解法不是一味提高自動通過率,而是以欄位規則、字典、校驗碼與人工覆核佇列建立多層防線。
建議以同一批實際文件建立驗收集,至少包含印刷體、手寫欄、低品質掃描、表格、印章遮字與勾選框。測試時應分別計算字元正確率、欄位完全正確率、整份文件通過率與人工覆核率;只公布平均正確率,往往會掩蓋高風險欄位的失敗情形。
- 掃描規格與文件來源需納入驗收條件
- 金額、統編與日期應設格式及邏輯校驗
- 低信賴度欄位必須能回看原始座標
OCR 類型應依資料型態選擇
直接來說,OCR 不只有單一技術。簡易 OCR 適合印刷清楚且版面固定的文件;智慧字元辨識較能處理個別手寫字元;智慧文字辨識用於連續手寫內容;光學標記辨識則專門判斷勾選框、問卷塗記或選項。企業若把不同任務全部交給同一種模型,通常會在例外文件上付出更高的人工作業成本。
金融、保險與醫療文件常同時包含印刷欄位、手寫簽名和勾選選項,因此需要把文字擷取、標記判讀與簽名存在性檢查拆開驗證。簽名欄尤其不宜直接當成身分驗證結果;系統可判斷「是否有筆跡」,但是否為本人簽署,仍是另一個需要管理規範與人工判定的問題。
選型前應將文件依固定表單、半結構化表單與非結構化長文件分流。固定表單可利用欄位座標提高效率;半結構化文件需要分類及鍵值配對;合約、報告等長文件則適合加上段落、條款和表格解析。先完成分類,能避免後段模型在不相干的文件上耗費成本。
- 固定格式:優先使用版型與欄位定位
- 手寫與勾選:拆分為獨立辨識任務
- 長文件:保留段落、表格與頁碼結構
文件智慧擷取要用欄位規則完成最後一哩
文件智慧擷取把辨識結果轉成可用交易資料
直接答案是,文件智慧擷取比 OCR 多了一層「理解與驗證」:它會分類文件、找出鍵值對、解析表格,並將結果以 JSON 或 API 寫回 ERP、CRM 或內容管理系統。例如發票不只要讀到數字,還要判斷哪一組是發票號碼、含稅總額、供應商名稱與付款期限,並檢查欄位彼此是否合理。
主流雲端服務的版本管理也必須列入導入範圍。Azure AI Document Intelligence 可使用 v4.0(2024-11-30)及 v3.1(2023-07-31)等版本,呼叫端會明確指定 api-version=2024-11-30 或 api-version=2023-07-31。模型升級可能改變欄位位置、信賴度與表格輸出,不能只因新版可用就直接切換正式流程。
若結果回傳 confidence”: 0.99、confidence”: 0.98 或 confidence”: 0.91,不代表所有欄位可用同一門檻。金額、帳號與日期應採較高門檻並搭配格式檢查;品名等可搜尋欄位可容許較低門檻。重要的是把門檻與人工覆核原因記錄下來,日後才能分析錯誤來自掃描品質、版型變動或模型漂移。
- 將文件分類、欄位擷取與規則驗證分層設計
- 模型版本更換前必做同批文件回歸測試
- 信賴度門檻要隨欄位風險而異
生產流程必須有失敗重試與稽核軌跡
直接答案是,一套可正式營運的流程至少要有上傳檢查、惡意檔掃描、文件分類、模型推論、欄位驗證、人工覆核、系統寫回與稽核留存。檔案上傳成功不表示資料可入帳;若格式錯誤、頁面缺漏或欄位未通過規則,系統應停在例外佇列,而非默默輸出空值或以猜測值覆蓋原資料。
表格擷取尤其要保存結構資訊。當結果包含 row_count”: 3、column_count”: 4、width”: 1000、height”: 800 時,這些不只是技術細節,而是日後回看「某筆金額在哪一列、哪一欄」的證據。跨頁表格則須附上頁面關係與合併邏輯,否則匯入庫存或報價單時很容易把列資料切斷。
建議設定可重跑的處理識別碼:保存原始檔雜湊、模型版本、提示詞或規則版本、輸入時間、輸出 JSON 與人工修正紀錄。當供應商換版型或模型升級後,團隊才能只重跑受影響的文件,而不是重新處理所有歷史檔案。這也是內控稽核追問資料來源時最重要的可追溯能力。
- 例外文件不可直接寫入核心系統
- 每次推論都需保存來源、版本與處理結果
- 人工修正應成為後續規則改善的依據
預建模型與自訂模型的取捨要先量化
直接答案是,版型常見且欄位定義明確時,預建模型通常能更快驗證;文件種類多、企業欄位特殊或格式持續變動時,才需要自訂分類或自訂擷取。像收據型號 v3.0 支援處理單頁飯店收據,但若企業的費用憑證含多頁明細、內部專案碼或特殊稅別,就應先確認是否需要額外規則或模型化處理。
成本評估不能只看每頁辨識單價。高解析度、公式、條碼等功能可能提升結果,但高級功能會產生額外費用;同時還有影像轉檔、儲存、人工覆核、錯誤重處理與系統串接成本。先以每月文件量、平均頁數、例外比例和高風險欄位數量,估算端到端成本,才能避免 PoC 與正式營運落差過大。
如果文件量尚不明確,先用代表性樣本做小規模驗證比全面採購更穩健。可參考AI流程自動化指南:傳統企業如何盤點高價值流程、串接既有系統並衡量效益,先找出重複輸入、高錯誤成本且規則可描述的環節,再決定是採用 API、離線引擎或混合式架構。
- 常見單據先測預建模型,特殊欄位再評估自訂
- 把人工覆核與重處理納入總成本
- 以實際文件量與例外率決定正式架構
多模態文件解析讓表格、圖表與頁面脈絡一起被理解
多模態文件解析適合 OCR 無法完整回答的問題
直接答案是,多模態文件解析會同時保留文字、版面、表格、圖表與圖片內容,適用於需要理解關係而非只擷取欄位的場景。舉例來說,檢驗報告中的曲線圖、圖說與結論分散在不同區塊;若只取出文字,系統可能找得到數字,卻不知道數字對應哪個樣本、單位或門檻。
傳統 OCR 的強項是快速讀字,版面模型的強項是還原段落與表格,視覺語言模型則能根據頁面圖像回答圖表與圖示問題。這三者不必互斥:可先以 OCR 建立可搜尋文本,再針對含圖表、複雜表格或低品質頁面啟動視覺模型。如此能在品質、延遲與成本間取得較務實的平衡。
模型選擇要看實際任務,而非只看參數量。市場上常見 3B,7B,72B 等規模;資料評測中曾描述「72B 模型与 GPT-4o 和 Claude 3.5 Sonnet 相当」,但企業仍應以自家繁體中文文件測試引用正確率、欄位正確率和回覆忠實性。模型在公開資料集的表現,不能取代你的印章、直排與跨頁表格測試。
- OCR、版面解析與視覺模型可採分層處理
- 圖表與跨頁關係應保留原始頁面證據
- 公開評測不能取代企業文件驗收集
解析後的資料結構決定能否被檢索與引用
直接答案是,解析品質不只取決於模型,也取決於你是否保存正確的 schema。每個區塊應至少有文件 ID、頁碼、閱讀順序、座標、文字內容、表格結構、圖片連結、父子關係與權限標籤。這使聊天機器人回答問題時,能附上來源頁面,而不是只產生看似合理卻無法核對的結論。
多模態 RAG 可將段落、表格和圖像分別建立索引,再以共同文件識別碼串起來。文字問題優先檢索文字與表格;詢問「圖中趨勢」時,則取回原圖與圖說。保留原始頁面圖片雖增加儲存和推論成本,卻能在稽核、法務或品質異常處理時提供必要的上下文。
解析工具與模型版本也應受控。例如技術整理可見「Updated on 2025-03-29: Add SmolDocling & VLM Summary」,而某些工具輸出會標示 olmocr-version: 0.1.58。這類版本資訊應隨索引保存,因為同一份 PDF 重新解析後,段落切分或表格欄位可能改變,進而影響檢索排名與既有答案。
- 每個區塊都要能回溯至文件與頁面
- 依問題型態檢索文字、表格或原始圖片
- 解析版本需與向量索引版本一併管理
成本與延遲要用整條管線估算
直接答案是,多模態處理的成本不是只有模型 API 費用,還包括 PDF 轉圖片、視覺 token、向量化、儲存、重試、快取與人工覆核。部分服務的基礎版價格為 1000 頁/美元,但這只是一個起點;高解析頁面、長文件與圖表密集文件,都可能增加實際處理量與回應時間。
在互動式查詢中,單頁或小型文件可能做到 5~10 sec,但批次處理長文件時差異很大。公開測試曾以实际测试共72页pdf(arxiv论文),使用Nvidia-L4 GPU,得到总耗时40min;這提醒決策者,正式環境必須規劃佇列、非同步任務、失敗重試與尖峰時段的容量,而不是以單次展示速度估計服務能力。
若要比較雲端與自建,還需計入硬體、人力及可觀測性。曾有成本案例列出 $323.20,卻不能直接套用到不同文件量;你的試算應分別列出每千頁解析、每千次問答、向量儲存與覆核分鐘數。只有把例外率放入模型,才能看清看似便宜的方案是否因人工修正而失去優勢。
| 項目 | 傳統 OCR | 文件模型 | 多模態解析 |
|---|---|---|---|
| 主要輸出 | 文字 | 欄位與表格 | 文字、圖表與版面關係 |
| 適用文件 | 清楚印刷文件 | 發票與表單 | 報告、圖表與複雜 PDF |
| 人工覆核焦點 | 字元錯誤 | 欄位與規則 | 引用與視覺脈絡 |
| 成本控制 | 低 | 中 | 依頁面複雜度變動 |
- 成本模型需納入影像化、索引與人工覆核
- 批次長文件應採非同步佇列與可重試設計
- 比較方案時以每千頁與每千次查詢共同衡量
AI資料標註與品質控管是提高自動化率的基礎
AI資料標註應優先標註高風險決策欄位
直接答案是,AI資料標註不必從標滿所有文字開始,而應先標記會影響付款、出貨、法遵或客訴的欄位。例如供應商統編、訂單號碼、金額、日期、料號、勾選結果與簽名區,比描述性備註更值得投入雙人複核。標註規範若不清楚,模型即使學到大量樣本,也只會穩定地複製不一致的判斷。
好的標註指南應定義欄位邊界、跨頁合併規則、遮擋處理、空值表示法與格式正規化方式。以日期為例,必須明定要保留原文、轉為標準格式,還是兩者並存;以金額為例,必須區分未稅、稅額、含稅總額與幣別。這些規則同時是模型訓練規格、人工覆核依據與系統整合契約。
品質抽檢不該只看標註者是否完成任務,而要看標註一致性與商業風險。建議建立黃金集,定期讓不同人員標註同一批文件,找出容易產生歧義的欄位。當模型與人工結果不一致時,也要區分是模型錯、規則不完整,或原始文件本身無法判定,避免把不確定性誤當成模型缺陷。
- 先處理金額、日期、料號等高風險欄位
- 標註規範需涵蓋遮擋、跨頁與空值情境
- 以黃金集衡量人員與模型的一致性
以欄位級指標取代模糊的整體準確率
直接答案是,驗收應同時看 precision、recall、欄位完全正確率、整份文件通過率與人工覆核率。若系統只擷取到容易辨識的供應商名稱,卻漏掉付款期限,平均分數仍可能好看,但業務流程不能自動化。對每個欄位定義「錯一碼是否可接受」,才能把技術結果轉成可簽核的營運指標。
以發票處理為例,可設定總金額與統編必須完全相符、品項名稱可採較寬鬆文字比對、地址僅做搜尋用途。接著量測自動通過文件比例及人工每份平均處理時間。若自動通過率增加,卻讓覆核人員花更多時間找錯誤,整體效益仍可能下降,因此 KPI 需要連結工作量與錯誤成本。
模型漂移也應以同一套指標監測。供應商更換表單、掃描設備老化、文件語言改變或模型版本升級,都可能讓原本穩定的欄位突然下降。建議按週或按月抽樣,將高風險欄位與黃金集結果做趨勢追蹤,門檻一旦跌破就切回人工覆核或上一版模型。
- 將關鍵欄位設定為完全正確的嚴格標準
- KPI 要同時衡量自動通過與人工耗時
- 持續監控版型與模型造成的品質漂移
人工覆核不是失敗,而是可控的安全閥
直接答案是,人工覆核應設計成系統的一部分,而非導入失敗後的臨時補救。當欄位信賴度低於門檻、規則驗證失敗、文件類別不明或偵測到敏感資訊時,系統應自動建立任務,將低信賴度區塊高亮顯示,讓人員只需確認有疑慮的內容,而不用重打整份文件。
覆核畫面要同時呈現原始影像、辨識結果、候選值、規則提示與歷史修正紀錄。若系統將「8」誤讀為「3」,人員修正後應能標記錯誤類型,例如影像模糊、印章遮擋或版型改版。累積這些原因碼,才知道下一輪該改善掃描規格、補資料,還是修改欄位規則。
權限控管同樣不可忽略。含有身分證、薪資、病歷或客戶帳戶資訊的文件,覆核者只應看到完成工作所需的最小資訊;下載、查閱與修正都要留下紀錄。若採雲端服務,還需確認資料保存位置、保留期限、加密方式與是否會被用於模型訓練,避免資料治理在上線後才補救。
- 以高亮來源區塊縮短人工覆核時間
- 為人工修正建立可分析的錯誤原因碼
- 敏感文件需落實最小權限與操作留痕
多模態AI開發到企業知識庫:用 PoC 驗證可營運性
多模態AI開發要從業務假設開始,而非先選模型
直接答案是,多模態AI開發應先回答「哪個決策或查詢會因文件理解而變快、更準」,再選擇模型與工具。以製造業為例,可先驗證檢驗報告能否自動找出異常項目及其來源頁;以貿易業為例,可驗證合約、報價單與裝箱單是否能交叉比對。若業務問題不清楚,再強的模型也很難形成可驗收成果。
PoC 的目標不應只是做出聊天介面,而是以實際文件和實際使用者驗證 KPI。可設定「關鍵欄位完全正確率」、「回答附來源頁比例」、「人工查找時間」、「低信賴度回退率」及「例外案件處理時間」。當結果未達門檻時,做出 No-Go 或縮小範圍的決定同樣有價值,能避免未驗證就投入大型正式開發。
企業可採小規模、短週期的方式完成驗證:先選一種文件、兩到三個高價值問題、一條明確的資料流與一組使用者。ALION 的 AI PoC 支援採用貼近實際資料與環境的原型驗證,並將需求定義、架構設計與示範成果保留為後續資產;其 AI 上游工程訂閱服務月費 20 萬日圓起,適合在正式開發前先建立 Go/No-Go 證據。
- 先定義業務問題與驗收 KPI,再挑選模型
- PoC 必須使用真實文件與真實使用情境
- No-Go 結論也能避免錯誤投資擴大
企業知識庫要讓答案可追溯且符合權限
直接答案是,企業知識庫不是把所有 PDF 丟進向量資料庫,而是要讓每段內容帶著來源、版本、權限與有效期限。使用者詢問採購條款時,系統應引用正確合約版本與頁碼;若文件已失效或使用者無權查看,檢索層就不應把內容提供給生成模型,否則再好的回答也可能造成資訊外洩。
建立知識庫時,應把 OCR 文字、表格結構、圖片描述與原始頁面建立關聯,並在回答中提供可開啟的引用來源。這能降低幻覺風險,也讓法務、品保或業務能快速核對。對於數字、條款和圖表結論,系統應優先引用原始區塊;若找不到足夠證據,應明確回答無法確認,而不是自行補完。
權限要繼承既有文件系統或至少同步部門、專案與文件等級。刪除原始文件時,文字索引、圖片快取與向量資料也要一併移除;文件更新時,則採增量重新解析與索引。這些資料血緣要求看似繁瑣,卻是企業知識庫從展示型聊天機器人走向日常營運的必要條件。
- 每段知識都要有來源頁、版本與權限標籤
- 關鍵答案必須能回到原始文件核對
- 刪除與更新需同步影響所有衍生索引
從 PoC 走向正式營運需要 LLMOps 與內控制度
直接答案是,正式上線後最需要補足的能力是持續監控,而不是只增加功能。團隊應追蹤文件量、處理延遲、欄位通過率、人工覆核率、問答引用率、使用者回饋與單位成本;模型、解析器、提示詞和欄位規則都要版本化。這類 LLMOps 機制可讓問題發生時快速定位是資料、模型還是系統串接造成。
專案治理則要明確分工:業務單位定義錯誤可接受範圍與例外流程,資訊單位負責身分驗證、整合與監控,法務或資安單位審查資料處理邊界,資料與 AI 團隊管理評測集及模型變更。若只交由單一部門維護,流程一旦遇到稽核、資安事件或版型大改,往往無法快速做出一致決策。
建議把正式化分為三道關卡:先確認技術可行性,再確認現場人員願意採用,最後確認成本、風險與維運責任可被長期承擔。每次變更前以黃金集回歸測試,變更後觀察一段期間的例外率,並保留回滾方案。如此才能讓文件自動化從一次性專案,成為可持續改善的營運能力。
- 以版本、指標與告警建立 LLMOps 基礎
- 業務、資訊、資安與資料團隊需共同治理
- 每次變更都要可測試、可追蹤與可回滾
總結
OCR文件辨識的價值不在於把紙本變成文字,而在於以可驗收的欄位、可追溯的來源與可控制的例外流程,讓資料能安全進入企業作業。從影像品質、文件智慧擷取到多模態解析與知識庫,每一層都需要明確的資料結構、門檻與治理設計。
重點整理
- 先以實際文件建立包含印章、手寫、表格與低品質掃描的驗收集。
- 用欄位完全正確率、人工覆核率與錯誤成本評估成效,不只看平均準確率。
- 將低信賴度結果導向人工覆核,並保存版本、來源與修正紀錄。
- 知識庫回答必須附來源頁並遵守原始文件權限。
- 以小規模 PoC 驗證技術、流程與投資效益後,再進入正式開發。
若你的團隊正被發票、訂單、檢驗報告或合約登錄作業卡住,建議先挑選一種高頻、高錯誤成本的文件,整理真實樣本與目前人工處理時間,再設定可量測的成功門檻。以小範圍 PoC 驗證後,你會更清楚該採用 OCR、文件模型或多模態架構,以及哪些例外應保留給人員判斷。
常見問題 FAQ
Q1. OCR文件辨識與文件智慧擷取有什麼差別?
OCR 著重將影像中的字元轉成文字;文件智慧擷取則進一步辨識文件類型、欄位、表格與鍵值關係,並以規則與信賴度控制結果後寫入企業系統。官方功能與版本說明可參考 https://learn.microsoft.com/azure/ai-services/document-intelligence/ 。
Q2. 企業導入 OCR 時,為什麼不能只看準確率?
平均準確率無法反映金額、日期、統編等關鍵欄位是否完全正確。應同時看欄位級 precision/recall、整份文件通過率、人工覆核率、處理時間及錯誤造成的營運成本。
Q3. 多模態文件解析何時比傳統 OCR 更適合?
當文件包含複雜表格、圖表、圖片說明、跨頁關係或需要以原始頁面佐證答案時,多模態解析更適合;版面簡單、只需擷取固定欄位的單據,則可優先採成本較低的 OCR 或文件模型。
Q4. 企業知識庫如何避免聊天機器人回答錯誤?
應保存段落與原始頁面的關聯、設定文件權限與版本、要求回答附來源引用,並在檢索證據不足時回答無法確認。RAG 與評測實務可參考 https://www.nist.gov/itl/ai-risk-management-framework 。
Q5. PoC 要做到什麼程度才適合正式上線?
至少應證明實際文件上的關鍵欄位品質、人工覆核流程、既有系統串接、權限與稽核紀錄均可運作,並量化處理時間、例外率與總成本。正式上線後仍需持續以回歸測試和版本監控處理模型漂移。