2026.09.29
本地端AI部署實戰指南:從硬體選型到企業上線
AI資訊
本地端AI部署的核心價值,是讓敏感文件、對話紀錄與推論流程留在自己可控的設備或內網中。若您的團隊受限於個資、營業機密、網路隔離或回應延遲,與其直接把資料送往外部 API,不如先釐清哪些工作適合在本機完成,再以可驗證的方式逐步導入。
本地模型不等於「下載後就能用」。真正影響成果的,包含模型參數量、量化格式、VRAM、記憶體、磁碟空間、中文文件品質、權限隔離與後續更新機制。從個人筆電的離線助理,到工廠內網的知識庫問答,架構雖然不同,但都必須先定義使用情境與可接受的品質門檻。
本文會從部署決策、硬體與模型搭配、Ollama 等工具鏈、私有 RAG 實作、安全治理與企業 PoC 流程切入,並以具體規格與操作原則說明如何避開常見踩雷點。您可依照自身設備、資料敏感度與預計使用人數,選擇從本機實驗、部門試行到正式上線的適當路徑。
本地端AI部署先解決資料、場景與成本問題
先判斷資料是否必須留在內部環境
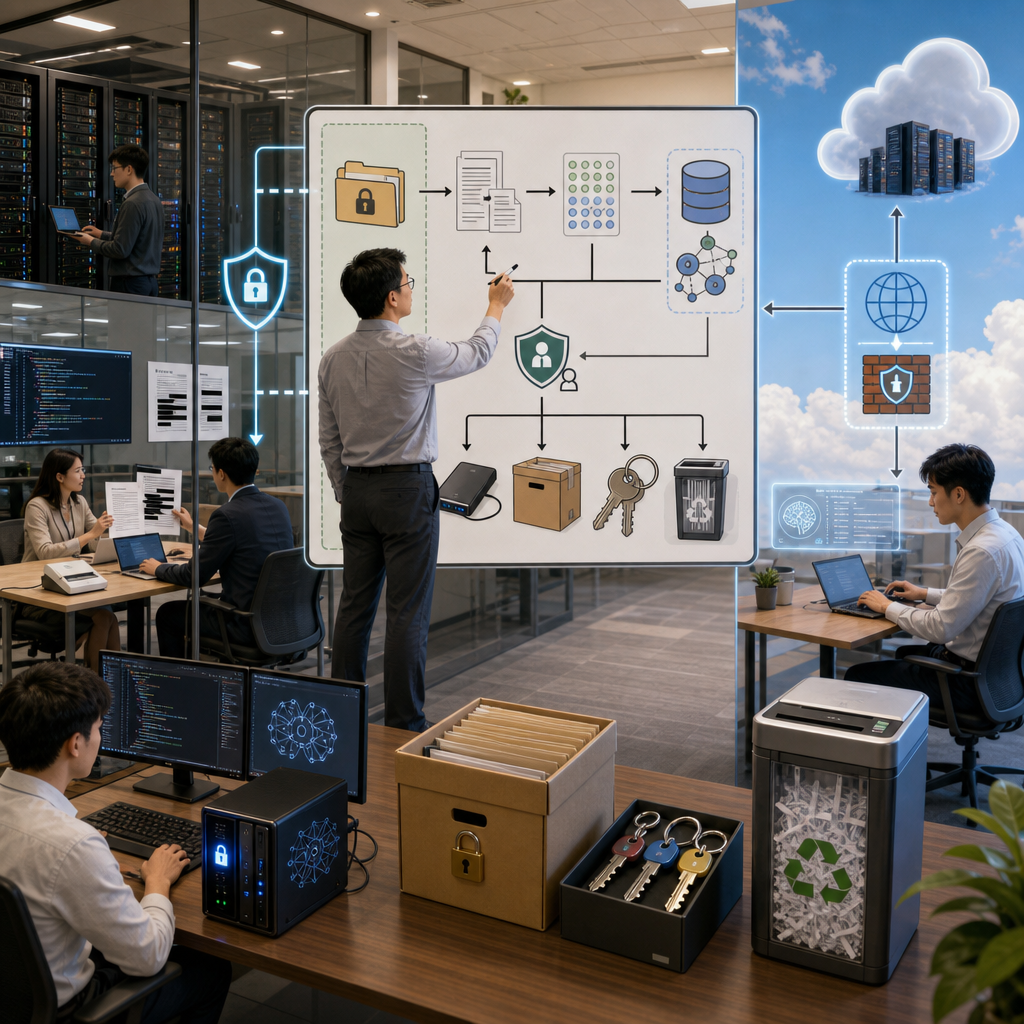
直接答案是:只要資料包含客戶個資、未公開合約、研發文件、原始程式碼或受管制內容,就應優先評估內網推論。模型在本機或私有網段執行,可降低把提示詞、附件與回覆傳出組織邊界的風險;但這不代表自動安全,帳號、檔案、模型權重與 API 仍須納入控管。
實務上,先畫出資料流比先選模型更重要。請標示文件從哪裡進來、如何切分與嵌入、向量資料庫放在哪裡、誰能呼叫模型,以及聊天紀錄保存多久。若某個環節需要外連更新,應將它與日常推論網段區隔,避免離線環境因便利性而留下未受管理的出口。
最容易被忽略的是資料生命週期。除了原始 PDF、Office 文件與掃描檔,還要盤點向量索引、嵌入結果、提示詞紀錄、快取與備份。建議將磁碟加密、權限繼承、刪除程序及還原演練寫入作業規範,否則即使模型完全離線,敏感資料仍可能從備份或共用資料夾外洩。
- 建立資料流圖,標示輸入、索引、推論、紀錄與備份位置。
- 以最小權限區分一般使用者、管理者與維運人員。
- 將模型更新的對外網路與日常推論網段隔離。
以工作任務決定離線或混合架構
直接答案是:高頻、低延遲且資料敏感的任務,最適合優先在本機執行。像是內部文件摘要、客服草稿、程式碼檢索、產線異常說明與會議紀錄整理,通常可透過本地模型與 RAG 完成;而需要極大模型、罕見專業知識或跨區協作的任務,則可保留經審核的雲端路徑。
混合架構的關鍵不是把所有請求任意分流,而是明定資料等級與路由規則。例如含身分資訊的文件只進內網模型;已匿名化的公開內容才可使用外部服務;需要人工覆核的答案則回到工作流程系統。這種設計能讓團隊兼顧隱私、品質與彈性,而不是被單一平台綁住。
成本判斷也應以總持有成本進行。硬體採購只是第一筆支出,後續還包括耗電、散熱、備品、維運人力、模型更新、監控與安全稽核。雲端 API 則要評估使用量波動、資料傳輸與供應商變動;當需求穩定且使用頻繁時,本機設備的固定成本才較容易攤提。
- 為機密、內部、公開資料建立可執行的分級規則。
- 將外部模型呼叫設定為例外流程,而非預設選項。
- 用月使用量、維運工時與設備折舊共同評估成本。
從可量化 KPI 啟動小規模驗證
直接答案是:不要先問「能不能裝模型」,而要先定義 AI 要改善哪一個業務結果。可衡量的指標包括文件查找時間、客服草稿完成率、人工校正比例、回覆延遲、引用正確率與使用者採用率。沒有 KPI 的部署很容易變成技術展示,最後無法回答是否值得擴大投資。
ALION 的 AI PoC 開發做法,是先透過現場調查與訪談,把模糊需求拆成可驗證假設,再以實際資料及貼近現場的環境建立最小原型。這種方式不只驗證模型精度,也會確認工作人員是否願意使用、資料是否足夠,以及既有流程是否需要調整。
驗證結束後,決策不應只有「成功」或「失敗」。較成熟的結論會分成可正式開發、需補資料後再驗證、改採混合架構,或目前不建議做。能及早提出 No-Go,同樣能避免把預算投入不具效益或無法被現場採用的系統。
- KPI 必須同時涵蓋品質、速度、成本與使用行為。
- PoC 應以真實文件與真實流程測試,不只看展示範例。
- 預先定義 Go、調整與 No-Go 的判斷門檻。
硬體與模型選型:讓效能符合實際工作量
以 VRAM 與記憶體反推可用模型規模
直接答案是:模型能否順暢運作,先看可用 VRAM,再看系統 RAM、上下文長度與同時使用人數。單人測試可從 16GB RAM + 8GB VRAM 起步;需要較穩定處理文件時,可考慮 32GB RAM + 12GB VRAM;多人使用或較大模型則常需要 64GB RAM + 24GB VRAM 甚至 128GB RAM + 48GB VRAM。
模型參數不是唯一成本。上下文愈長、同時請求愈多,KV Cache 占用的記憶體就愈高;若還要加上嵌入模型、向量資料庫與文件解析服務,主機資源更不能只剛好壓線。採購前應以最長文件、最大並發與目標回應時間做壓力測試,而不是只測單一句問答。
大模型需求尤其必須務實評估。70 B-parameter model 在未壓縮條件下可能需要 140 GB VRAM or more,不適合直接以一般消費級顯示卡規劃。多數內部知識庫任務可先以較小、量化後的模型驗證,再判斷是否真的需要多 GPU、伺服器級設備或混合式推論。
| 設備資源 | 適合情境 | 規劃重點 |
|---|---|---|
| 16GB RAM + 8GB VRAM | 個人離線助理 | 小型量化模型 |
| 32GB RAM + 12GB VRAM | 文件問答試行 | 中小型模型 |
| 64GB RAM + 24GB VRAM | 部門 RAG | 較高並發 |
| 128GB RAM + 48GB VRAM | 大型模型實驗 | 多服務共存 |
- 預留文件索引、系統服務與尖峰並發所需的資源。
- 測試首個 token 延遲與持續輸出速度,而非只看是否成功載入。
- 將長上下文與多人並發視為硬體選型的重要變數。
模型選擇要以中文任務與授權條款驗證
直接答案是:中文文件處理應以實際語料測試模型,而非只依排行榜選擇。可將 Qwen3-4B、Llama 3.3 7B、Gemma 2 4B、Mistral 與 DeepSeek-R1 放進同一套題組,檢查繁體中文摘要、表格理解、中英混合指令、專有名詞保留與引用內容是否正確,再選擇最符合業務需求的候選模型。
小模型的優勢是容易部署與調校。例如 Qwen3-4B 屬於 40亿 參數級模型,適合先驗證輕量任務;Llama 3.3 7B 為 70亿 參數規模並支援 40+语言;Gemma 2 4B 在特定量化配置下可控制於 <6GB。這些數字只能作為起點,真正品質仍取決於您的資料與提示設計。
授權與風險審查必須在上線前完成。除了確認商業使用條件,也要測試模型是否會捏造文件出處、重述不應揭露的內容,或受提示注入影響而忽略規則。建議建立固定題庫,包含正確答案、禁止回答情境與惡意指令,讓每次模型更新都能做可比較的驗收。
- 用繁體中文、長文與中英混合提示建立測試題庫。
- 確認模型權重、嵌入模型與套件的商業授權條件。
- 驗收時同時衡量正確性、拒答品質與引用完整性。
量化與推論優化要先保住可用品質
直接答案是:量化可大幅降低記憶體需求,但必須用任務測試確認品質損失可接受。常見做法包含 INT4、INT8、FP16 與 FP32;例如 FP32→INT8 可將模型權重記憶體需求降低約 75%,部分情境的推論吞吐量可達 2-3倍,但也可能帶來 0.5%-2% 的品質落差。
部署時可先以 INT8 作為保守基準,再測試 INT4 是否能維持中文摘要、檢索問答與格式輸出的需求。不要只比較一般對話的流暢度,還要對比數字擷取、否定句、跨段落引用與專有名詞。若模型回答變快卻常漏掉限制條件,節省的硬體成本會被人工覆核成本抵消。
效能優化應分層處理。模型層可評估量化、知識蒸餾與 MoE;執行層可使用 ONNX、TensorRT、批次處理及適當的快取;服務層則要限制上下文、排隊與並發量。NVIDIA TensorRT 文件可作為 GPU 推論優化的官方參考:https://developer.nvidia.com/tensorrt。
- 同一題組比較不同量化格式的品質與速度。
- 把首 token 延遲、tokens/s、功耗與最大並發納入紀錄。
- 優化前先找出瓶頸在模型、儲存、網路或應用層。
從工具鏈完成可重現的本機模型服務
以 Ollama 建立最小可用推論環境
直接答案是:初學者可先用 Ollama 建立單機推論服務,因為它把模型下載、執行與 API 介面整合為一致流程。安裝後先確認服務只綁定本機介面,再下載一個小型模型進行測試;模型目錄、快取位置與磁碟配額也應在第一天就記錄,避免日後因版本重複而耗盡空間。
Ollama 常見服務連接埠為 11434,因此最重要的安全原則是不要在未加驗證、未設防火牆的情況下直接對外暴露。若要讓內網系統串接,建議透過反向代理、HTTPS、API 金鑰、來源 IP 限制與稽核紀錄提供服務;僅在本機測試時則可限制為 loopback 介面。
模型指令可從簡單案例開始,例如測試 deepseek-r1:8b 是否能正確回應繁體中文問題,再逐步加入系統提示與文件檢索。Ollama 官方文件提供安裝、模型管理與 API 說明:https://docs.ollama.com/;任何模型下載前,也應確認來源、雜湊與授權,而非任意使用來路不明的權重檔。
- 先在單機完成模型下載、啟動、停止與移除演練。
- 將 11434 視為受保護服務端點,而不是公開網站連接埠。
- 記錄模型版本、量化格式、提示詞與測試結果。
依硬體與流量選擇執行框架
直接答案是:單機互動可優先考慮 Ollama 或 llama.cpp,多使用者高吞吐服務才需要評估 vLLM 等架構。llama.cpp 對 CPU、Apple Silicon 與 GGUF 模型的彈性較高;Ollama 適合快速提供本機 API;vLLM 則較適合具 GPU 資源、需要連續批次處理與服務化管理的環境。
容器化可提升可重現性,但 Docker 不是安全邊界的替代品。映像檔版本、掛載資料夾、GPU 驅動相容性、環境變數與網路設定都要納入版本控制;正式環境更應區分開發、非生產與生產設定,避免測試模型或測試資料直接流入服務中的正式系統。
框架選擇的驗證方法很簡單:用同一模型、相同提示與上下文長度,測量首 token 延遲、持續輸出速度、記憶體使用量與最大穩定並發。不要把不同量化版本或不同 prompt 的結果放在一起比較,否則看似漂亮的效能數字,無法用於實際容量規劃。
- 個人測試重視安裝簡單與模型相容性。
- 部門服務重視並發、記錄、權限與故障復原。
- 以固定測試腳本保留每次框架與模型調整結果。
用 API 與圖形介面降低使用門檻
直接答案是:模型服務必須被工作流程使用,才算真正完成部署。技術人員可透過 Python、Node.js、Go、PHP 或 FastAPI 呼叫本地 API;一般使用者則需要 Web UI、ChatBox AI、ChatRTX 或受管控的內部聊天頁面。兩種介面都應採用同一套權限與資料保存政策。
API 設計建議保留模型名稱、提示版本、文件來源、使用者身分與錯誤碼等欄位。這些資訊能協助團隊釐清「答案為何錯誤」:是檢索不到文件、模型推論失準、上下文被截斷,還是應用程式送錯參數。缺少追蹤欄位時,後續維運只會變成猜測。
介面也應明確告訴使用者系統限制。若回答來自 RAG,畫面要顯示來源文件與段落;若找不到證據,模型必須能回答不知道,而不是用看似合理的語句填補。這種可追溯設計比華麗聊天介面更重要,尤其在法務、製造、醫療或客服等高風險情境。
- 將本地 API 納入既有帳號、權限與日誌系統。
- 在 UI 顯示引用來源與資料更新時間。
- 將無法回答與需要人工覆核的流程設計進產品。
本地端AI部署的核心應用:私有 RAG 與流程整合
RAG 成敗取決於文件治理而非只靠模型
直接答案是:私有知識庫的品質,通常先由文件切分、欄位描述與權限設計決定,再由模型能力決定。建立 RAG 前,應移除重複檔、辨識掃描品質、補上部門、版本、生效日與機密等級等中繼資料;否則模型即使很強,也可能檢索到過期規範或不屬於該使用者的內容。
切分策略要對應文件形式。制度文件可依標題與條款切段,技術手冊可保留章節層級與表格關聯,客服紀錄則可依案件與時間切分。每一段都要保存原始來源、頁碼或段落識別,讓回答能回鏈證據;只存文字片段卻不保留來源,會使人工覆核與錯誤修正變得困難。
嵌入模型與向量資料庫也要以同一份中文題庫測試。除了看是否找到相似內容,更要檢查檢索結果是否真的支援答案、是否混入相反規定,以及權限過濾是否在檢索前完成。對企業而言,答對一半卻引用錯文件,通常比明確拒答更危險。
- 先治理文件版本、權限與中繼資料,再建向量索引。
- 切分後保留原文位置,讓每個回答可被追溯。
- 以引用正確率而非只看文字流暢度評估 RAG。
把 RAG 接入真正的業務工作流程
直接答案是:RAG 不應只做成一個聊天視窗,而要接到使用者原本工作的地方。例如客服人員可在案件系統內取得回覆草稿與來源條款,採購人員可在合約審閱頁面比較版本差異,工程師則可在 IDE 或內網入口搜尋規格、過往事故與程式碼說明。
導入時要避免讓 AI 直接覆寫正式資料。較穩妥的流程是先產生草稿、標示引用、由人員確認後才送出或寫回系統。對於庫存與生產規劃等決策型應用,AI 可以先用過往銷售與庫存資料比較多個預測模型,並製作將預測結果納入下單與生產計畫的示範,再試算預期效益。
ALION 的案例方法強調以實際資料驗證,而非先承諾成果。當需求預測系統要減少缺貨與庫存過剩時,應同時比較預測精度、人工調整幅度、例外處理與現場接受度。這種原型能協助管理層理解投資效益,也能提早發現資料缺漏或流程責任不清等問題。
- 將 AI 輸出定位為可審閱的建議,而非自動決策。
- 把引用、覆核與回寫權限放進既有系統流程。
- 以業務成效衡量,而非只用聊天次數評估成功。
以測試集控制幻覺與提示注入風險
直接答案是:本地執行不會自動消除幻覺、偏見或提示注入。攻擊者仍可能把「忽略先前規則」等指令藏在文件內容,誘導模型越權回答;因此系統提示、文件內容與使用者輸入必須被視為不同信任層級,並在應用程式中明確分隔。
測試集至少應包含正常問答、找不到資料的問題、相互矛盾的文件、過期版本、權限不足文件與惡意指令。每次更換模型、量化格式、嵌入模型或切分策略後,都要重新跑完測試集,紀錄答案、引用與拒答行為,才能避免看似無關的調整悄悄降低安全性。
可參考 OWASP 對大型語言模型應用風險的公開指引:https://owasp.org/www-project-top-10-for-large-language-model-applications/。實作上,除了輸入過濾,更要限制工具呼叫權限、遮罩敏感欄位、強制引用檢查,並讓高風險輸出進入人工核准流程。
- 將文件內容視為不可信輸入,不讓它覆寫系統規則。
- 以固定紅隊題庫驗證越權、外洩與捏造風險。
- 高風險流程採人工核准與完整稽核紀錄。
企業上線與維運:安全治理、監控及 PoC 路線圖
正式服務必須分離環境與權限
直接答案是:企業服務至少應將開發、非生產與生產環境分開,避免測試提示詞、未審核模型或樣本資料影響正式使用者。模型權重、容器映像、設定檔與向量索引都需要版本化;任何變更都應有審核、可回復與可追溯機制,而不是由單一工程師直接覆蓋。
權限分工應涵蓋資料管理者、模型維運者、應用程式開發者與一般使用者。資料管理者可決定文件可見範圍,維運者負責服務健康度,開發者只能使用核准的 API,而一般使用者不能下載底層索引或直接存取模型主機。這種職責分離能降低帳號遭濫用時的影響範圍。
網路層可採縱深防禦:模型主機放在受控網段、API 經反向代理提供 HTTPS、內部系統以服務帳號呼叫,並限制來源與速率。離線環境則要建立受管制的更新窗口,先在隔離區驗證模型權重、套件與漏洞修補,再移入正式網段,避免供應鏈風險。
- 將模型、索引、映像檔與設定檔全部納入版本管理。
- 依角色授權,避免共用管理帳號與共用 API 金鑰。
- 更新採隔離驗證、核准與可回復流程。
監控應同時看服務品質與資源消耗
直接答案是:只監看 GPU 使用率不足以維運 AI 服務。團隊至少要追蹤每秒預測次數、模型延遲時間、CPU 使用率、內存用量、網絡用量,以及每個訓練節點的 CPU 利用率與每個訓練節點的內存利用率;這些指標能協助辨識瓶頸是在推論、檢索、網路還是排隊。
品質監控同樣重要。應記錄無引用回答比例、找不到資料比例、人工改寫比例、權限拒絕事件與使用者回饋,並依部門、模型版本與文件版本分析。若延遲很低但人工改寫率持續升高,問題很可能不是硬體,而是文件品質、提示詞或檢索策略。
容量規劃應用實測資料,而非單一展示數字。可先在尖峰情境模擬同時查詢、長文件與背景索引工作,觀察是否出現 OOM、回覆排隊或檢索逾時。將儀表板與告警門檻交給明確負責人,才能在使用者抱怨之前發現服務退化。
- 將延遲、吞吐量、錯誤率與品質指標放在同一儀表板。
- 對模型版本與文件版本建立可追溯關聯。
- 以尖峰並發與長上下文進行容量與故障演練。
以可延續的 PoC 降低正式化風險
直接答案是:最有效的上線路徑,是先用最小範圍證明技術可行、現場可用與投資合理,再擴大到正式系統。ALION 的上游工程訂閱服務以月費 20 萬日圓起提供 AI 顧問、需求定義、設計與示範製作;相較於 CTO 級人才月薪 80〜150 萬日圓或外包開發啟動費約 300 萬日圓起,可先降低不確定性。
PoC 的交付物不應只是一次性展示,而應包含需求定義、系統架構、資料處理規則、測試結果、原型程式碼與 ROI 判斷依據。以1,000 萬日圓規模的開發案為例,上游工程約需3 個月(約 60 萬日圓);若進入正式開發,該費用可自正式開發預算扣抵,使驗證成果能延續而非被丟棄。
若您準備啟動專案,建議先找一個資料範圍可控、使用者明確、成功標準可量化的場景,例如單一部門的規範問答或客服草稿。完成真實資料測試、資安審查與使用者回饋後,再擴展模型規模、資料範圍與串接系統,會比一次建置全公司平台更穩健。
- 以小範圍、真實資料與量化 KPI 驗證投資假設。
- 讓 PoC 的程式碼、設計與測試報告可延續至正式版。
- 正式化前完成資安、權限、備份與維運責任盤點。
延伸參考來源
可優先查閱 Ollama 官方文件 https://docs.ollama.com/、llama.cpp 專案 https://github.com/ggerganov/llama.cpp、NVIDIA TensorRT https://developer.nvidia.com/tensorrt,以及 OWASP LLM Top 10 https://owasp.org/www-project-top-10-for-large-language-model-applications/。這些來源可協助團隊確認工具操作、推論優化與應用安全控制。
總結
本地端AI部署不是單純把語言模型裝進電腦,而是將資料治理、硬體容量、模型品質、檢索設計、權限控管與維運流程整合成可持續運作的服務。先以小型模型與真實任務驗證,再逐步擴大設備與使用範圍,通常比一開始追求最大模型更容易做出可用成果。
重點整理
- 先以資料敏感度、任務頻率與延遲要求決定本機、雲端或混合架構。
- 硬體規劃要同時考慮 VRAM、RAM、上下文長度、並發量與文件服務。
- 量化格式必須以繁體中文真實題庫驗證,不可只看載入成功或單次速度。
- 私有 RAG 的關鍵在文件治理、引用可追溯與檢索前權限過濾。
- 以 PoC 建立 KPI、原型與 Go/No-Go 依據,可降低正式開發風險。
若您正在評估內網知識庫、離線客服助理、需求預測或程式碼檢索,建議先整理一批可合法使用的真實文件與明確 KPI,再規劃小規模測試。透過現場調查、原型驗證與可延續的設計文件,能更快判斷哪些 AI 場景值得投入,哪些則應暫緩或改用其他方案。
常見問題 FAQ
Q1. 沒有獨立 GPU,也能做本地模型測試嗎?
可以。可先選擇較小的量化模型,透過 CPU 或 Apple Silicon 進行單人測試;但回應速度、可用上下文與同時使用人數會受限。若目標是部門知識庫,仍建議先以真實文件壓測,再決定是否添購 GPU。
Q2. 本機模型是否完全不需要資安措施?
不是。模型雖在內網執行,模型檔、向量索引、聊天紀錄、備份與 API 都可能含有敏感資訊。仍須實施帳號權限、磁碟加密、網段隔離、連接埠防護、日誌稽核與受管制更新流程。
Q3. RAG 為何常常回答錯誤或沒有引用來源?
常見原因包括文件切分不當、中繼資料缺漏、嵌入模型不適合中文、向量檢索未做權限過濾,或提示詞沒有要求根據來源回答。應先檢查檢索結果是否正確,再判斷是否需要更換模型。
Q4. PoC 結果不理想,是否代表 AI 不適合公司?
不一定。PoC 的價值就在於找出限制是資料不足、流程不清、模型不符、硬體不足,還是場景本身效益不高。若能明確提出補強方向或 No-Go 判斷,仍能避免後續投入更高的開發與維運成本。
Q5. Ollama 的 11434 連接埠可以直接開放到網際網路嗎?
不建議。若有內網整合需求,應透過 HTTPS 反向代理、API 驗證、來源 IP 限制與日誌機制提供服務;公開暴露未受保護的模型端點,可能導致未授權使用、資料外洩與資源遭濫用。