2026.09.27
RAG重新排序如何讓企業問答更準確可靠
AI資訊
RAG重新排序是改善企業問答準確度最直接、也最常被低估的一步。當使用者問「合約終止條件是什麼」時,系統即使從向量資料庫找回了 20 段看似相近的內容,也可能把「續約條款」或過期版本排在前面;生成模型一旦讀到錯誤脈絡,便可能產生看似合理卻無法採信的回答。
RAG 技術的核心是先從外部資料找證據,再讓大型語言模型依據證據回答;但向量相似度只能判斷語意接近,未必能判斷文件是否真正回答問題。尤其在企業知識庫同時包含規章、PDF 表格、會議紀錄、客服案件與版本文件時,初步召回的雜訊會直接拉低答案品質,也使使用者失去信任。
本篇聚焦檢索後的排序決策:從向量資料庫的召回設定、交叉編碼器與 LLM 排序器的差異,到 Agentic RAG 如何動態調整檢索策略,再延伸至 LLM模型評估、資料治理與 PoC 驗證。讀完後,你能用可量測的方式判斷何時需要重排序、如何設定 top-k 與 top-n,以及如何把成果轉換成投資決策依據。
RAG重新排序:為何初步檢索不足以支撐正確答案
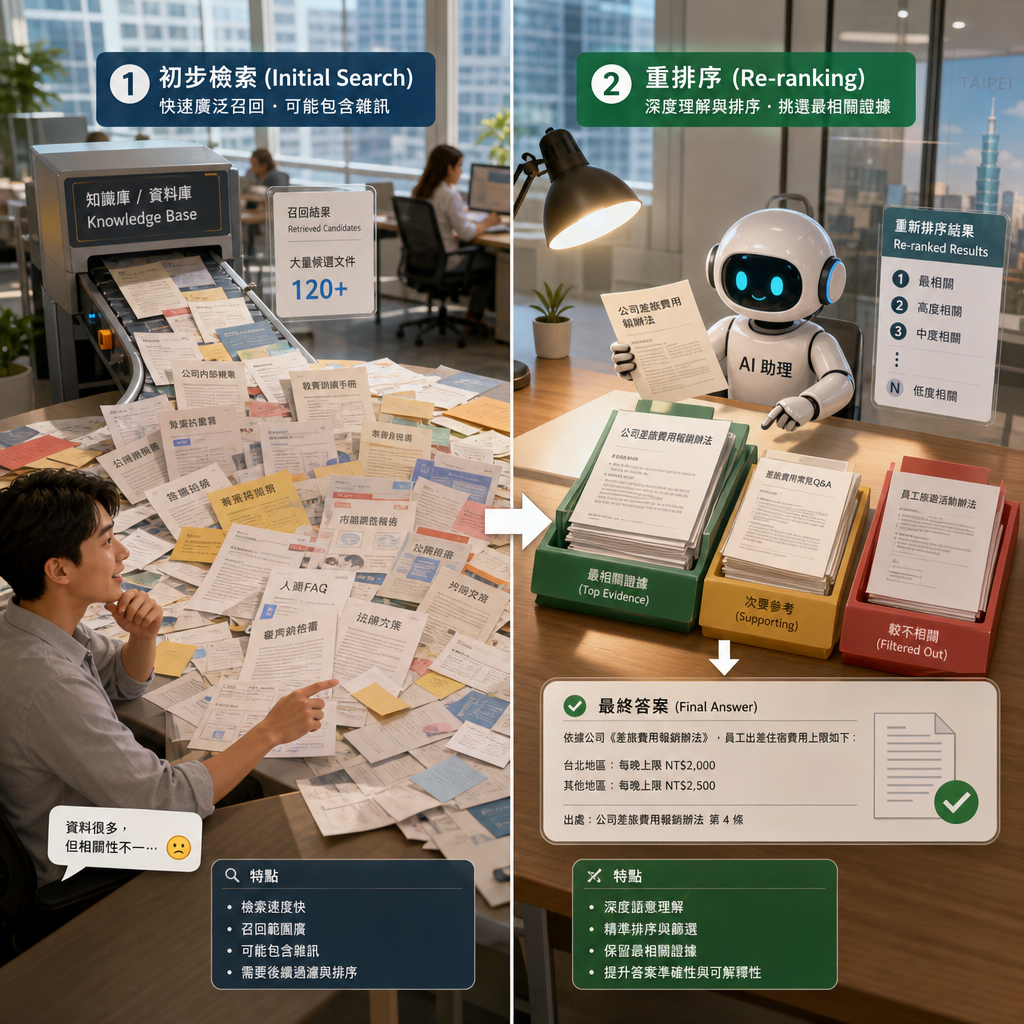
先釐清:重新排序是第二道相關性判斷
直接答案是:RAG重新排序會在初步檢索之後,重新判讀「使用者問題」與「候選文件」的關係,將最能直接作答的內容排到前面。一般流程先以稠密向量、關鍵字或混合搜尋快速找出候選片段,再由更精準但較耗算力的模型逐筆或整批比較,最後只把少量高品質證據交給生成模型。這項設計不是替代向量搜尋,而是補足它對細微意圖、否定語句、條件限制與專有名詞的辨識落差。
向量檢索通常把查詢與文件轉成 768或1536维的向量,再以餘弦相似度、內積或距離尋找近鄰。這種方法非常適合從大量資料快速找出語意相似內容,卻可能混淆「可以退貨嗎」與「不可退貨的例外條件」。餘弦相似度的值常落在 -1 到 1 之間,但高分僅表示嵌入空間相近,並不保證文件能完整、正確且符合權限地回答使用者問題。
實務上,建議把重排序視為企業問答的品質閘門,而不是追求單一模型分數的裝飾。第一階段的任務是不要漏掉答案,重視召回率;第二階段的任務是把真正可用的證據推到前面,重視排序品質與精確率。只要候選集合仍含有答案,重排序器便能有效降低無關上下文進入提示詞的機率,進而減少幻覺與引用錯置。
- 第一階段追求廣泛召回,避免正確文件完全缺席。
- 第二階段追求精準排序,控制送入模型的上下文雜訊。
- 生成前應保留文件來源、版本與權限資訊,支援後續追溯。
上下文越長,不代表回答一定越可靠
直接答案是:增加上下文長度只能容納更多資料,無法自動提高證據品質。Anthropic的Claude,其上下文窗口为100K令牌,確實能容納長篇文件與多筆候選內容;然而,若排序不佳,最關鍵的條款可能被埋在冗長脈絡中,模型也可能過度依賴位置靠前、語句更流暢但版本已失效的段落。重排序的價值在於先濃縮證據密度,而非盲目擴張輸入。
常見失敗情境是:系統一次取回許多分塊,包含相似標題、引用段落與附錄內容,然後全部塞入提示詞。這會提高 token 成本,也讓模型需要在相互衝突的內容中自行判斷。若企業知識庫存在「人資規範正式版」與「草案討論版」,未經版本過濾與重排序,生成模型未必知道哪一份才具有效力,最終答案便可能看似專業卻不符合現行制度。
因此,應將「答案所需證據是否位於前 n 名」當成核心問題。RAG 技術的輸出品質可拆成三段:找不找得到、排不排得正確、答不答得有根據。只有把這三段分開量測,團隊才知道問題是嵌入模型、文件分塊、查詢改寫、重排序器,還是生成提示造成,而非一律以更大的模型或更長的上下文處理。
- 長上下文適合容納必要證據,不適合取代檢索品質。
- 衝突版本、附件與引用內容是企業場景的主要風險。
- 應量測前 n 名是否涵蓋正確證據,而非只看回答是否流暢。
兩階段檢索如何平衡召回率、延遲與成本
直接答案是:先取較多候選,再精選少量內容,是多數企業最穩健的架構。舉例而言,可先設定 top_k=25 取得候選片段,再經重排序保留 top_n=3 給生成模型。前段可使用向量搜尋與關鍵字搜尋並行,確保同義詞、產品型號、條文編號及縮寫不會因單一檢索方法而漏失;後段再以問題與文件的成對語意判斷,篩除只是「主題相近」的片段。
候選數量不宜固定套用。查詢短、文件同質且規範明確時,過大的 top-k 只會增加延遲;查詢含多個條件、跨部門術語或中英混用時,較寬的候選池反而有助於避免遺漏。團隊可先以 25 個候選、3 個輸出片段作為 PoC 起點,然後針對查詢長度、語言、文件長度與延遲預算分群測試,找出符合業務需求的設定。
成本評估也必須採端到端觀點。Llama 3.1 8B 模型處理五個資料塊並生成答案的成本約高出 75 倍,顯示不加選擇地塞入上下文,可能比增加一層精簡重排序更昂貴。部分實作報告也指出,透過改善檢索與內容篩選可顯著節省了 21.54% 的成本;但是否適用仍須以自家文件長度、模型單價與查詢量實測。
- 以 top_k=25、top_n=3 作為可驗證的初始假設,而非永久標準。
- 候選池大小應依問題複雜度、語言與文件型態調整。
- 比較成本時,應把重排序推論與生成 token 一起計入。
重排序模型怎麼選:交叉編碼器、向量模型與 LLM 排序器
交叉編碼器適合追求文件與問題的細緻匹配
直接答案是:交叉編碼器通常是企業導入重排序的優先選擇,因為它會同時讀取問題與候選文件,再輸出兩者的相關性分數。相較於雙編碼器分別把問題、文件嵌入後計算相似度,交叉編碼器能注意到詞序、否定、條件句與專有名詞的交互關係,例如辨識「不適用於試用期」與「適用於試用期」的實質差異。
其代價是無法像向量資料庫一樣,預先把所有文件向量化後快速比對。每次查詢都要對每個候選組合重新推論,因此應放在候選數已縮小的第二階段。對 25 個候選逐一計分,多數內部知識問答可接受;若每次要處理數千份候選,則應先改善 Metadata 過濾、混合搜尋或查詢改寫,而不是把大量文件直接丟進交叉編碼器。
開源部署可考慮 Hugging Face、PyTorch 與 BAAI 系列模型;例如設定 reranker = FlagEmbeddingReranker( top_n = 3, 3 model = “BAAI/bge-reranker-base”,”BAAI/bge-reranker-base”) 的概念,是將初檢結果壓縮為少數高相關片段。實作時仍應確認模型授權、繁體中文表現、GPU 或 CPU 延遲,以及是否能保留每筆評分紀錄供除錯與稽核。
- 交叉編碼器會聯合閱讀 query 與 document,通常能提供更細緻的排序。
- 應用於有限候選集合,而非取代大規模向量索引。
- 選型時要驗證繁中、英文、混合語言與公司專有縮寫的表現。
LLM 排序器適合複雜推理,但要嚴控輸入規模
直接答案是:LLM 排序器在複雜、多條件或需比較多份文件的任務上很有彈性,但不應無限制地取代專用重排序模型。它可採逐點排序,分別判定每份文件是否相關;也可採列表式排序,要求模型直接輸出候選的優先順序。前者較容易平行化,後者較能比較相近內容,但兩者都會受提示設計、輸入長度與模型輸出格式穩定性影響。
RankGPT 類作法常採滑動視窗處理長候選清單,例如使用窗口大小为4、步长为2的滑动窗口对8个通道重新排序。此法避免一次將過多文件送入模型,也能逐步改善排序;不過視窗邊界仍可能讓相距較遠的候選缺少直接比較。企業若採用此路線,應記錄每輪排序輸入、模型版本與最終排列,否則難以解釋為何某項政策被排在另一份文件之前。
LLM 排序器最適合做為「高難度路由」:當交叉編碼器分數接近、問題含多個限定條件,或使用者要求比較不同制度時才啟動。如此可讓一般問題維持低延遲,複雜問題才使用更高推理能力。若直接以 LLM 排所有候選,容易受到 token 費用、格式錯誤與回應時間波動影響,也難以維持大量查詢下的一致服務品質。
- 逐點排序便於平行處理;列表式排序更適合相近候選的相對比較。
- 滑動視窗能控制輸入長度,但需注意視窗邊界造成的比較盲點。
- 建議以分數門檻或查詢複雜度決定何時升級為 LLM 排序。
選模型前,先建立公平且可重複的比較方式
直接答案是:不能只看單次 demo 的回答,必須在相同資料集、相同召回器、相同生成模型與相同提示詞下比較排序器。許多團隊在測試時同時更換嵌入模型、chunk 長度與生成模型,最後即使答案變好,也無法知道是否真是重排序帶來的效益。正確做法是鎖定其他變因,僅替換交叉編碼器、商用服務或 LLM 排序策略。
可比較的核心指標包括 MRR、Hit Rate@k、Recall@k、nDCG,以及最終答案的正確性、引用完整性與拒答品質。單看排序分數沒有意義,因為不同模型的分數尺度不同;例如某筆結果可能顯示 score=0.9071478,另一筆是 score=0.6954414,但只有和人工標註的相關性及最終回答一起檢視,才知道門檻設定是否合理。
商用重排序 API、開源交叉編碼器與自建 LLM 排序各有取捨。市場上常見說法是,目前,最好的重新排名模式是[Cohere](https://txt.cohere.com/rerank/),但它是一个付费服务。這不應被當成採購結論,而應視為測試假設:企業仍需比較資料外流限制、語言支援、單次延遲、每月用量成本與模型版本變動風險,選擇可長期治理的方案。
| 比較面向 | 交叉編碼器 | LLM 排序器 | 商用重排序 API |
|---|---|---|---|
| 判斷能力 | 細緻語意匹配 | 複雜條件推理 | 依服務模型而定 |
| 延遲特性 | 隨候選數增加 | 受輸入與模型波動 | 受網路與方案影響 |
| 治理方式 | 可自建控管 | 需保留提示與輸出 | 須審查傳輸條款 |
| 適用情境 | 一般企業問答 | 高難度比較問題 | 快速驗證與擴充 |
- 比較時固定資料、召回器、提示詞與生成模型,避免混淆變因。
- 排序指標與答案指標必須並行,才能驗證商業價值。
- 商用與開源模型應以資料治理、延遲及總成本共同決策。
向量資料庫與文件設計:讓候選集合值得重新排序
向量資料庫的任務是快速召回,而非單獨裁決答案
直接答案是:向量資料庫應負責從大量企業內容中迅速找出可能相關的候選,真正的精準判斷交給後續重排序。嵌入維度的數量從幾百到幾萬不等,模型會把文字、表格摘要、影像描述或其他非結構化內容映射至向量空間;查詢時再透過近似最近鄰搜尋取得相似片段。最早出現專門為AI應用設計且支援分散式架構的向量資料庫產品是Milvus(2019)。
選擇資料庫時,不能只問「哪個查詢最快」,還要問資料量、更新頻率、Metadata 過濾、權限模型、備份需求與既有技術棧。例如:Weaviate、Pinecone、Qdrant、LanceDB。也有團隊採用例如:PostgreSQL + Milvus。或例如:Qdrant + MongoDB。前者可兼顧關聯資料與向量檢索,後者可依既有文件與應用架構分工,但都需要處理識別碼、刪除同步與版本一致性。
檢索層最重要的原則,是先把明確不可能使用的內容排除。文件的部門、國別、有效日期、保密等級、產品線、語言與存取權限都應成為 Metadata,並在向量搜尋前或搜尋中過濾。若使用者無權查看的文件先被召回,再依賴生成模型「不要說出來」,既不安全也浪費重排序算力;正確設計應讓無權內容根本不會進入候選池。
- 向量資料庫負責高效率候選召回,不能取代內容治理與精準排序。
- Metadata 過濾應包含權限、版本、有效日期、語言與業務範圍。
- 資料庫選型要連同更新、刪除、備份與既有系統整合一起評估。
索引與壓縮會改變召回品質,也會影響重排序負擔
直接答案是:索引壓縮能降低儲存成本,但召回品質下降時,後續再強的重排序器也救不回未被找出的正確文件。向量系統常使用 HNSW、IVF、PQ 或 DiskANN 等索引策略,透過近似搜尋換取低延遲。若召回集合本身漏掉正確政策條文,重排序只能在錯誤候選中挑出相對較好的內容,因此必須先設定最低可接受的 Recall@k。
記憶體規劃尤其不可忽略。For large-scale vector collections (100M+ vectors), in-memory indexes become prohibitively expensive. 以高維向量估算時,100 million 1024-dimensional vectors would require approximately 400GB of RAM. 這還未納入索引結構、Metadata、複寫與作業系統額外開銷;若企業直接以記憶體索引擴張,成本可能迅速超出原先預期,迫使團隊犧牲副本或可用性。
量化是常見的折衷工具。Scalar Quantization (SQ) converts 32-bit floats to 8-bit integers, reducing memory usage by 75% with minimal accuracy impact. 其他壓縮方式則可能更激進:This significantly reduces storage needs (often by 90%+) but introduces some accuracy loss. 因此,壓縮啟用後務必重新量測 Recall@25、重排序後 Hit Rate@3 與答案品質,不要只以成本下降判定架構成功。
- 重排序無法修復召回階段完全漏掉的正確內容。
- 大規模向量集合應先估算記憶體、索引與高可用副本需求。
- 啟用量化後要重新測試召回、排序與回答三層品質。
文件分塊與版本治理決定排序器看得到什麼
直接答案是:好的分塊應保留一個可獨立回答問題的最小語意單位,同時附帶標題、章節、版本與來源,而不是機械式切成固定字數。企業知識庫常有表格、例外條款、流程圖與附件;若把「適用條件」切到前一塊、把「例外情況」切到下一塊,重排序器即使辨識到其中一段高度相關,也可能讓生成模型得到不完整結論。
建議以文件結構為優先:依標題、條列、表格列、問答單元或段落邊界切分,再設定少量重疊以保留上下文。每個 chunk 都要保留父文件識別碼與章節位置,方便重排序後回取相鄰段落或完整條款。對掃描 PDF,還應先驗證 OCR 是否把表格欄位、日期與否定詞辨識正確,否則錯誤文字向量化後會造成難以追查的檢索偏差。
版本治理必須與索引同步。文件新增、修訂、撤銷或權限變更後,應以 Upsert、Delete 與版本欄位更新索引,並留下可稽核的變更紀錄。服務承諾也要與業務需求相符,例如 99.999% SLA (已啟用 HA)代表高可用設計需要副本、監測與故障演練,而非只在採購簡報中出現。參考文件若標示 Last updated on 2026-04-27,也應被系統視為可檢索的時效 Metadata。
- 以語意與文件結構分塊,避免把條件與例外拆散。
- 每個 chunk 應保有父文件、章節、版本、來源與權限欄位。
- 索引更新要對應文件生命週期,確保撤銷內容不再被召回。
企業知識庫導入:用 Agentic RAG 管理複雜問題與風險
企業知識庫先治理,才能把排序結果變成可信答案
直接答案是:企業知識庫的成功關鍵不在於收集更多文件,而在於清楚定義哪些內容可被檢索、誰能存取、哪個版本有效,以及答案該引用何處。重排序器可改善候選優先順序,卻無法替企業判定草案是否可作為正式依據。若來源權威性沒有分級,系統可能將非正式簡報、內部討論與已核准制度一起視為同等證據。
導入前應盤點來源類型,包括制度文件、產品手冊、客服工單、ERP 或 CRM 欄位、SQL 即時資料與郵件附件。不同來源的更新頻率與可信度不同:制度文件可能必須人工審核後才可發布,庫存或訂單狀態則需要接近即時同步。建立來源等級、擁有者、有效日期與審核流程,能讓排序規則不只看相關性,也兼顧資料權威性與新鮮度。
回答介面也應提供可點擊的來源、文件版本與引用片段,讓使用者能自行核對。當系統找不到足夠證據時,最佳策略通常是明確拒答、請求補充條件或導向承辦窗口,而不是根據相似內容推測。這種可追溯設計能協助法務、人資、客服與資訊團隊共同建立信任,並讓後續錯誤回報能回到具體文件與排序紀錄修正。
- 建立來源權威等級,避免草案與正式制度被同等處理。
- 依資料型態設計不同更新與審核流程。
- 前台引用與後台紀錄是處理錯誤、建立信任的必要設計。
Agentic RAG 的價值在於動態規劃,不是增加代理數量
直接答案是:Agentic RAG 應根據問題難度決定是否改寫查詢、查多個資料源、進行重排序、驗證引用或請求使用者澄清。它與固定流程 RAG 的差異,在於代理可依中間結果採取下一步,例如先檢查候選文件是否有足夠證據;若不足,再以條文編號、同義詞或部門名稱重寫查詢,而不是直接產生答案。
以採購合約問答為例,使用者問「提前解約要付多少」時,代理應先辨識是否缺少合約編號、客戶別或生效日期。若缺乏必要條件,就不應直接跨所有合約找相似條款;若已具備條件,則可先以 Metadata 限縮客戶與版本,再檢索條款、重排序、查詢相鄰段落,最後檢查回答是否引用了金額、期間與例外規定。
但 Agentic RAG 不等於讓模型任意呼叫工具。每個工具都要有輸入限制、權限檢查、逾時機制、成本上限與可觀測紀錄。對高風險資料,可把代理的行動設計成有限狀態流程:先檢索、再排序、再驗證,任一步證據不足就停止並轉人工。如此才能享有動態規劃的彈性,同時避免工具迴圈、越權查詢與不可預期的推論成本。
- 代理應依證據不足、分數接近或條件缺失決定下一步。
- 高風險問題要優先澄清條件,而非跨資料源猜測答案。
- 工具呼叫需要權限、逾時、預算與完整軌跡控管。
以 PoC 驗證 RAG重新排序是否值得正式擴大
直接答案是:最可靠的導入方式,是用真實資料與真實問題做小規模 PoC,而不是只以公開資料集展示模型能力。ALION 的 AI PoC 開發支援採取先定義 KPI、確定驗證範圍、建立原型,再進行效益驗證與 Go/No-Go 判斷的流程。這能讓企業在正式投入前,先確認重排序是否真的改善現場人員的找資料速度、回答正確率與可採信程度。
PoC 的測試集應包含常見問答、困難問答、過期資訊陷阱、權限限制、中英混合語句與專有名詞。每題應由業務專家標註可接受來源與正確答案要點,再對照「僅向量檢索」和「向量檢索加重排序」的差異。除了離線指標,也要讓實際使用者測試引用是否足夠、回答是否能直接行動,以及系統無法確定時是否會安全地拒答。
成本與決策資料也要一起產出。ALION 提供的 AI 上游工程訂閱服務為月費 20 萬日圓起,適合先從需求梳理、架構設計與示範製作開始;若進入正式開發,先前上游工程的設計、程式碼與知識可延續運用。PoC 的價值不只是證明「做得出來」,更是用數據判斷「現在是否該做、該做到哪裡」,必要時也能得到暫緩導入的合理依據。
| 階段 | 主要工作 | 可驗證成果 |
|---|---|---|
| 目標設定 | 定義情境與 KPI | 成功門檻 |
| 資料盤點 | 來源、權限、版本 | 可用資料清單 |
| 原型驗證 | 檢索、排序、生成 | 前後品質比較 |
| 投資判斷 | 效益與風險整理 | Go/No-Go 依據 |
- PoC 應使用真實文件、真實權限與真實業務問題。
- 同時比較離線排序指標、答案品質、使用體驗與總成本。
- Go/No-Go 決策要以 KPI 報告與可延續的原型資產支撐。
LLM模型評估:量化重排序帶來的答案品質與營運效益
評估必須拆開檢索、排序、回答與引用四個層次
直接答案是:LLM模型評估不能只問「回答看起來好不好」,而要分別確認正確文件有沒有被找到、是否被排進前段、答案是否符合事實、引用是否完整。若只評最終文字,團隊無法定位問題來源;同一句錯答,可能是文件未入庫、向量召回失敗、重排序誤判、上下文截斷,或生成模型忽略證據所造成。
檢索層可用 Recall@k 衡量正確證據是否進入候選池;排序層可用 MRR、nDCG 與 Hit Rate@3 檢查正確內容位置;回答層可由專家依正確性、完整性、可行動性與拒答適切性評分;引用層則檢查每個關鍵主張是否能回連到有效來源。這套分層設計能把「模型不好」轉換成具體的工程待辦事項。
建立黃金測試集時,不應只收集容易回答的 FAQ。真正有價值的題目包括同名制度、版本衝突、否定條件、跨文件比較、資料缺失與權限不足的問題。每次更換嵌入模型、分塊規則、索引參數、重排序器或提示詞,都應自動重跑測試集並保留結果。這讓團隊能避免某次優化提高一般題分數,卻使高風險題目退步而未被發現。
- Recall@k 衡量找得到;MRR 與 nDCG 衡量排得對;人工審查衡量答得對。
- 引用完整性與安全拒答應列為正式品質指標。
- 測試集要含衝突版本、權限限制與否定條件等高風險題。
答案品質提升要回到可驗證的業務 KPI
直接答案是:排序改善是否有價值,必須以業務結果而非單一模型分數判斷。部分 RAG 導入案例曾報告答案品質的準確度提升了77.6%,但任何百分比都不能直接套用到另一家企業,因為資料乾淨度、領域術語、使用者問題與人工評分標準都不同。正確做法是把該類數字視為可能性,再以自己的基準線與對照組確認效果。
適合納入 KPI 的指標包括:一次回答解決率、人工轉接率、搜尋與回覆耗時、使用者引用點擊率、錯誤回報率與高風險拒答正確率。若客服人員仍須花時間回查原始文件,代表即使回答文字順暢,系統仍未節省流程成本。反之,若回答附上精準條文與版本,使用者能快速採取行動,才是重排序真正轉化為效率的證據。
監控資料也應區分離線與線上。離線評估適合在部署前比較模型;線上則應蒐集匿名化查詢類型、候選分數分布、延遲、失敗率與使用者回饋。對低分或被負評的案例,應由業務與技術人員共同標註原因,判斷是資料缺漏、chunk 不完整、排序不佳或問題本身含糊。這個回饋迴路會持續提升企業知識庫的可用性。
- 外部案例的提升百分比只能當作假設,不能取代內部實測。
- 商業 KPI 應涵蓋一次解決、節省時間、引用使用與風險控制。
- 低分案例要能回溯到資料、檢索、排序或生成的具體環節。
把評估與版本管理納入日常營運
直接答案是:RAG 系統上線後仍須持續評估,因為文件、權限、嵌入模型與使用者提問都會改變。每次更新前,應在固定測試集上比較舊版與新版的召回率、排序品質、答案正確性、引用完整性、延遲與成本;若新版本只改善少量一般題,卻降低法規或人資題的安全性,就不應直接發布。
營運儀表板建議至少記錄查詢時間、使用的索引版本、候選文件 ID、初檢分數、重排序分數、送入模型的片段、回答引用與使用者回饋。這些紀錄不僅能協助除錯,也能回答稽核常見問題:系統當時依據哪一版資料回答、為何選了這份文件、權限是否在查詢時已生效,以及是否存在無依據的內容。
可信參考來源也應定期追蹤,而不是只收藏文章。官方文件、學術論文與產品更新頁都可能改變建議設定,例如有內容頁面標示 Posted: 2024-12-31,另有社群頁顯示 11.9K subscribers;這些數字可用於辨識內容發布脈絡或社群規模,卻不能取代可重複實驗與官方技術文件。決策時應優先採用原始論文、供應商官方文件及內部驗證報告。
- 每次模型、索引或文件更新都應執行回歸測試。
- 保留排序與引用軌跡,才能處理稽核、錯誤修正與責任釐清。
- 內容熱度或社群數字不是品質證據,仍須以可重複實驗驗證。
總結
RAG重新排序的本質,是在快速召回與生成回答之間建立精準的證據篩選層。它能改善向量相似度不足以處理的條件、版本與專有術語問題,但前提是候選池具備足夠召回率、文件具備可追溯 Metadata、權限在檢索前生效,並以分層評估確認品質提升來自真正可用的證據。
重點整理
- 先以混合檢索擴大可用候選,再以重排序器壓縮成高品質上下文。
- 交叉編碼器適合一般精準排序;LLM 排序器適合高複雜度問題的選擇性升級。
- 向量資料庫、分塊、版本與權限治理,決定重排序器能否看見正確內容。
- LLM模型評估應分開衡量召回、排序、答案、引用與安全拒答。
- 以真實資料執行 PoC,才能判斷重排序的品質效益是否足以支持正式投資。
若你的團隊已經有 RAG 原型,卻仍遇到答案不穩、引用不準或現場人員不信任的問題,建議先選定一個高價值且範圍明確的情境,建立黃金題組並比較重排序前後成果。透過小規模 PoC 將 KPI、資料治理與系統延遲一起驗證,能比直接擴大開發更快找到可落地的架構與投資界線。
常見問題 FAQ
Q1. RAG重新排序一定要導入嗎?
若資料量小、文件版本單純且初步檢索已能穩定把正確內容排在前段,可先不導入。但當企業知識庫包含大量相似文件、專有術語、跨語言內容或高風險規範時,重排序通常能以可控成本顯著改善證據品質。
Q2. top-k 和 top-n 應該設定多少?
可先從 top_k=25、top_n=3 開始測試,再依問題複雜度、文件長度、語言與延遲預算調整。重點不是追求固定數字,而是確認正確文件能進入候選池,且最終送入模型的內容足以完整回答問題。
Q3. 向量資料庫分數高,還需要重排序嗎?
通常仍建議評估。向量分數代表嵌入語意相近,不必然表示文件符合問題中的條件、否定語或版本要求。重排序器會更直接比較問題與文件,可將真正能作答的片段提升到前段。
Q4. Agentic RAG 與一般 RAG 的差異是什麼?
一般 RAG 多採固定檢索、排序、生成流程;Agentic RAG 則可依中間結果決定是否改寫查詢、切換資料源、再次檢索、驗證引用或請求使用者補充條件。高風險場景仍應設定工具權限、成本上限與人工轉介規則。
Q5. 如何確認重排序確實提升了系統品質?
以同一組標註題目比較重排序前後的 Recall@k、MRR、Hit Rate@3、答案正確性與引用完整性,同時追蹤延遲與成本。再加入實際使用者測試,確認回答是否真的縮短查找時間並降低人工確認負擔。