2026.10.16
RAG檢索優化實戰:讓企業問答更準確可信
AI資訊
RAG檢索優化的核心,不是讓模型「說得更多」,而是讓它在回答前找到正確、完整且有權限的證據。當企業使用者問到最新流程、合約條款或產品例外規則,若系統只靠相似度抓到片段文字,即使生成語氣流暢,也可能把過期版本、不同部門規範或不適用條件混在一起,直接影響使用信任。
RAG 技術由檢索器(retriever)和生成器(generator)兩個部分組成,RAG這一術語最早出現於2020年發表的一篇研究論文。它的價值在於把外部資料帶入回答脈絡,但效果取決於資料清洗、切分、召回、排序、權限與引用是否形成閉環;因此,單純換更大的 LLM,往往無法修復檢索錯誤。
本文以企業上線情境為主軸,依序說明如何建立可評估的企業知識庫、選擇向量資料庫與混合檢索、落實 RAG重新排序,再延伸到知識圖譜RAG、Agentic RAG 與 LLM幻覺治理。最後也會提供小規模 PoC 的驗證方法,協助團隊先以真實資料取得 Go/No-Go 的決策證據。
RAG檢索優化先從可量測的檢索鏈路開始
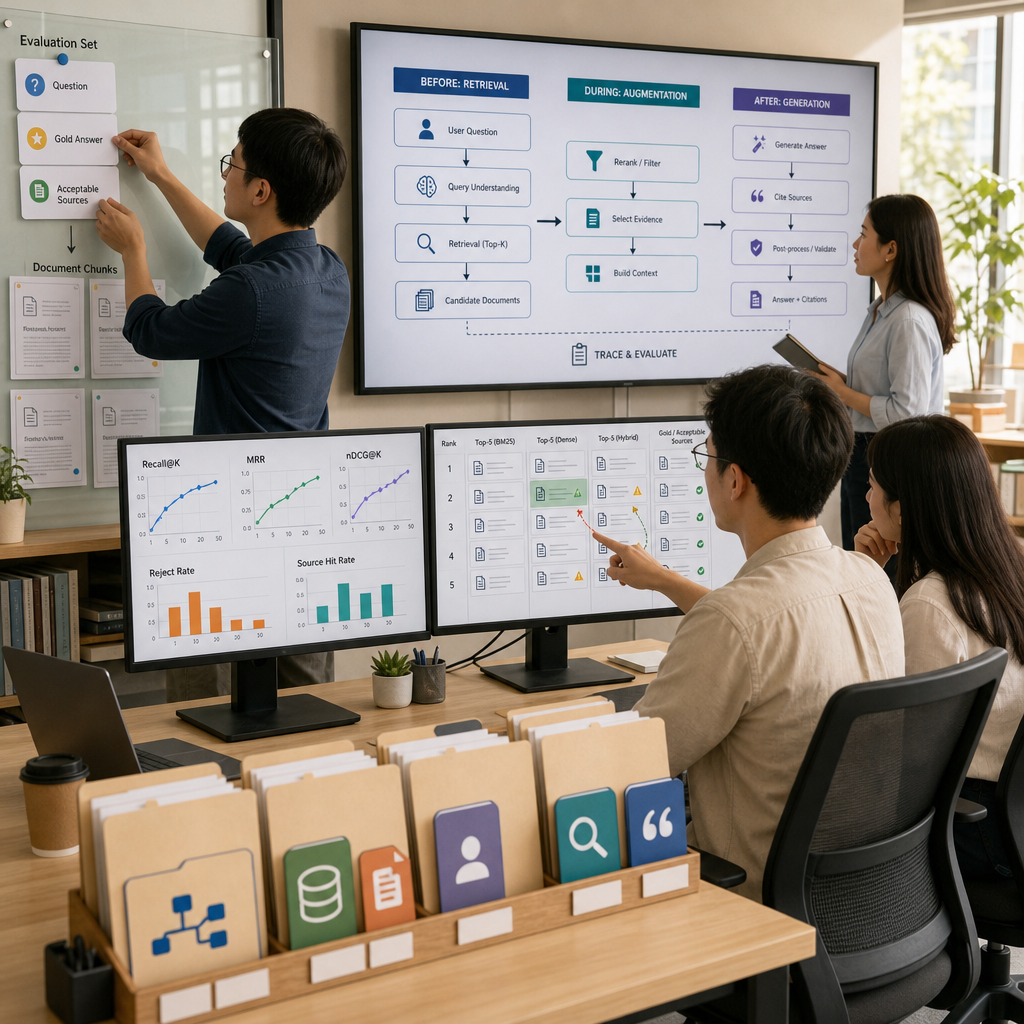
先拆解檢索前、檢索中與檢索後的失準點
直接答案是:先定位錯誤發生在哪一層,再決定是否加模型。RAG檢索優化可分成檢索前的文件清洗與查詢改寫、檢索中的召回與權限過濾,以及檢索後的重排、去重、上下文壓縮與引用組裝。若沒有這種分層觀點,團隊容易把答案錯誤一律歸因於 LLM,造成成本增加卻沒有改善。
實務上,先建立一組「問題、標準答案、可接受來源」的評測集,並分別觀察 Recall@K、MRR、nDCG、拒答率與來源命中率。Recall@K 用來確認正確證據是否進入候選集;MRR 與 nDCG 則反映它是否排在前面。生成層再檢查答案是否只根據來源回答,而不是只看文字是否通順。
檢索鏈路還應記錄查詢版本、索引版本、文件版本、使用者身分、候選文件與最終引用。這些紀錄能讓工程與業務人員回查「為何系統這樣答」,也能快速找出新舊文件衝突、權限誤放或特定部門語料不足的問題。沒有可追溯性,就很難把一次失答轉化為可重複的改進。
- 檢索前:清洗、切分、嵌入、查詢改寫
- 檢索中:混合召回、過濾、查詢路由
- 檢索後:Rerank、去重、壓縮、引用與拒答
文件分塊要保留語意邊界與業務脈絡
直接答案是:以文件結構切分優先於固定字數切分。合約、作業手冊與規章常有章節、標題、表格、附註與例外條件;若把它們硬切成等長文字塊,問題中的條件可能與答案分離。建議先辨識標題階層、段落、表格列與頁碼,再把父標題、文件版本與適用範圍附在每個 chunk 的中繼資料。
可將初始設定視為實驗基線,例如 chunk_size=512、overlap=64,或針對長篇內容採用重叠50个字的策略;但這些不是通用最佳值。繁體中文的標點、專有名詞與表格欄位,通常更需要依語意段落驗證。若問題必須理解前提,取回命中的段落後可補上前面的3句话 和后面的3句话。
PDF 與掃描文件尤其要先確認 OCR 品質、頁首頁尾雜訊、跨頁表格及條列縮排。若把頁碼、保密標記或重複頁首當成正文,向量相似度會被污染。切分完成後,應以真實問題抽查每一塊能否單獨說明規則;不能獨立理解的片段,即使被召回,也不適合直接交給模型生成。
- 將父標題、文件版本、部門與生效範圍寫入 metadata
- 表格應保留欄名與列標籤,不宜只擷取儲存格文字
- 以人工標註問題驗證 chunk 是否能提供完整證據
查詢增強應解決歧義,而不是無限制擴寫
直接答案是:查詢改寫要有明確目的與可回退機制。使用者常用口語、縮寫或只描述情境,例如「這種狀況能退嗎」;系統需要補足產品、地區、身分與時間條件。可依意圖選擇 Query Rewrite、Multi-Query、HyDE、Step-Back 或子問題生成,但每多一條查詢都會增加延遲、向量搜尋與後段重排成本。
對多義問題,可生成五個不同版本的问题,分別保留原始字詞、同義字、正式制度名稱與較高層次概念,再以融合排名合併結果。這比只依賴單一改寫更能避免改寫器錯把使用者意圖帶偏。不過原始問題必須保留並具較高權重,否則系統會因自動補充的假設而失去可解釋性。
查詢路由也值得納入設計:明確的制度名稱可先走關鍵字與 metadata 過濾;探索性問題可走語意檢索;需要比較多份政策時,才啟動多查詢或後續 Agent。透過這種分流,RAG檢索優化不必讓每一題都走最昂貴的流程,且能在高風險問題上保留更完整的審計足跡。
- 保留原始查詢,避免改寫覆蓋真實意圖
- 為改寫設定數量上限、逾時與失敗回退
- 依意圖選擇關鍵字、語意或多跳檢索
RAG 技術的召回設計:混合搜尋與向量資料庫
混合檢索可同時處理語意、術語與條件
直接答案是:企業文件不應只靠向量相似度搜尋。稠密向量擅長理解「出差費怎麼報」與「差旅核銷規則」的語意接近;BM25、TF-IDF 與關鍵字搜尋則更擅長精準命中料號、法條、錯誤碼、合約編號。混合檢索將兩者候選集合併,再用加權或 Reciprocal Rank Fusion 排名,通常更符合企業問答的真實語料。
在RAG 技術架構中,metadata 過濾與文字召回同樣重要。使用者部門、租戶、產品線、語言、文件生效日與機密等級應先縮小可檢索範圍,再計算語意相似度。這能同時改善答案精準度與資料安全,尤其對「最新版本」「僅限某地區」這類問題,過濾條件往往比嵌入距離更有判別力。
外部資料常以「答案品質的準確度提升了77.6%」描述 RAG 帶來的成效,但這類數字不能直接套用到任一企業。正確做法是以自家問題集做消融實驗:固定生成模型與評測集,依序比較純 BM25、純向量、混合搜尋及加入重排後的結果,才能確認增益究竟來自哪個環節。
| 方法 | 擅長內容 | 主要限制 | 適用情境 |
|---|---|---|---|
| BM25/關鍵字 | 料號、法條、錯誤碼 | 同義字較弱 | 制度名稱明確的查詢 |
| 向量檢索 | 語意相近問法 | 精確字詞較弱 | 自然語言問答 |
| 混合檢索 | 語意與精確字詞 | 需校準融合規則 | 企業知識庫主流程 |
- 稠密向量:處理同義、語意與自然語言問題
- 稀疏檢索:處理精確術語、代碼與罕見字詞
- metadata:處理權限、版本、地區與產品範圍
向量資料庫的選擇要回到資料治理需求
直接答案是:向量資料庫的差異不只在搜尋速度,更在過濾、更新、備份與維運能力。FAISS 適合本地實驗與高度客製的索引控制;pgvector 適合既有 PostgreSQL 團隊與關聯資料整合;Milvus 則常用於較大規模的向量服務。無論選擇何者,都必須驗證 HNSW 索引參數、過濾條件與高併發下的延遲分位數。
企業上線時,索引版本化不可省略。文件更新、撤銷或權限改變後,系統應能標記舊 chunk、建立新索引並在切換前進行抽樣驗證。若只做新增、不處理刪除,舊版規章會長期與新版競爭,最後由模型任意選取,這是企業知識庫最常見也最難察覺的錯誤之一。
若團隊需要雲端實驗環境,可參考「運用價值 $300 美元的免費抵免額和 20 多項一律免費的產品,開始在 Google Cloud 建構產品與服務。」但免費額度只適合作為原型測試依據。正式選型仍要量測儲存量、向量維度、索引重建時間、查詢尖峰與跨區資料政策,避免 PoC 與上線成本落差過大。
- 把文件 ID、版本、有效日期與 ACL 寫入索引
- 定期測試 p50/p95/p99 延遲與篩選正確性
- 將刪除、權限異動與索引同步納入營運流程
嵌入模型應以領域問題集,而非排行榜定生死
直接答案是:選 embedding 模型要看「正確證據能否被召回」,不能只看通用榜單。MTEB/C-MTEB 可作為初步篩選,但繁體中文、公司縮寫、產品別名與表格欄位會明顯改變效果。應蒐集真實查詢、正確文件與困難負例,測量不同模型在 Recall@K、MRR、nDCG 與延遲上的差異。
進階情境可使用多向量表示與 ColBERT,讓查詢詞與文件詞保有較細粒度的交互比對。這對長文件、專業術語與一段中包含多個主題的內容特別有幫助,但索引大小與運算量也會提高。因此,先確認單向量模型加混合搜尋是否已滿足目標,再考慮更複雜的表示法。
公開範例中的嵌入數值,例如「[-0.031262476, 0.0077232053, -0.06657475, 0.009407192, ……]」,只能說明文字會被編碼成向量,不能代表任何語意品質。另一組「[-0.036425743, 0.011724075, -0.044000726,0.037245207, ……]」與「[-0.045602992, 0.0049413736, -0.05299673,0.027971352, ……]」也必須搭配標註資料評估,才有業務意義。
- 用領域問題集比較,而非只看通用 benchmark
- 以困難負例檢驗相近但不適用的條款
- 先驗證召回,再決定是否進行領域微調
RAG重新排序讓候選文件真正對準問題
兩階段檢索兼顧召回率與精準度
直接答案是:先用便宜的召回器找廣,再用精準模型排前面。第一階段可從向量與關鍵字各取候選,例如 Top50或Top100;第二階段的RAG重新排序再逐一比對問題與段落的關係,最後只將通常为 3 到 10 个的高品質內容送入 LLM。這能降低雜訊,也能減少長上下文造成的注意力分散。
Cross-Encoder 類 reranker 會同時讀取 query 與 document,因此比單純向量距離更能辨識否定條件、數字門檻與例外條款。BAAI/bge-reranker-base 是常見的本地化起點;雲端服務則可依語言、資料駐留與併發需求評估。關鍵是先固定候選集,才能公平比較排序器是否真的改善 MRR 與 nDCG。
排序結果不應直接覆蓋來源治理。即使某段相似度很高,若文件已失效、使用者無權限或內容與最新政策衝突,也必須在 rerank 前後被排除。好的流程會把相關性分數、文件新鮮度、權限與來源可信度分開記錄,避免單一分數掩蓋企業規則。
- 第一階段優先追求 Recall@K
- 第二階段優先追求 MRR、nDCG 與可引用性
- 權限與版本規則不得交由 reranker 自行判斷
候選數量與上下文長度必須一起算成本
直接答案是:不是送進 LLM 的資料越多越好。模型上下文通常在4K到128K个令牌之间,但內容放得下不代表模型能平均注意每一段;大量不相關文字還會放大 Lost in the Middle 問題。候選數、rerank 數與最終上下文數應以檢索品質、p95 延遲與每次查詢成本共同決定。
成本差異相當明顯:Llama 3.1 8B 模型处理五个数据块并生成答案的成本约高出 75 倍。這提醒團隊先用重排、去重與壓縮減少上下文,再考慮擴大模型或視窗。對需要保留完整證據的法律、財務流程,也可採「摘要+原文引用」方式,讓模型先讀濃縮內容,再讓使用者展開查驗原文。
硬體與服務選型也要以量測為準。NVIDIA NeMo Retriever 重排序 NIM 微服务的基准测试表明,显著节省了 21.54% 的成本,但企業仍需以自己的語料、批次大小及併發量重測。若選擇 Llama 3.1 70B 或 gemini-2.0-flash 做排序或判斷,也應設計逾時降級到較快的 reranker。
- 記錄候選數、重排數、最終 chunk 數與 token 數
- 以 p95 延遲和每問成本設定服務等級目標
- 高風險題目可升級流程,低風險題目採快速路徑
重排後仍要去重、壓縮與驗證引用
直接答案是:重排不是最後一步。候選段落常來自同一份文件或內容高度重複,若全部送入模型,會浪費 token 並放大單一來源偏誤。可依文件 ID、段落重疊率與語意相似度去重,再保留不同來源、不同觀點或不同規則層級的證據,使答案能說明一般原則與例外條件。
上下文壓縮應保留支撐答案的主詞、條件、數字、適用範圍與原文位置,而不是只抽取看似相關的句子。系統生成後,還應做引用一致性檢查:每個關鍵主張是否能指向來源、來源是否真的支持該主張、是否遺漏限制條件。無法支撐時,應改為拒答或要求補充資訊。
技術文件的版本資訊同樣必須被保存。例如某項服務頁面標示「最后更新时间 (UTC):2026-09-27。」,這類時間標記可協助判斷來源新鮮度,但不能取代企業正式的生效日期欄位。對制度型知識,應以發布者、版本號、核准狀態與生效範圍作為最終依據。
- 以文件層級與段落層級雙重去重
- 壓縮時不可刪除適用條件與例外規則
- 答案必須能回連原始段落與文件版本
知識圖譜RAG與Agentic RAG處理複雜問題
知識圖譜RAG適合多跳關係與全局問題
直接答案是:當答案依賴「實體之間的關係」時,知識圖譜RAG 比單段向量搜尋更合適。例如使用者問某產品在某地區、某合約方案與某例外條款下可否退費,系統需要跨越產品、地區、角色與政策節點。圖譜可把這些實體、關係、來源與版本明確建模,再與文字段落共同檢索。
導入時不必急著把所有文件轉成完整圖譜。可先從高價值實體開始,例如產品、制度、部門、流程角色、客戶方案與文件版本,並讓每條關係保留來源文件與建立時間。這樣,圖譜不是另一份無法驗證的資料,而是可追溯的索引層,可協助文字檢索找到應補足的上下文。
外部比較曾指出,GraphRAG與基於SQL資料庫的 LLM相比,回答的準確性高出3倍以上;但這是特定評測與實作條件下的結果。企業不能直接承諾相同幅度,而應針對多跳問題、跨文件比較與全局摘要建立子測試集,確認圖譜建置成本是否換來可量化的答案改善。
- 圖譜節點要有來源、版本與擁有者
- 優先處理跨文件、多條件與多跳問題
- 圖譜檢索結果仍須回到原文引用驗證
Agentic RAG應用於需要規劃與工具協作的任務
直接答案是:Agentic RAG 不適合取代所有一般問答,而適合需要拆題、反覆檢索、呼叫工具與檢查證據的任務。例如「比較三個方案的資格、費率與限制」,Agent 可以先產生子問題,分別檢索,再檢查是否缺少有效日期或地區條件,最後彙整為有來源的答案。
為避免 Agent 無限制循環,必須預先設定工具白名單、最大步數、可存取資料範圍、預算與停止條件。每一步都要記錄它查了什麼、為何再查、使用哪個來源以及是否完成;若在限制內找不到足夠證據,就應輸出「資料不足」而非自行推論。這是把自主性維持在可控範圍的關鍵。
在企業流程中,Agentic RAG 也可搭配 SQL、工單系統與文件庫,但即時系統資料和靜態政策要區隔處理。查詢庫存、訂單或客戶資料時,應使用權限控管的工具呼叫;解釋規則時,應引用企業知識庫文件。兩種資料混合生成前,還要確認時間點一致,避免舊規則解釋新交易。
- 限定 Agent 可用工具、步數、token 與時間
- 將規劃軌跡與證據軌跡分開保存
- 無足夠證據時要停止並明確拒答
複雜架構應以路由而非全量啟動控制成本
直接答案是:用查詢複雜度決定是否啟動圖譜或 Agent。簡單的「某文件在哪裡」可使用關鍵字檢索;語意問答走混合檢索加 rerank;需要跨實體推理才升級知識圖譜RAG;涉及多來源比較、外部工具或多步驗證時,再交由 Agentic RAG。這種路由方式能讓資源花在真正需要的題目上。
路由器可使用規則與小型分類器的組合。規則判斷是否包含明確實體、時間範圍、比較詞或工具需求;分類器則辨識語意上的複雜度。每個路由決策都應回寫評測資料,定期檢查是否把高風險問題誤送到快速路徑,或把簡單問題送往昂貴流程。
架構演進時,最重要的是保留模組化介面。檢索器、圖譜查詢、重排器、壓縮器與生成器都應能替換並獨立評估。這讓團隊能在同一資料集上做端到端消融,量化分塊、查詢改寫、混合檢索、RAG重新排序與圖譜各自的效果,而不是只能憑使用者印象做決策。
- 快速路徑:明確術語或單文件問題
- 標準路徑:混合召回、重排與引用
- 進階路徑:多跳圖譜、工具調用與多步驗證
企業知識庫與LLM幻覺治理的上線方法
企業知識庫必須把權限與版本放在生成之前
直接答案是:企業知識庫不是把檔案丟進向量資料庫就完成。文件進入索引前,要確認擁有者、機密等級、角色權限、保留期限、版本、生效日期與撤銷狀態;查詢時則依使用者身分套用 ACL 過濾。若先把機密段落召回、再要求模型「不要透露」,資料其實已進入不該存取的處理鏈路。
版本衝突需要明確決策規則。例如新文件若標註取代舊版本,舊版應從預設檢索結果排除,僅在稽核或歷史查詢時可見;若兩份文件適用不同產品或地區,則不能只依發布時間決定。每一份資料都應有能被業務單位理解的狀態,而非只靠工程團隊維護隱性標籤。
某些技術資料會列出「CN118467681B | CN202410909730.7A | 2024-07-09 | 2024-08-09 | 2024-09-24 | 20个词汇 | 0.85 | 8 | Active | Jinxiandai Information Industry Co ltd | CN118467681A | CN118467681B」。這類識別資訊提醒我們:專利、規章與產品資料都有版本和狀態,檢索時必須把這些欄位當成可過濾的結構化資料。
- ACL 應在召回前套用,而非生成後遮罩
- 建立文件取代、撤銷、歸檔與例外存取流程
- 讓業務擁有者能核准內容與版本狀態
LLM幻覺治理要結合證據門檻與拒答設計
直接答案是:降低幻覺的有效方法,是讓模型只能在足夠證據下回答。LLM幻覺治理應設定來源門檻,例如至少有一段直接支持關鍵結論、所有數字與限制條件均可回連來源、候選文件彼此矛盾時優先提示衝突而不是強行整合。這些規則比單一句「請勿編造」更可測量。
系統應區分不知道、找不到、沒有權限與問題不完整四種情況。找不到資料時,可建議使用者補上產品、地區或時間;無權限時,應提示申請管道但不可揭露內容;文件衝突時,應列出版本與適用範圍;高風險決策則應把回答定位為資訊輔助,交由指定人員覆核。
資料投毒與過期來源也是治理範圍。上傳文件前應進行來源驗證、惡意提示文字偵測與內容審核;上線後持續監控異常高的拒答率、引用缺失率與特定文件被過度引用的情況。LLM幻覺治理不是一次性提示調整,而是資料、檢索、生成與人工回饋共同構成的控制循環。
- 答案中的主張、數字與限制皆需有來源
- 把拒答原因分類,才能改善對應環節
- 高風險領域保留人工覆核與稽核紀錄
以真實資料 PoC 證明效益後再擴大投資
直接答案是:先用小範圍 PoC 驗證可行性、使用性與效益,再決定正式開發。ALION 的做法是從現場調查與訪談開始,先定義 KPI、資料範圍、驗證題目與不做事項,再以貼近實際環境的原型測試。這能避免需求模糊時就投入完整平台,最後才發現資料品質、權限或使用流程不成立。
PoC 的 KPI 不應只看模型回答漂亮與否,而要同時記錄證據命中率、正確引用率、任務完成時間、人工查找時間、p95 延遲、每次查詢成本及現場採用回饋。若原型未達門檻,也應能指出是資料缺口、檢索設計、流程設計或問題本身不適合 RAG,讓「現在不做」成為有價值的投資判斷。
ALION 的 AI 上游工程訂閱服務標示月費 20 萬日圓起;相較於聘僱 CTO 級人才月薪 80〜150 萬日圓,或外包開發啟動費約 300 萬日圓起,小規模驗證可先降低決策風險。若進入正式開發,以 1,000 萬日圓規模的開發案而言,上游工程約需 3 個月(約 60 萬日圓),相關費用可自正式開發預算中扣抵。
| 步驟 | 要做什麼 | 關鍵產出 |
|---|---|---|
| 設定 KPI | 訪談與現場調查 | 成功門檻與評測題組 |
| 確認範圍 | 資料、權限、技術盤點 | 架構與時程 |
| 原型實證 | 檢索、重排、回答測試 | 品質與使用回饋 |
| 投資判斷 | 效益與成本分析 | Go/No-Go 報告 |
- 先以真實問題、真實文件與真實權限驗證
- PoC 交付物應可延續到正式索引、評測與架構
- 以 Go/No-Go 報告連結技術品質與商業效益
總結
RAG檢索優化的關鍵在於把「找到資料」升級為「找到正確、可用、可引用且有權限的證據」。從結構化分塊、混合檢索與向量資料庫治理,到 RAG重新排序、知識圖譜RAG、Agentic RAG 與 LLM幻覺治理,每一層都應以同一份真實問題集量測效果,而非只依賴模型展示。
重點整理
- 先量測 Recall@K、MRR、nDCG 與引用正確性,再調整模型與提示。
- 混合檢索加上 metadata 權限過濾,是企業知識庫的穩健起點。
- RAG重新排序可減少雜訊與 token 成本,但不能取代版本與 ACL 規則。
- 知識圖譜RAG及 Agentic RAG 應由複雜度路由觸發,不必套用到每一題。
- 以真實資料 PoC 驗證 KPI、成本與現場採用,再擴大正式投資。
若團隊已經有文件與問答需求,建議先挑選高頻、可驗證且具明確業務價值的情境,建立小型評測集與可追溯原型。透過現場調查、資料盤點與 PoC,能更快判斷應優先改善文件、檢索、排序或流程,並把可用的設計與程式資產延續到正式系統。
常見問題 FAQ
Q1. RAG檢索優化最先該做哪一件事?
先建立含有問題、正確來源與判定規則的小型評測集。先確認正確文件是否被召回,再依序改善切分、混合檢索、重排與生成;直接更換 LLM 通常無法定位真正瓶頸。
Q2. 向量資料庫可以完全取代關鍵字搜尋嗎?
不建議。向量搜尋擅長語意相近問題,但料號、版本號、法條、錯誤碼與罕見術語通常需要 BM25 或關鍵字搜尋補強。企業情境多半適合採混合檢索。
Q3. 什麼情況需要導入 RAG重新排序?
當正確文件能進入候選集,卻常排在後面,或送入 LLM 的內容雜訊太多時,就適合加入 reranker。先量測候選數、MRR、nDCG、p95 延遲與每問成本,再決定候選規模。
Q4. 知識圖譜RAG與 Agentic RAG 是否每個專案都需要?
不需要。單文件或明確制度問答通常以混合檢索與重排即可;只有跨文件、多實體、多條件推理或需呼叫工具的問題,才值得以圖譜或 Agent 處理。
Q5. 可以參考哪些可信來源建立 RAG 評測與架構?
可參考原始 RAG 論文 https://arxiv.org/abs/2005.11401、NIST TREC https://trec.nist.gov/、BEIR benchmark https://github.com/beir-cellar/beir、Google Cloud RAG 文件 https://cloud.google.com/vertex-ai/generative-ai/docs/rag-overview,以及 NVIDIA NeMo Retriever 文件 https://docs.nvidia.com/nim/ranking/latest/。